群里有人丢了条链接,HN 上一个帖子在涨赞。
9 月 15 号,TypeSafe 从两年隐身里冒出来。创始人 Diogo Almeida——ChatGPT 那套 RLHF 训练方法的共同发明人——在 X 上写了一句:Don’t chat. Decide.
三天。HN 1900 多赞,评论 500 多条。Doom 演示、国际象棋、工单分流、浏览器点菜单,推文一条接一条。Vercel 跟了接口,Cloudflare 也跟了。
我盯着屏幕想了一件事:这东西是不是决策树外加一个置信度模型?
打开官网,第一句话就是答案。
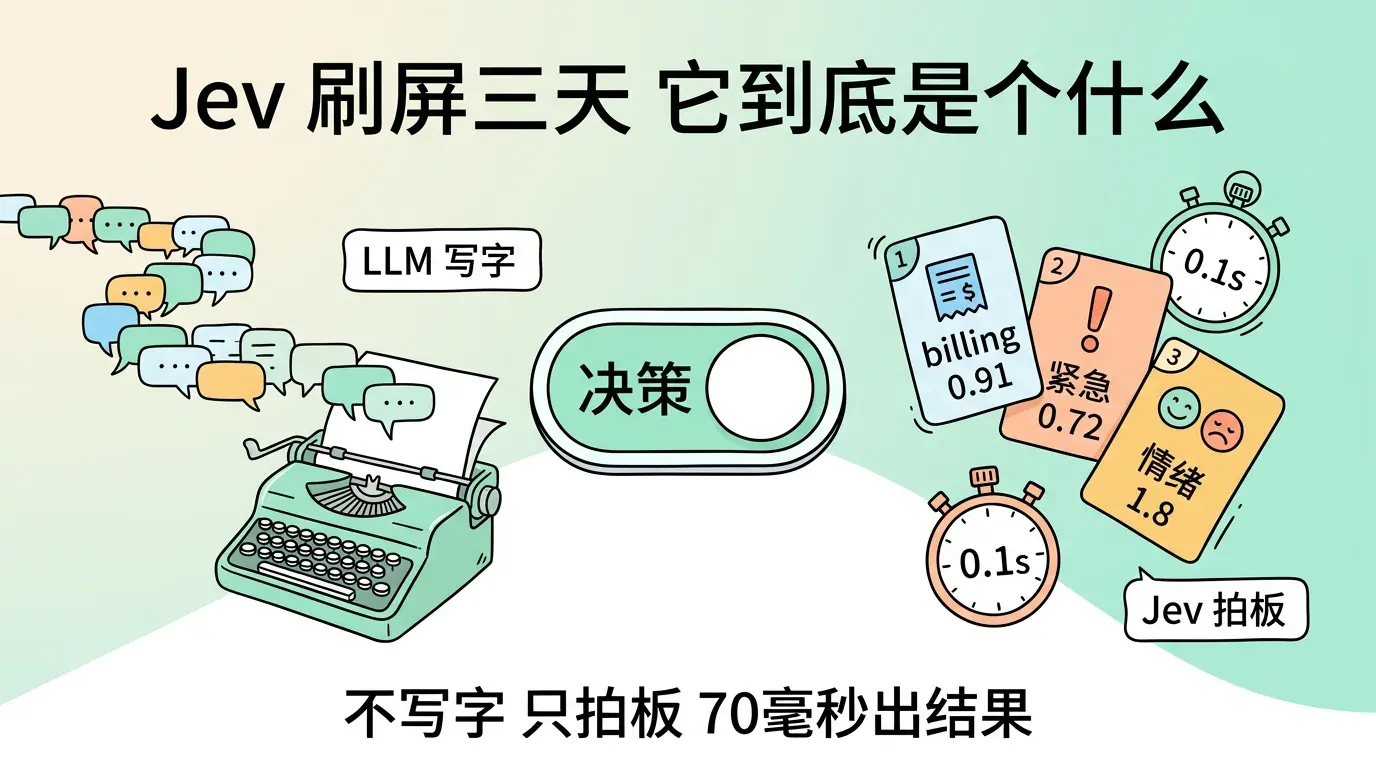
它不生成字。不写邮件,不写代码,不聊天。你丢一段状态进去——工单原文、一段 JSON、一条日志——它吐回类型安全的答案。走哪个队列,分数多少,是或否。每条带校准过的置信度。
端到端 70 到 500 毫秒。输入 $0.042 / 百万 token。输出免费。
API 字段 jev-latest,打 POST /v1/systemone。
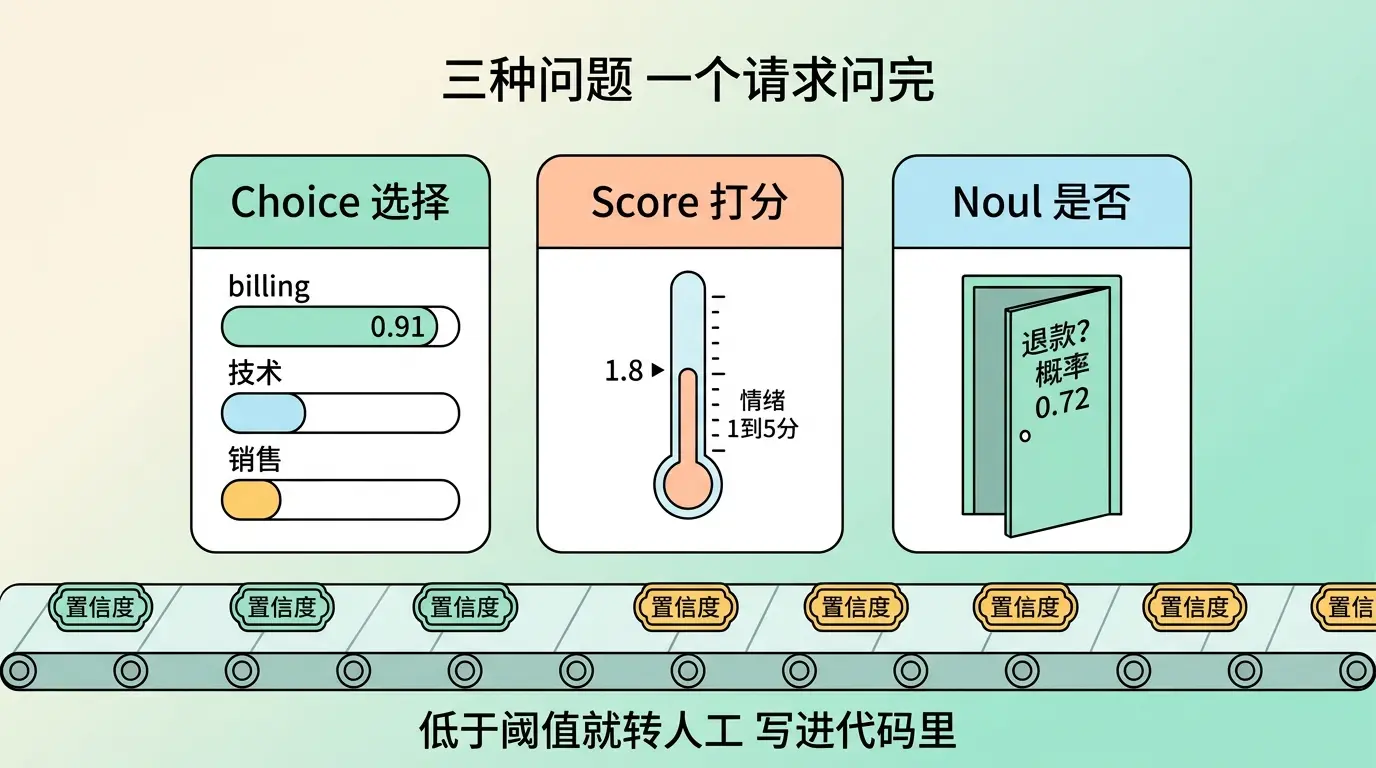
三种问题格式。Choice:最多 255 个选项里挑一个,给出整份概率分布。Score:给一个数值打分。Noul:是或否的概率——这词他们自己造的。一次请求可以塞一堆问题进去,并行跑。
拿客服工单举例:
state: "我的卡被扣了两次,同一笔订单。"
questions:
  - type: choice, key: department, options: [billing, technical, sales]
  - type: noul,   key: urgent
  - type: score,  key: sentiment, scale: [1, 5]
回来三份分布:billing 0.91、urgent 0.72、sentiment 1.8。各带一条置信度。没有一段可读的文字。代码拿到结果,一个 if 搞定分流。
他们叫这套 System One Model。名字来自卡尼曼《思考,快与慢》——系统 1 快,凭直觉拍板;系统 2 慢,走推理。LLM 干系统 2 的活,Jev 干系统 1 的活。
输出为什么免费?因为没有逐 token 的解码。LLM 一个字一个字往外吐,按 token 收钱。Jev 一次前向传播把所有问题的分布算完,没有字符串可以卖。速度和价格的来源是同一个:并行采样。
群里、HN 上反复有人提——
“分类、打分、路由,老问题了。”
“spaCy 能干。”
“我用向量相似度做类目路由,早跑在线上了。”
形状上,这些说法都对。活是同一类活。吃饭的方式不一样。
决策树要你先抠特征:金额、渠道、历史投诉次数、是不是老客。XGBoost 吃表格。业务翻译成列,树才能切。换一条规则,整棵树重训,特征工程从头来。
BERT 分类头往前走了一步,能吃文本。代价是每个业务场景自己标数据、自己训。客服队列从 8 个改成 12 个?分类头要换,样本要补,校准曲线要重画。置信度那一栏,很多模型写着 0.99,实际对的次数远不到 99%。
Jev 吃原文,或者一段程序状态。你把选项写在 schema 里,它吐分布。换业务?改选项。不用重训树,不用重新抠特征列。
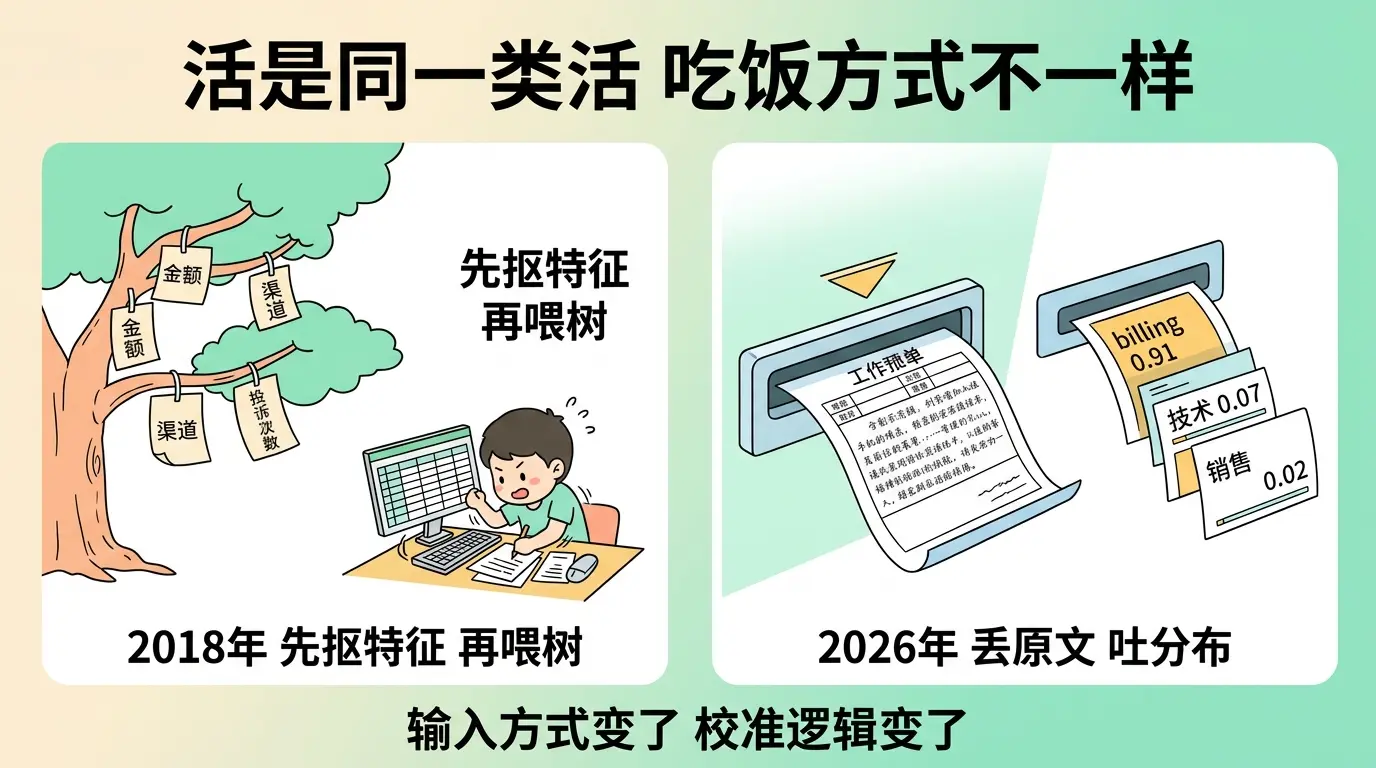
接的活,就是分类器那类活。吃饭的方式,跟 2018 年 Jupyter 里那棵树对不上。
你手上已经有一份干净的表格特征和一个训好的 XGBoost,继续用。便宜,本地跑,延迟比 70 毫秒还低。你面对的是工单原文、会话记录、Agent 轨迹——非结构化数据,每次先让 GPT 把字段抽出来再进树。那层抽字段的钱和延迟,才是账本上的洞。Jev 把这个洞补上了。
我以前做舆情监控,链路我熟。ES 倒排索引先捞候选文本——关键词命中、布尔检索,几百万条筛到几千条。然后抠特征:关键词频次、发布渠道、转发量、时间段、是不是大V,拼成一张表。表喂进分类树或 XGBoost,切出情感正负、话题归属、风险等级。类别多的时候精度掉,还得上 ECC(Error-Correcting Output Codes),把 N 个类拆成一组二分类器,用纠错码矩阵投票。
整条链路,特征工程占了一大半工时。换一个客户、换一套分类体系,特征列重新设计,树重新训,ECC 矩阵重新算。
拿 Jev 替掉中间那段,链路变成:ES 捞文本 → 原文丢给 Jev → 一个请求同时问情感(正/负/中)、话题(产品/服务/价格/其他)、风险等级(1-5)、是否需要人工介入 → 拿到带置信度的分布 → 低于阈值转人工。
特征工程省了。ECC 也不需要——Choice 原语天然支持 255 个选项的概率分布,不用拆成二分类器组合。换分类体系改 schema,不用重新建树。
倒排索引那一步 Jev 不碰。它接在检索之后、处理之前。位置清楚。
官网上写着 Zero Hallucinations。图上画了 LLM 的幻觉率,Jev 那一栏 0%。
HN 吵开了。
拆开看。它的输出空间锁死了——schema 里没有的字段,吐不出来。你定义了 billing / technical / sales 三个选项,它不可能返回一个 “customer_service”。类型错误在数学上不成立。0% 指的是这个。
选错呢?
Almeida 自己在帖子里认了:可以自信地给错答案,以后更强的模型也一样。
工单该去 billing,它给出 technical,置信度 0.91。字段合法,方向错了。你的代码照样执行分流——分到了错的队列。schema 安全,救不了判断错误。
这才是我要看的东西。他们用一套叫 RLCD 的训练方法——Reinforcement Learning for Calibrated Decisions。RLHF 让模型写出人喜欢的文字。RLCD 让概率说实话。模型说 70% 有把握,长期跑下来就该对大约 70%。
代码里就可以这么写:置信度低于 0.8,转人工,或者丢给 Astra 再判一次。文档里把这种写法叫 confidence-gated routing。
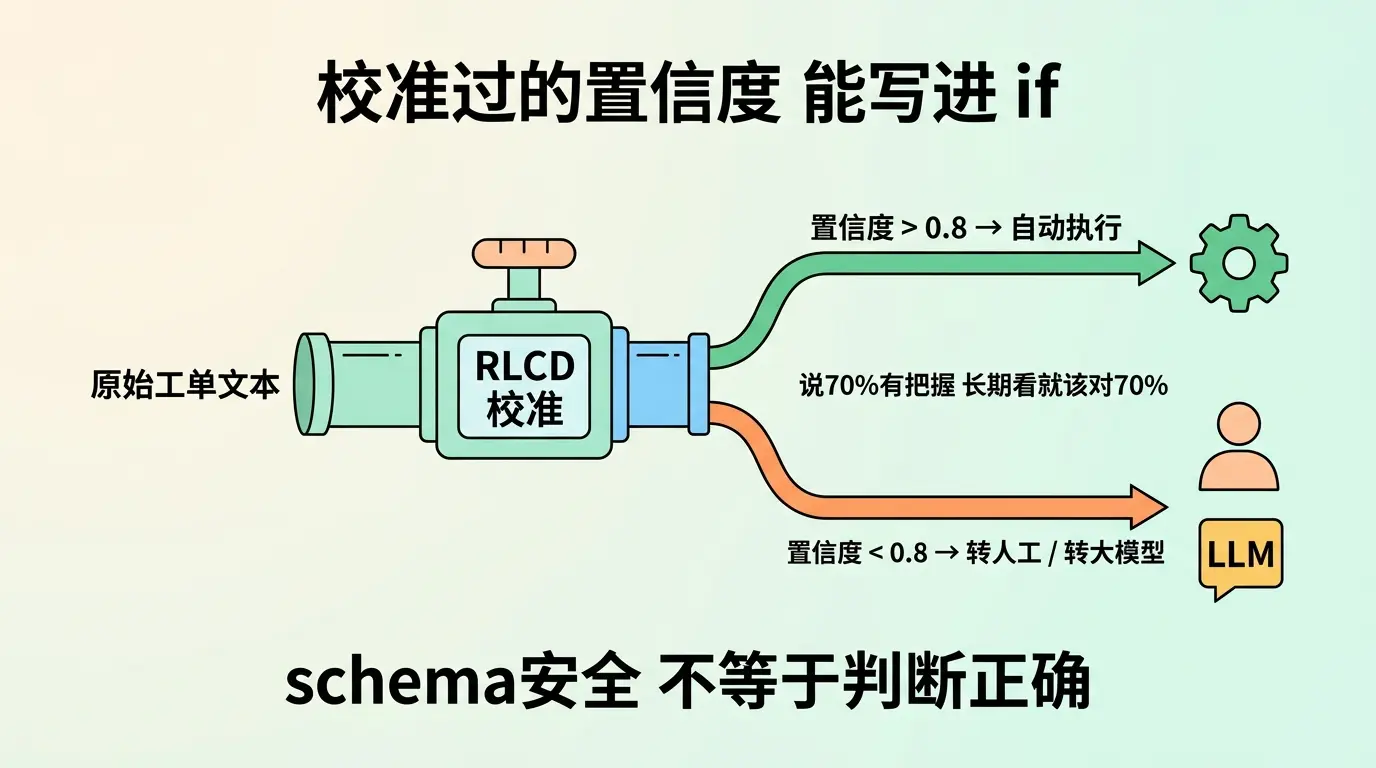
校准过的置信度,比”不会幻觉”四个字值钱。 后者是文案。前者能写进 if。
名字取自威廉·斯坦利·杰文斯。19 世纪那句话:蒸汽机更省煤了,煤的总消耗量反而上去了——更便宜的动力,解锁了以前划不来的用途。
他们的赌法写在明面上。决策成本降两个数量级,被自动化的决策就会多两个数量级。token 总量升,不降。
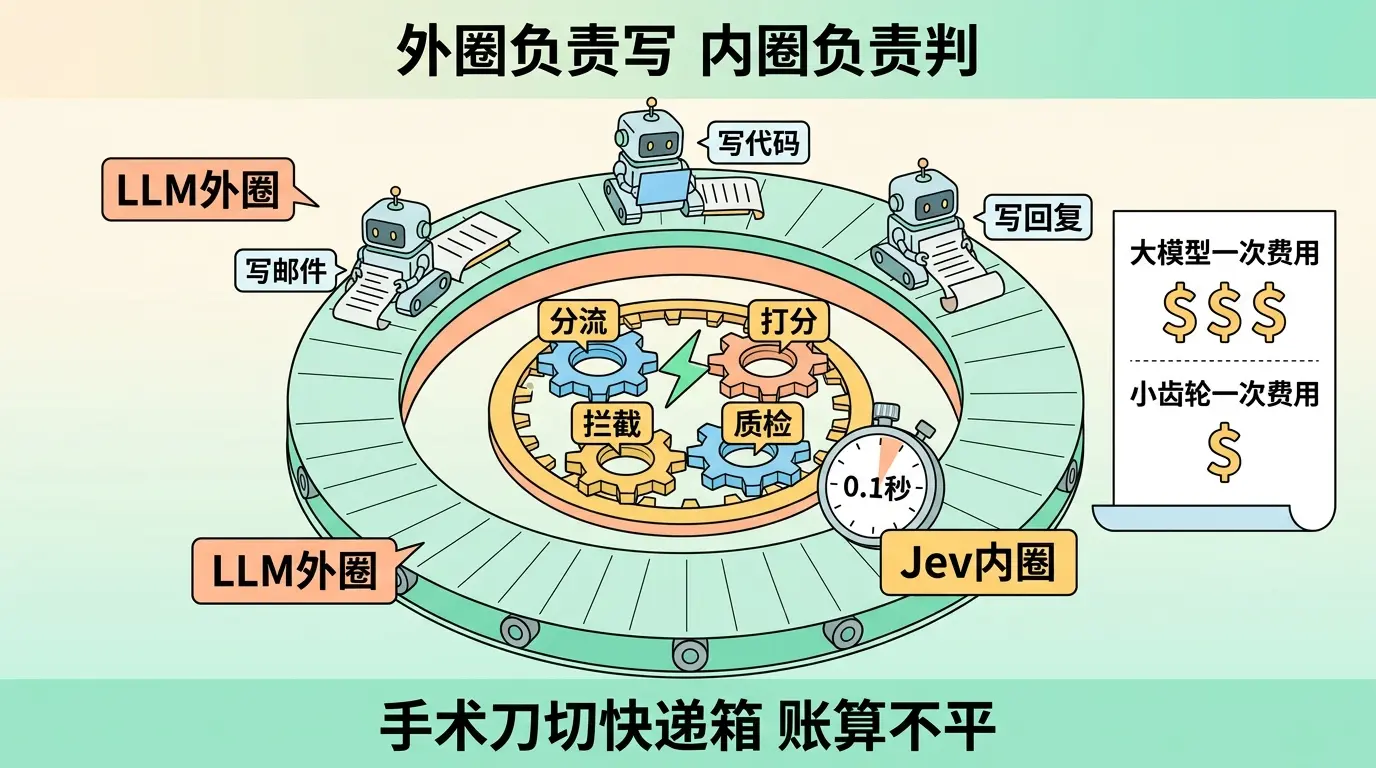
这跟我这周写号池、写 overloaded 是同一本账。算力紧的时候,你还拿 GPT-6 Astra 去判断一封邮件走哪个队列——手术刀开快递箱。Pro 号池被 cooldown 掐过一轮,API 按量贵。工单分流、内容质检、要不要拦,这类内环调用一天几万次,账拉不平。
Jev 把这块从聊天模型里拆出来了。LLM 继续写邮件、写代码、写回复。内环的分流、打分、拦截,走 70 毫秒的函数调用。官网那句 “frontier-intelligence function call”,说的就是这个位置。
他们自己的 workflow evals 报了 193.6 倍更快、444.6 倍更便宜。参考对象是 GPT-6 Astra 和 Fable 5.1 的平均。公开金标没交。数字当广告看。方向我认。
X 和 HN 上这几天的演示比官网动画好看。
有人拿 Jev 当浏览器 agent 的选菜单模型。辅助功能树里 10 到 40 个可点击项,每步让 Jev 挑一个。六张测评卡,21 到 23 步全对,总花费大约 0.001 美元。要填字的时候,再叫一个 nano 模型来写。有人做国际象棋,把所有合法走法塞进 Choice,一次前向选出黑棋下一步,大约 300 毫秒,每步 0.00004 美元。还有人估算,一条业务流水线里 40% 到 70% 的 LLM 调用,形状上就是选择题。
我对过自己的流量。Token Hub 里,”写”的请求没那么多。大量是:这条要不要拦、这个意图归哪类、这篇生成内容过不过质量线。过去全走大模型,再写一层 JSON 解析,解析失败了重试。Jev 的接口形状,就是把这层重试拿掉。
在 Zaokit.app 的 PPT 生成流程里,我碰到同样的问题。每一页 PPT 生成之后,要判断:排版合不合格、配色有没有撞、文字有没有溢出边框。过去用 GPT 写一段 JSON 回来做质检,偶尔格式崩了要重试。换成 Jev 这种接口——丢一段页面状态,Score 问排版分,Noul 问是否合格,Choice 问哪种修正方案——一个请求搞定,不用解析字符串。
你的数字分身 那边也一样。用户发一条消息进来,先判意图:是要问答、要生成、要改稿、还是闲聊?过去用 GPT 做意图识别,一条请求 1-2 秒,偶尔跑偏。如果有一个 70 毫秒的 Choice 接口把意图先分好,GPT 只接收到明确的任务指令——效率翻一倍都不止。
边界也清楚。32K 上下文。不吃图。Choice 上限 255 个选项,再多要拆成两段打分再选。Early access,还在排队。Doom 演示吃的是结构化游戏状态——坐标、距离、角度写成 JSON,不是像素。HN 有人说 launch 文案像在演戏:frontier、can’t hallucinate、两年隐身,词用得满。
这些我都记下了。不妨碍我认一件事:把”决策”从”生成”里拆出来,方向对。 过去三年大家拿 GPT 当锤子,钉子的形状其实早就分好了。
做企业落地,踩过的坑多半出在内环。审批摘要之后要不要升级、客服会话要不要转人、生成的 PPT 页过不过质量线。这些调用要稳,要快,账还得拉得平。聊天模型能干,贵,偶尔解析失败。
我现在的做法:Token Hub 做多模型路由,GPT、GLM、Kimi 按场景切换。Jev 这类模型如果 early access 排到了,我会把它当路由前面的一层——置信度高的决策本地消化,低的再丢给大模型。两层叠起来,内环快,外环准,账才算得过来。
grok.zaokit.com、cx.zaokit.com、cc.zaokit.com 这几条企业线,跑的就是这套逻辑。模型是工具,合适的那把才留下。
我一个人打造的 Zaokit AI Agent 交易平台,以及 AI PPT / 图文创作 Zaokit.app、你的数字分身,助力大家高效完成图文创作和 PPT 生成。唯一网站:https://zaokit.app。
企业侧同一逻辑,已经融进可直接接入的服务:
稳定靠谱的 AI 全家桶,开箱即用。
如果你认可 Zaokit AI 的产品理念,欢迎后台留言加入社群。我们不卖课、不割韭菜,只聚焦 ToB 企业场景的 AI 落地实战。
延伸:周五晚上 GPT 解冻了,我在想这 10 几个 Pro 还要不要续 · GPT 订阅号池服务,可以写入历史了 · server_is_overloaded 的最新解决方案
| 唯一网站:Zaokit.app | Agent 交易平台:Zaokit.ai |
企业 Grok 服务:grok.zaokit.com
企业服务:cowork.zaokit.app · cx.zaokit.com · cc.zaokit.com · tokenhub.zaokit.ai · gift.junxinzhang.com · 完整产品列表
稳定靠谱的 AI 全家桶,开箱即用。
我是 Jason,自己一个人做 AI 产品。Jev 刷了三天屏。它不聊天,连字都不吐。我在意的是:那些一天要拍几万次板的内环,以后还要不要排 LLM 的队。