大家好,我是 Jason。
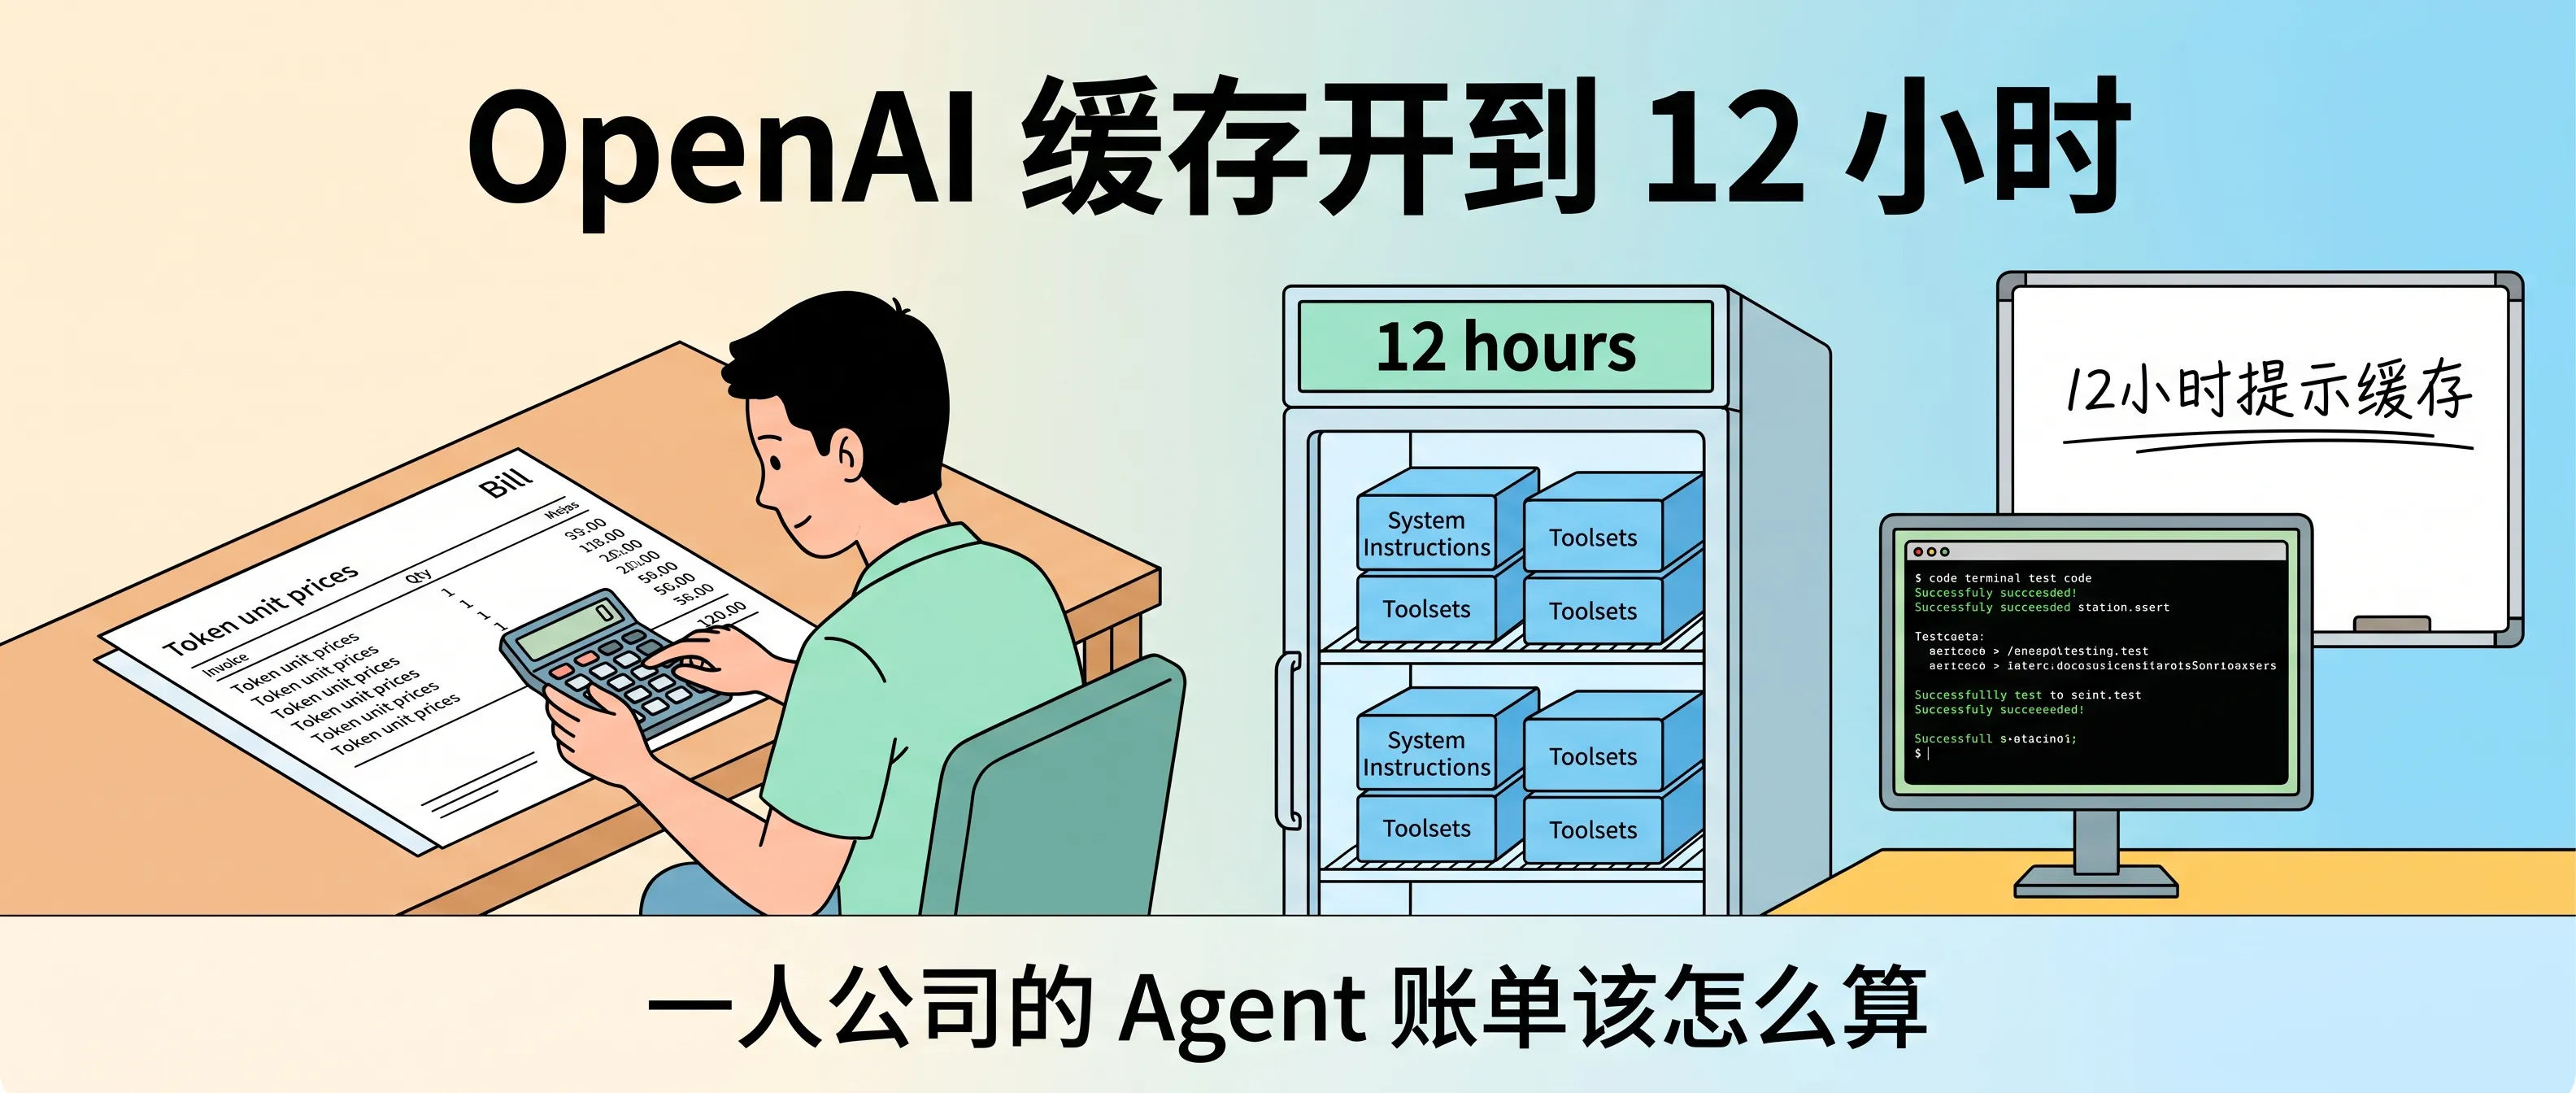
OpenAI 开发者账号发帖:API 上线 12 小时提示缓存。
OpenAI 缓存降价,帖子引来 108.8 万次浏览。
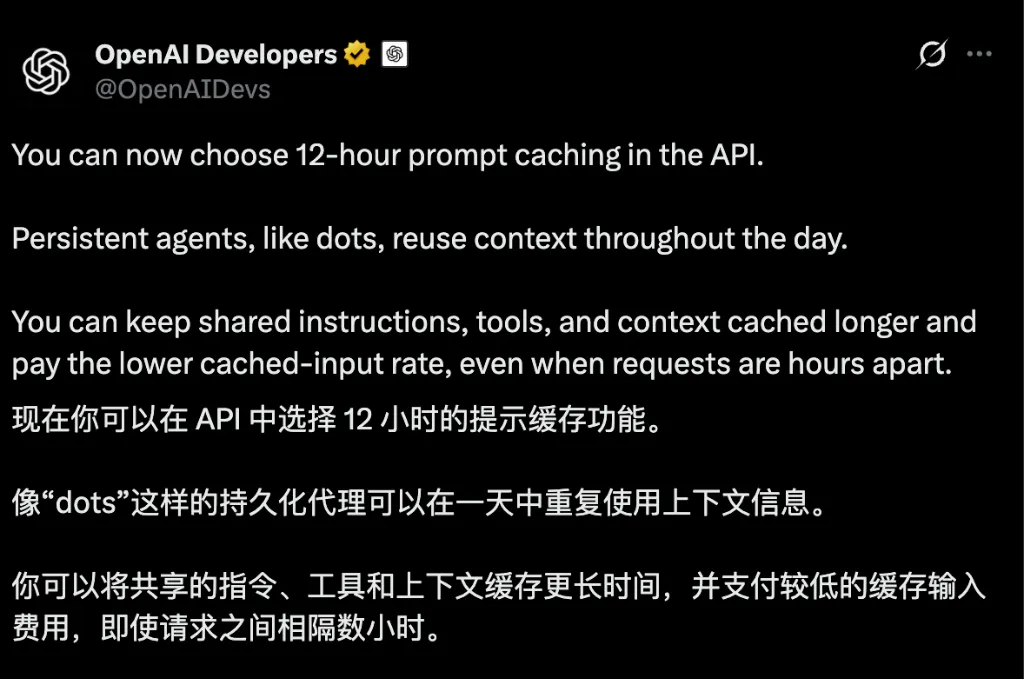
官方点名持久化代理 dots。接口提供两种寿命:保留默认 30 分钟,或者选择 12 小时。即使调用间隔数小时,依然可以享受低价缓存输入费率。
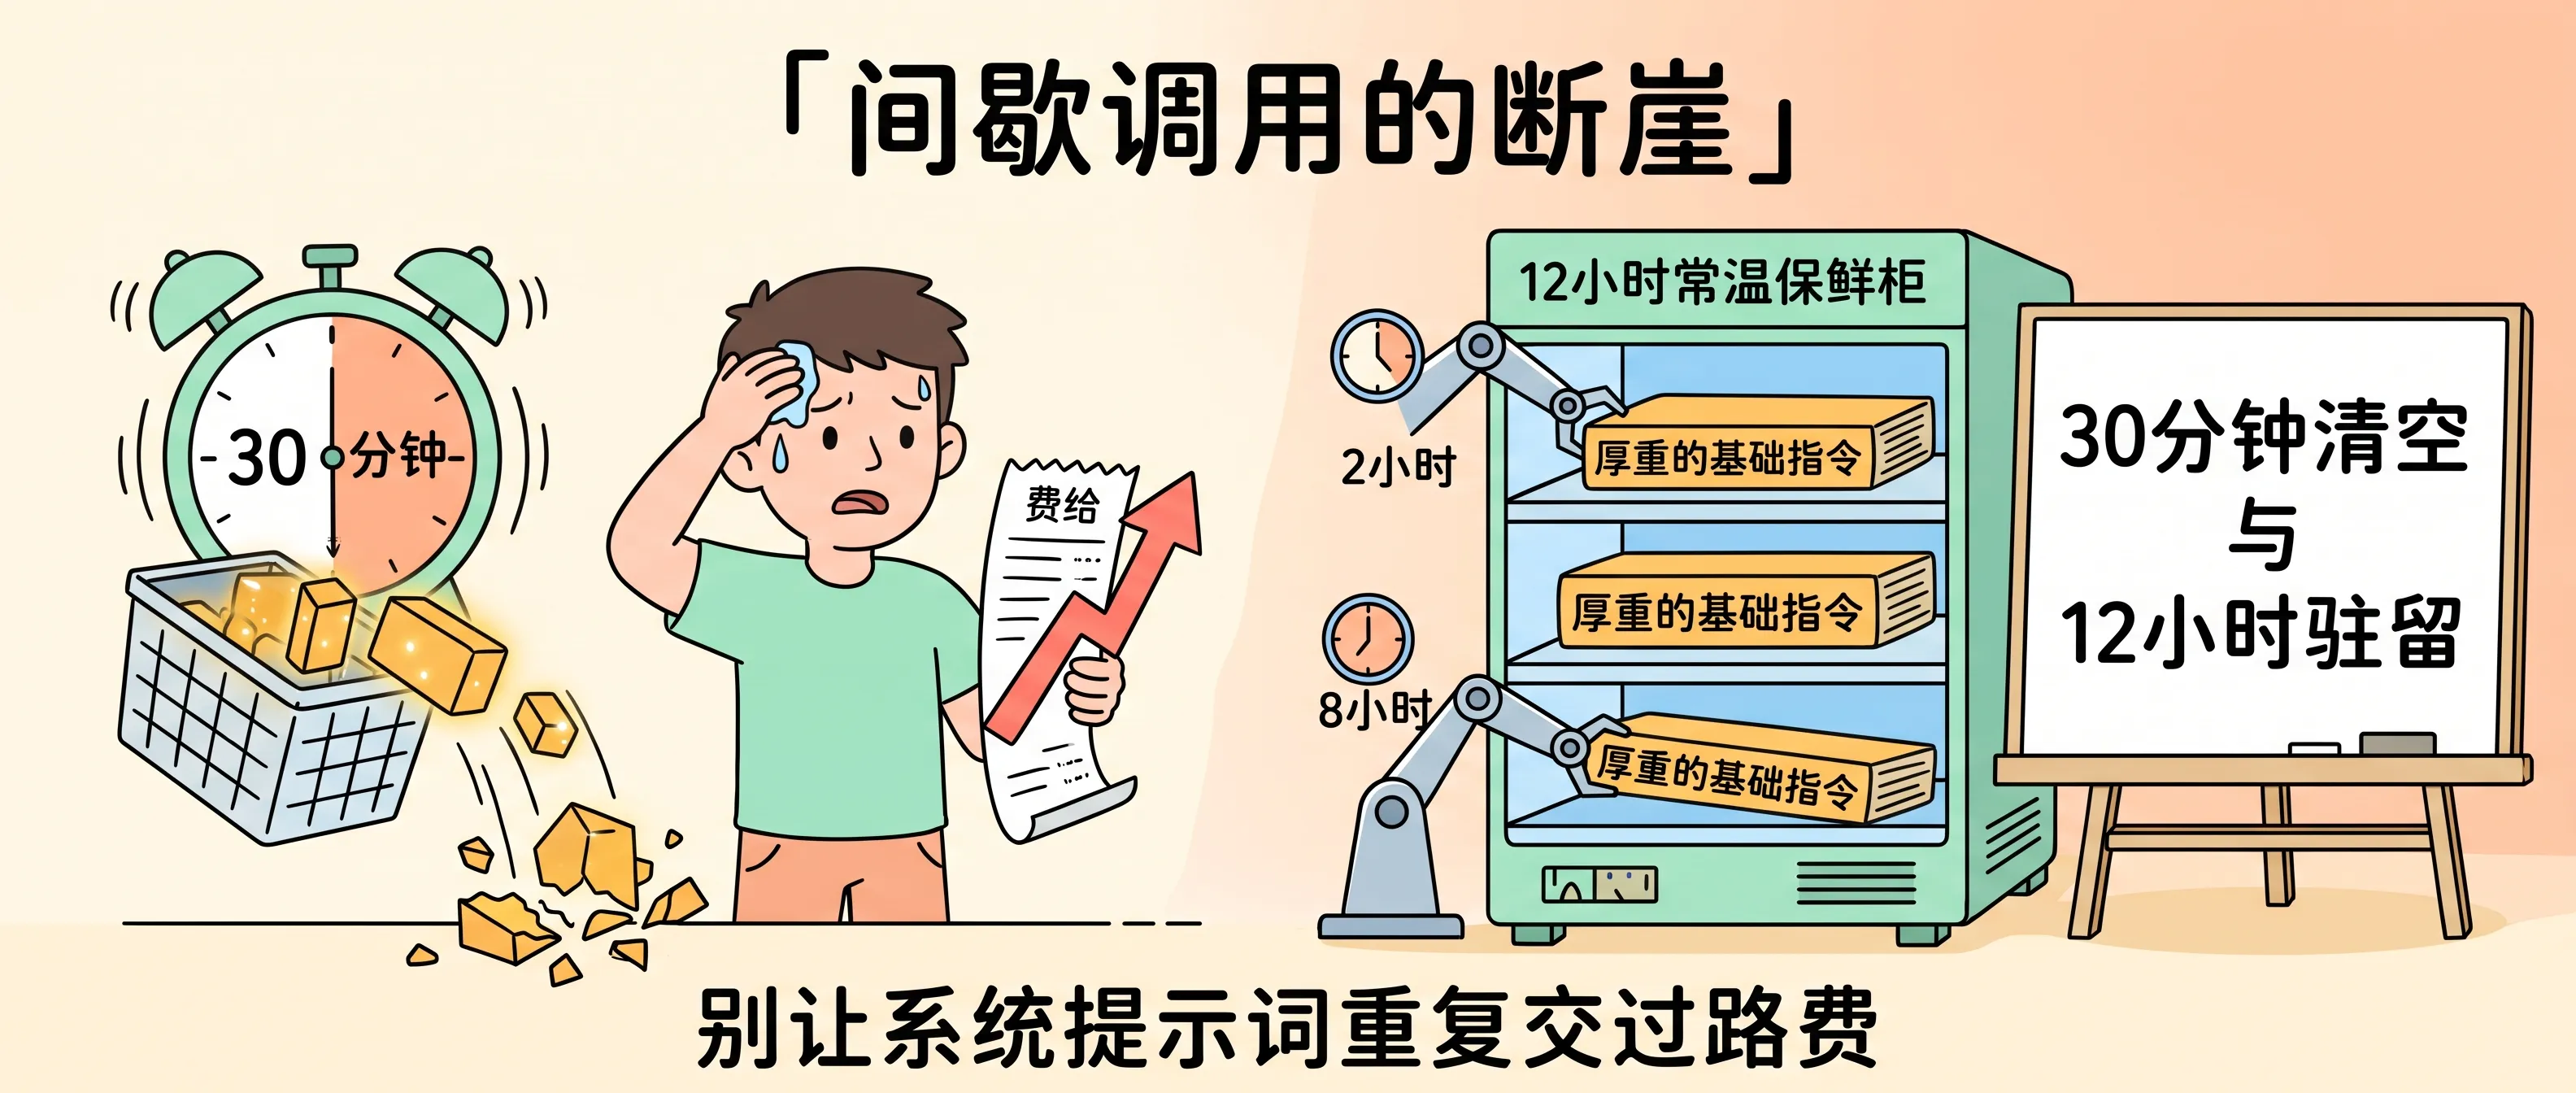
30 分钟断崖与间歇 Agent
上周我写 《Codex 上下文翻到 500k 不加价,我反而更怕了》,聊过平台用订阅月费吸收长上下文算力,把开发者绑进自家环境。物理定律没有消失,服务器显存开销总有人付钱。
今天 OpenAI 把这笔算盘摆到 API 接口。
我自己开一人公司,常驻几个独立 Agent。有些接客服工单,有些查 GitHub 报错,有些抓取监控日志。
这类 Agent 间歇运行,两三个小时接收一次外部触发。
客户上午 9 点发来咨询,Agent 读取 50k 产品手册与业务规则给出回复。下一个客户中午 11 点进线。
默认 30 分钟缓存机制下,两个小时足以产生断层:
9 点 30 分,服务器内存释放先前加载的 KV Cache。
11 点新请求到达,50k 产品规则与工具描述重新计费,GPU 重新跑 Prefill 计算。
每次唤醒,为同一份说明书付全额门票。
一天进线十次,这 50k 静态内容重复计费十次。账单数字随调用累加。
12 小时缓存切断了这个循环。9 点写入的内容留存至下午 5 点。中间间隔数小时没有指令,下一次进线仍然命中缓存。
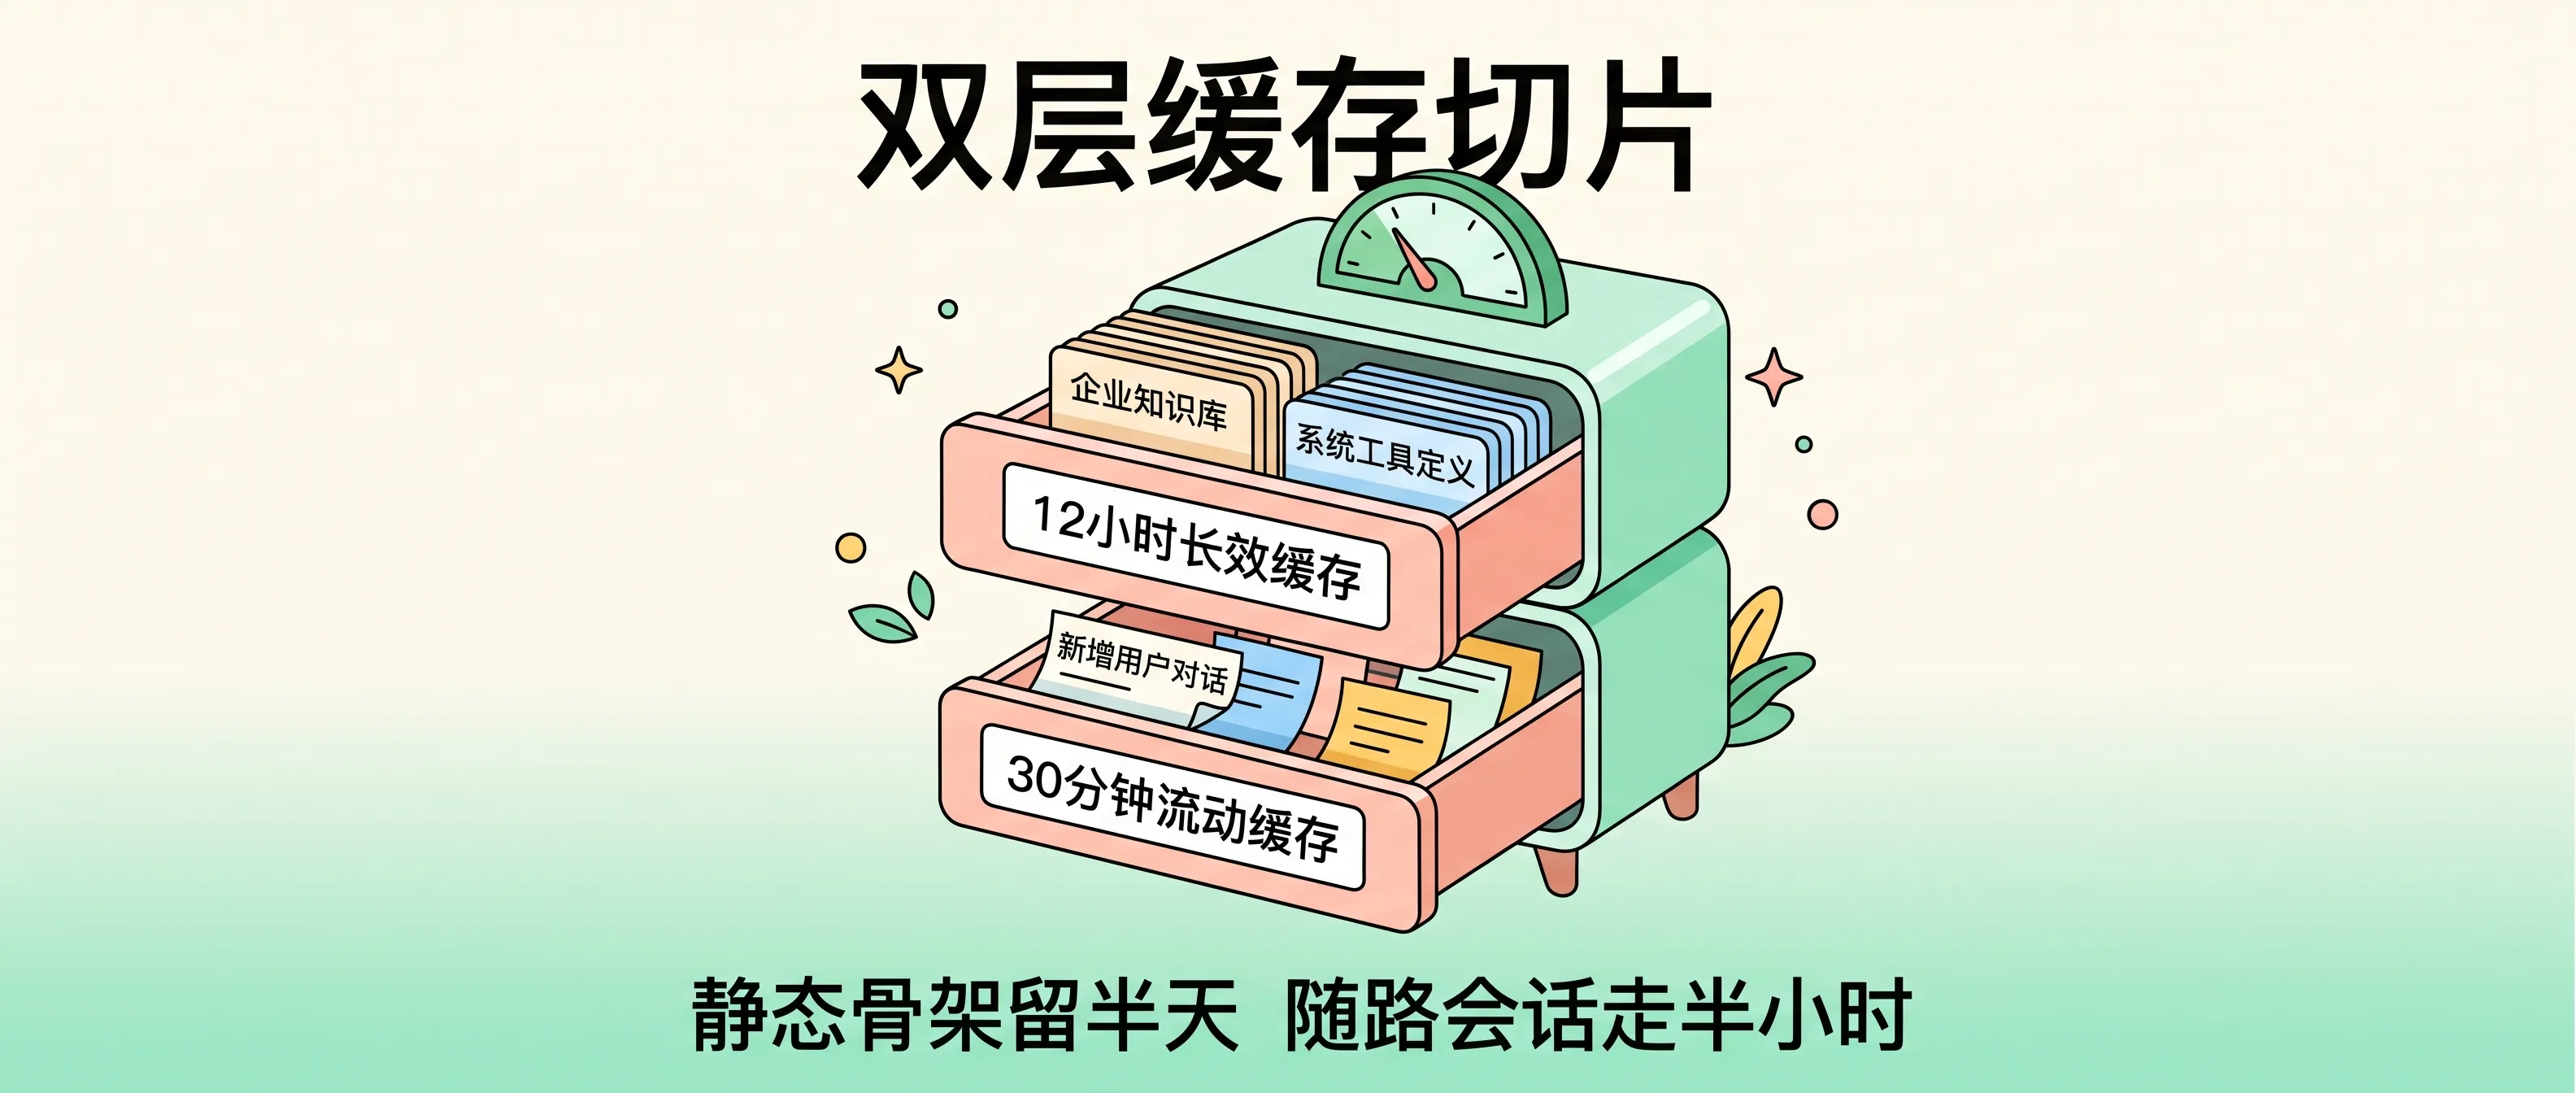
双层切片:长效指令与短效对话
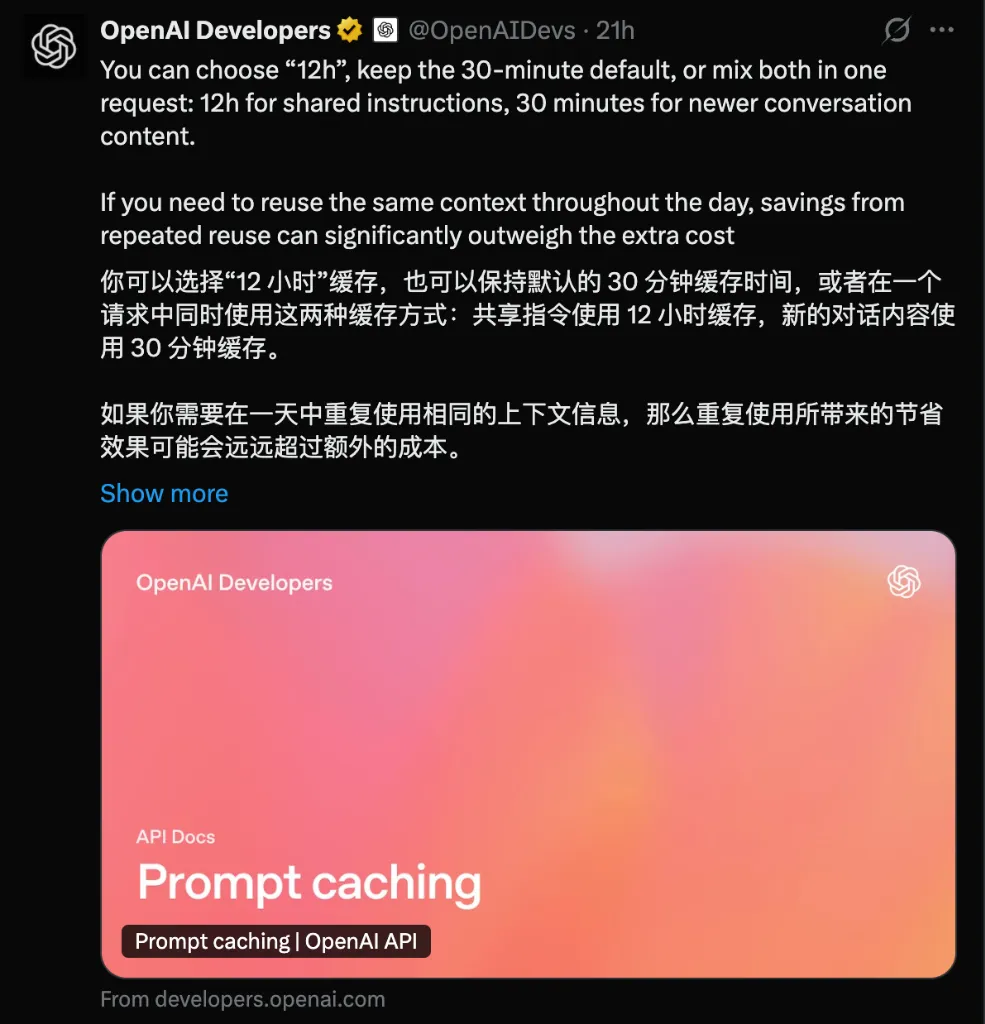
OpenAI 允许在一个请求中混配两种缓存时长:共享指令使用 12 小时,新的对话内容使用 30 分钟。如果一天中多次复用相同上下文,节省下来的费用会超过额外成本。
这一设计对齐工程结构。
一个复杂 Agent 请求由两截内容拼成:
前半截放静态骨架:系统 Prompt、角色定义、业务规范、几十个 Function Calling 工具接口描述。
后半截装实时流水:当前用户的几句对话、刚刚获取的查询结果、正在执行的代码段落。
前端骨架极少变动,体积动辄数万 Token。后半截内容随回车敲击持续拉长,寿命只有几分钟。
{
  "model": "gpt-5.6",
  "messages": [
    {
      "role": "system",
      "content": "你是一人公司的运维主管...",
      "cache_control": { "ttl": "12h" }
    },
    {
      "role": "user",
      "content": "检查今天下午三点的集群网络状况...",
      "cache_control": { "ttl": "30m" }
    }
  ]
}
拆开两截内容,账单逻辑清楚显现:
静态骨架锁定 12 小时存储时间。早上开工到晚上关机,骨架常驻显存。无论何时触发,直接命中缓存。
实时对话保留 30 分钟默认策略。调试结束,临时上下文过期释放,不占长效名额。
静态资产与消耗品分开管理,一人公司的资源消耗才能收敛。
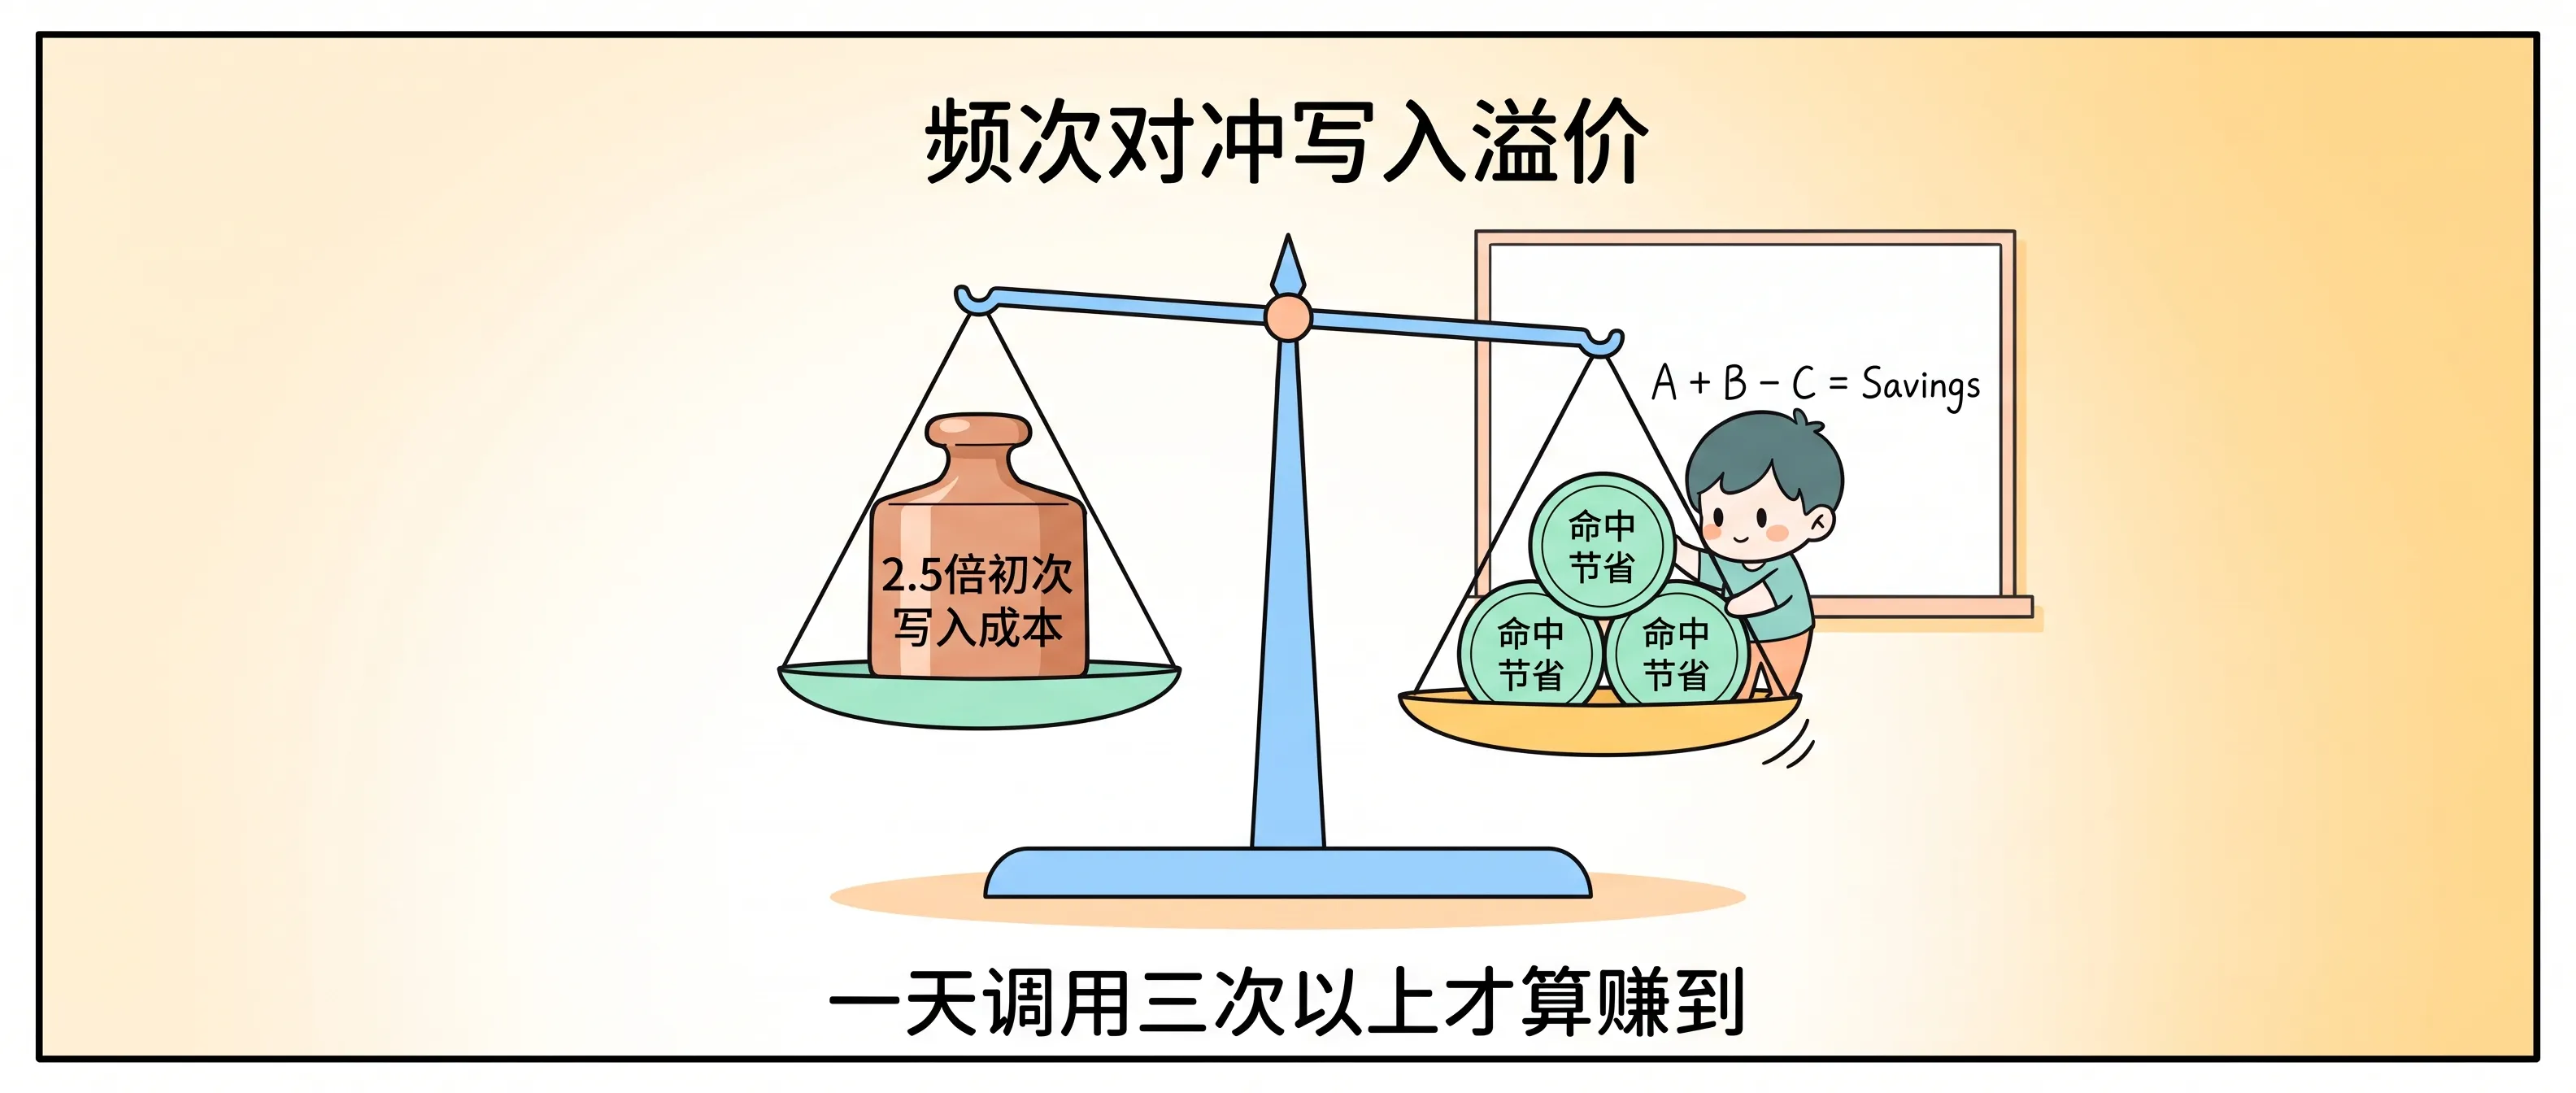
写入溢价与频次平衡点
服务器内存需要成本。
数据驻留缓存 12 小时,服务商承担硬件占用。
OpenAI 价格表标出规则:选择 12 小时缓存,初次写入 Token 费率高出普通输入 2.5 倍。
建立 12 小时缓存相当于先交进场保管费。
业务一天只跑一次,例如清晨 8 点生成一份晨报后全天休眠。
开启 12 小时缓存直接亏损。
你为静态前缀支付 2.5 倍写入单价,随后 12 小时没有第二次调用。这笔保管费沉入水底,总账单高出普通调用 150%。
一天内多次使用相同上下文信息,重复使用带来的节省超过 12 小时缓存带来的额外成本。
算一笔账:
静态指令占 40k Token。
普通输入费率按每百万 Token 2 美元计,缓存命中读取按每百万 Token 0.5 美元计。
12 小时缓存初次写入费率为 2 × 2.5 = 5 美元每百万 Token。
写入 40k 的 12 小时缓存,初次花费:
40,000 × (5 / 1,000,000) = 0.20 美元。
全天调用四次:
第一次写入消耗 0.20 美元;
后三次命中缓存,每次读取消耗:
40,000 × (0.5 / 1,000,000) = 0.02 美元。
四次调用的总费用:
0.20 + 0.02 × 3 = 0.26 美元。
不开启 12 小时缓存,由于四次调用间隔超过 30 分钟,每次重新按普通输入计费:
40,000 × (2 / 1,000,000) × 4 = 0.32 美元。
调用四次,12 小时方案开始省钱。
调用次数增至十次,差价拉开:
普通方案付 0.80 美元,12 小时方案只付 0.38 美元,开销缩减过半。
判断开启 12 小时只看一个指标:手里的 Agent 一天被敲醒几次。
日调用低于三次的任务,交给 30 分钟默认机制。日调用超过三次的间歇任务,切换 12 小时。
前缀对齐的硬规矩
拿到 12 小时缓存红利,代码里需要守住一条规矩:
前缀必须字节级对齐。
缓存命中依赖前缀哈希计算。改动字符中的一个逗号,后续缓存立刻失效。
踩坑过程留下三处教训:
系统 Prompt 顶端禁止放入跳动的时间戳。
开发者常在系统提示词第一行写:当前时间为 2026-10-21 14:30:00。
写下这句话,40k 的 12 小时缓存宣告报废。
每过一分钟,时间字符串变化一次,哈希值整体重算。服务器把每次调用当成全新内容收费,2.5 倍写入惩罚反复触发,账单超标。
保持系统 Prompt 全静态,时间戳追加在用户发言末尾。
固定工具列表与参数 Schema 的键值顺序。
注册 Function Calling 工具时,字典键值排序混乱会导致生成的 JSON 字符串前后不一。
序列化工具描述时,代码锁死排序键值,保持发送给 API 的字节序列一致。
隔离多租户上下文。
给不同项目提供服务时,提取公共代码规范与通用工具包,放在 Prompt 前端;个性化客户资料与特定变量排在后面。
前面共享的 30k 锁定 12 小时缓存,后面差异数据随发随走。
把账算清,再启动进程
Codex 把 500k 上下文塞进月费,以订阅制捆绑开发者的工作流。
OpenAI 把 API 缓存拉长到 12 小时,以阶梯计价盘活云端显存周转。
一人公司没有大厂烧不完的算力预算。
开动 Agent 之前,数一数系统提示词长度,查一查后台任务频次,把静态指令和随路会话切成两截。
算清平衡点,前缀对齐,再按下回车。
随口聊两句存储标的
跳出代码,站在底层物理设施看:
不管是 500k 上下文,还是 12 小时的 KV Cache 常驻,本质上都在吞噬高带宽显存(HBM)与海量 DRAM 颗粒。模型越往 Agent 演进,计算越离不开存储承载。
我自己建了小仓位,拿着美光(MU)、闪迪概念(SNDK)和 SK海力士。作为一个天天在 AI 赛道泡着的人,我长期看好存储这条链条。
日常记录,不构成投资建议。
相关阅读
- Codex 上下文翻到 500k 不加价,我反而更怕了
- KV Cache:你用 ChatGPT 第一个字特别慢,原因就在这里
- Claude代运营上线:在不确定的环境里,买一份确定的顶尖生产力
- 同时开 5 个 Agent 之后,我让它们用飞机维修手册的语言给我汇报
X 短帖:
OpenAI 在 API 里上线 12 小时提示缓存,支持与 30 分钟缓存混用。接上周聊的 Codex 500k,一人公司的 Agent 账单有了新算法:12 小时需要多付 2.5 倍初次写入费。系统指令一天复用三次以上才开始省钱。前缀不要放动态时间戳,静态指令锁半天,动态日志留半小时。算清账再敲回车。 [文章链接待补]