大家好,我是 Jason。
这几天面试应聘 AI Agent 岗位的工程师。
翻开几十份简历,满屏写着前沿词汇。有人写多智能体协同,有人写落地千万级企业系统,纸面数据漂亮。
坐进会议室聊上二十分钟,项目经不起推敲。
有人看着副屏上的 AI 窗口念稿。声音平稳,句子规整,像播音员读新闻。打断追问底层细节,对方眼神移向侧面,停在半空。
做工程讲究踩实地面。代码跑没跑过,数据洗没洗过,边界调没调过,三句话就能摸到底牌。
屏幕那头没删掉的提示词
这次面试遇到了不少真实的尴尬场景。
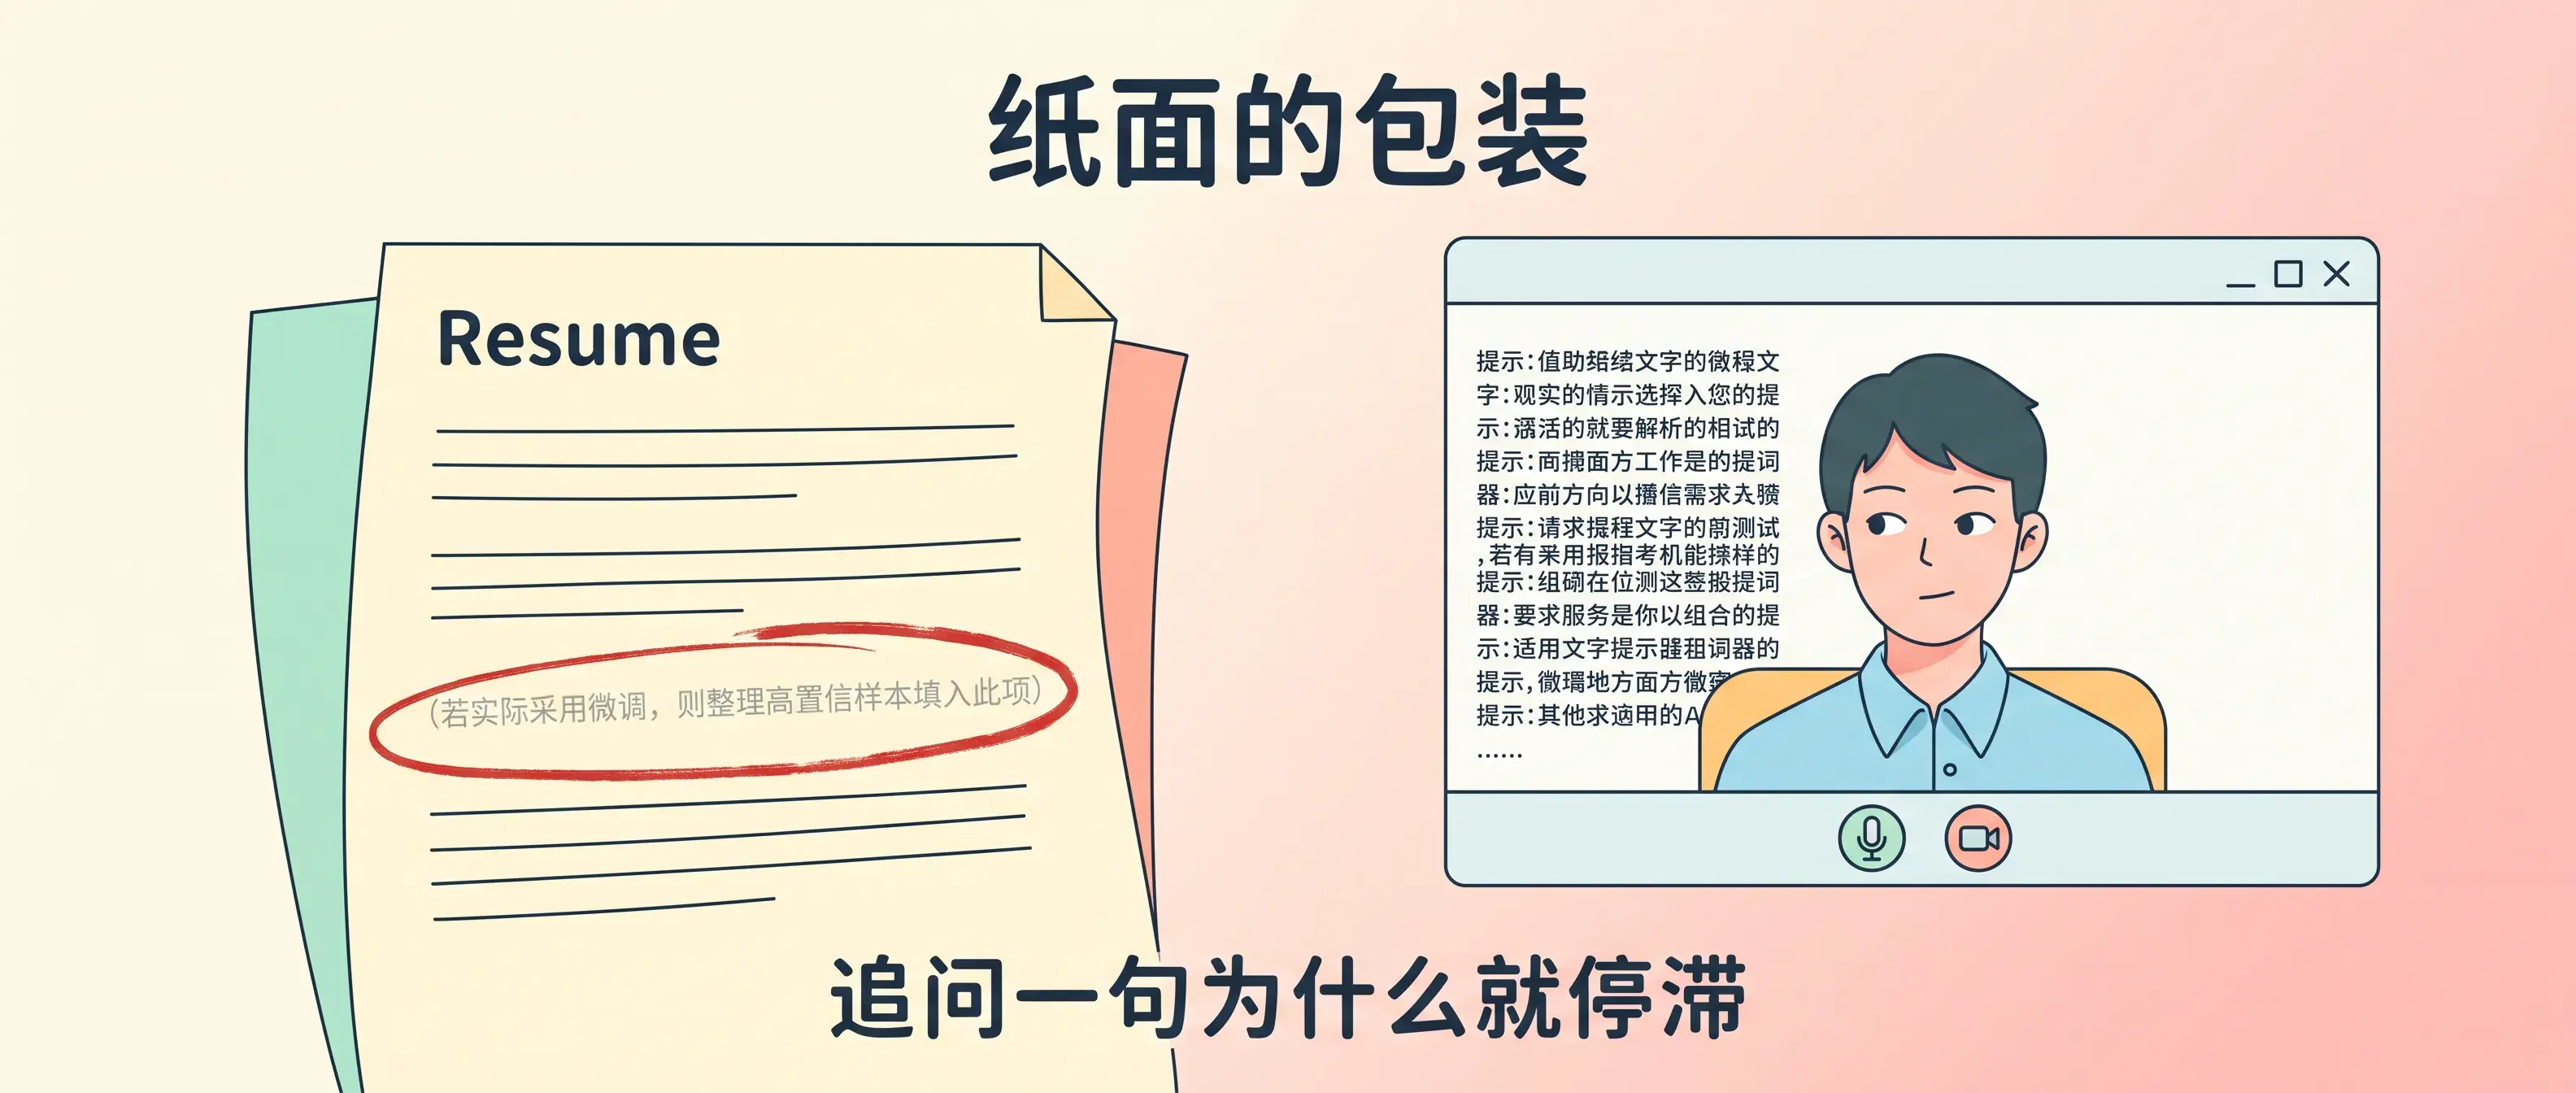
一份简历递过来,项目经历排满三页纸。翻到第三段第二行,括号里躺着半句话:“若实际采用微调,则整理高置信样本填入此项……”
大模型帮他写完简历模板,他连括号里的提示词都没删,直接导出 PDF 投了过来。
聊起智能客服项目,简历上写着“端到端任务成功率 88%”。
我顺着数字往下问:“剩下的 12% 失败场景,具体由什么原因造成?超时、工具解析出错,或是意图跑偏?”
对方抿住嘴,接不上话。会议室里只剩下电脑风扇的转动声。
另一份简历写着“从零自研高并发 ReAct 推理引擎”。
我问他:“开源社区有成型的 LangGraph 和成熟工作流,你们自研相比现成方案,付出了什么代价?换取了哪类收益?”
他绕了半天,承认直接克隆自开源仓库的几百行脚本,自己改了配置文件名字。
还有一位写着“基于 LlamaFactory 调优垂直领域模型”。
我问他:“训练数据有多少条?LoRA 的 rank 设了多少?学习率怎么调整?”
他看着屏幕右上角,报不出一个具体的数字。
包装纸一层层剥开,里头没有搭好骨架。
三层追问:代码骗不了人
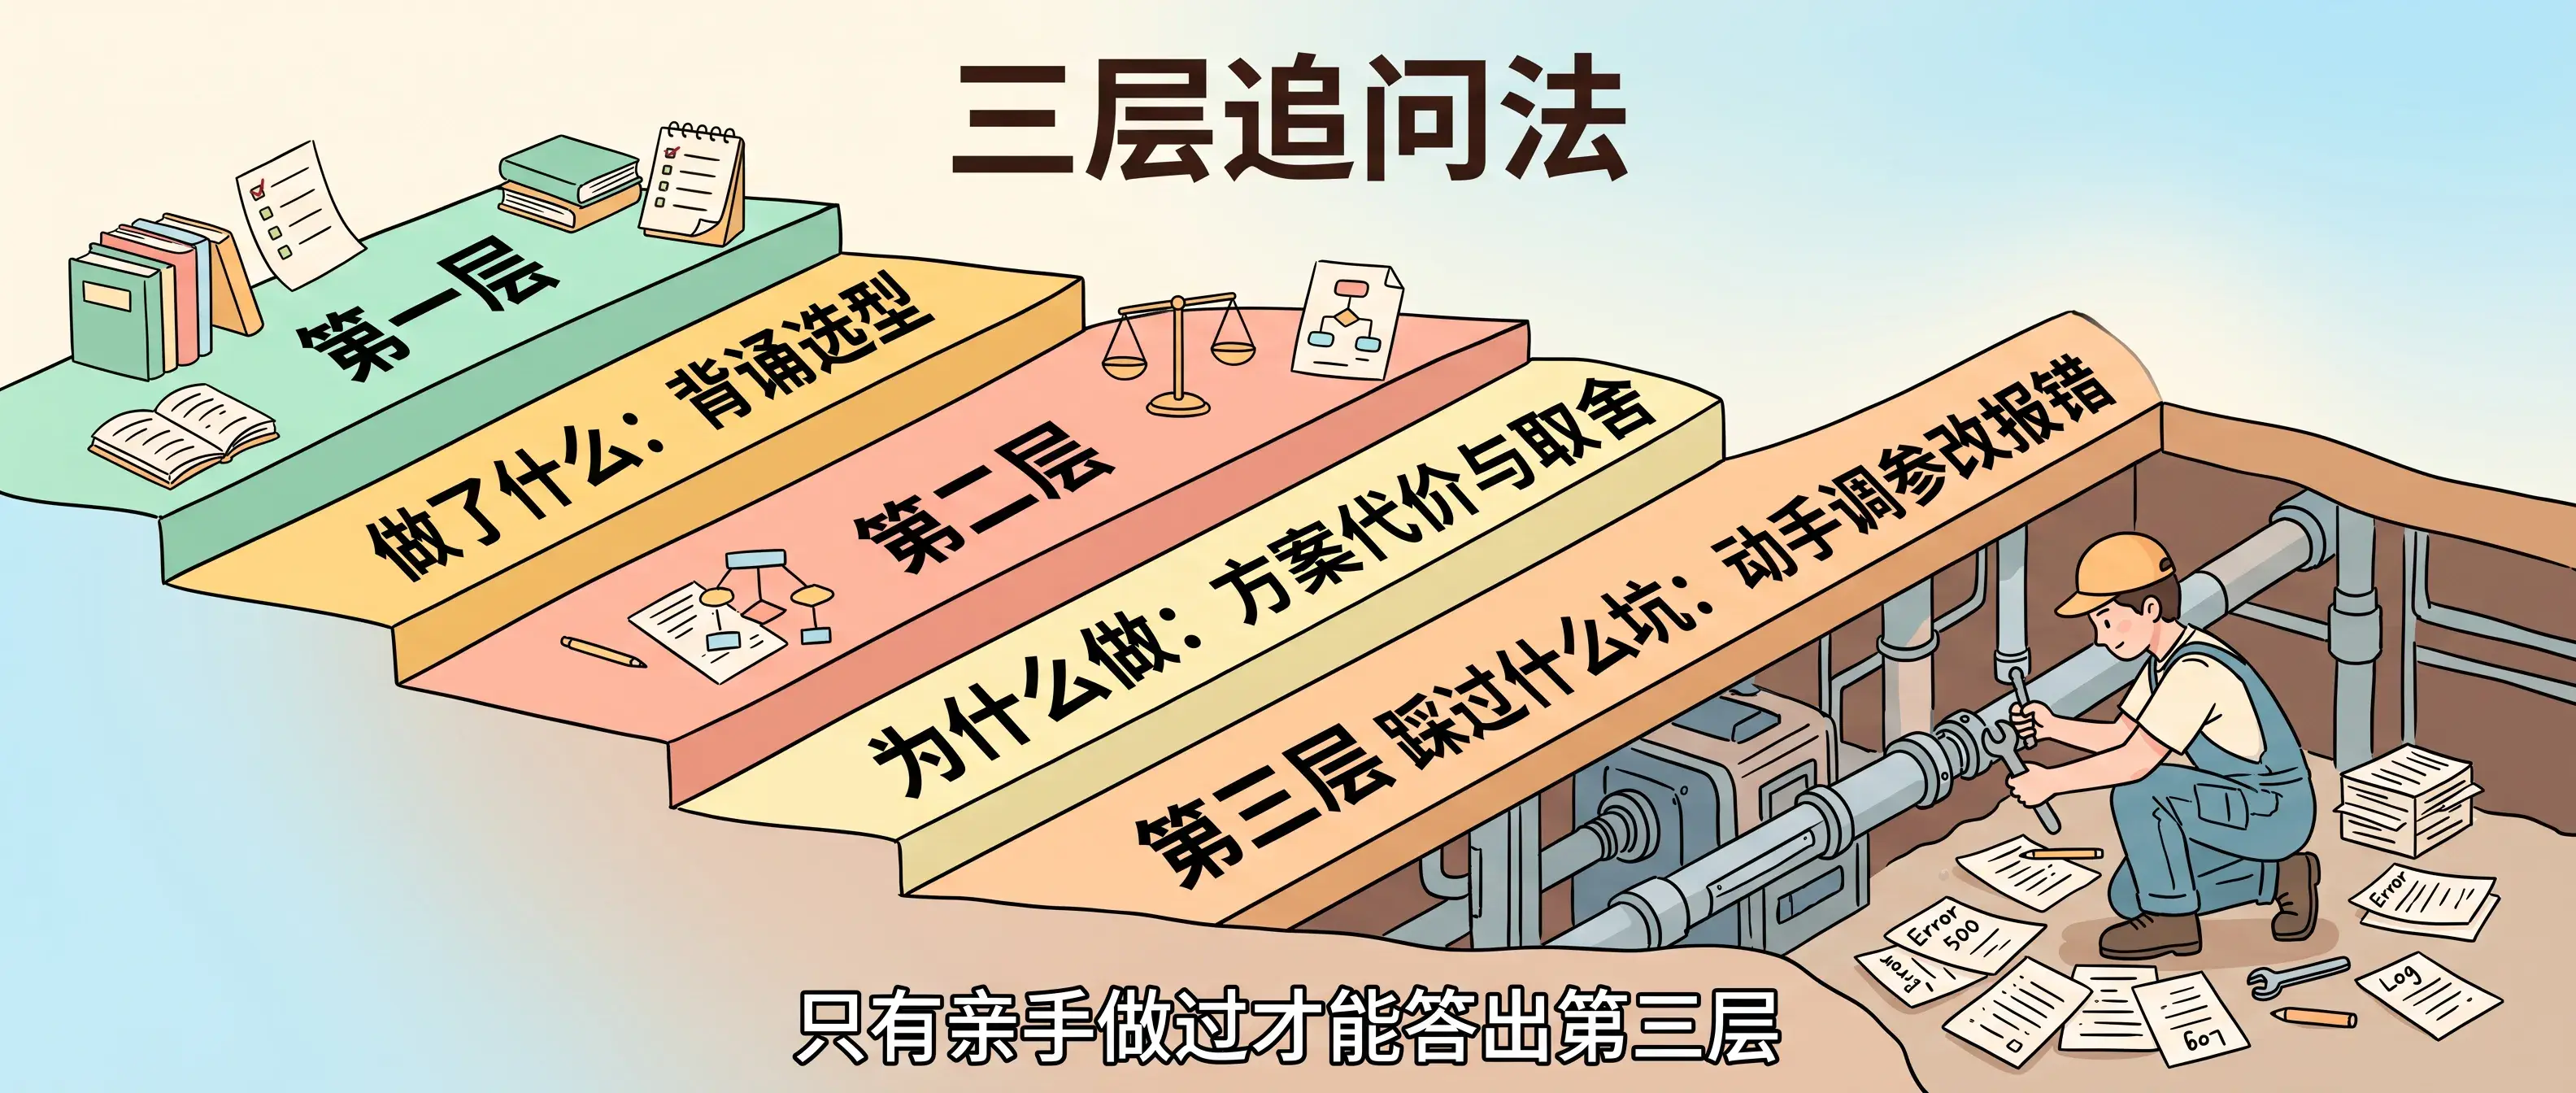
筛查项目真实度,我通常用三个阶梯的问题。
先问做了什么。
这层问业务输入、技术选型和模块连接方式。用什么模型,配什么向量库,调什么外部接口。背过简历的人能顺畅报出流程图。
再问为什么这么做。
从这里开始分流。
为什么选提示词工程而不做微调?为什么用向量检索搭配重排序,放弃拉长上下文窗口直接吞下文档?为什么这个分支让确定性代码处理,那个分支交由模型推理?
技术选型总伴随代价。延迟、显存、成本和维护负担,怎么平衡?真做过项目的人能讲清取舍逻辑。靠背答案的人,给不出合理的对比依据。
最后问踩过什么坑、怎么解决。
这一层验出真假。
亲手写过代码的人,手里攥着账本:模型在长文本下丢掉指令;JSON 解析在特殊标点下爆出异常;并发上来触发 API 频次受限;外部工具返回脏数据,Agent 陷入死循环烧光预算。
聊到解决办法,做过的人能指出自己在哪个节点加了格式校验,怎么设计降级熔断,怎么用轻量模型做意图分流。那些编造项目的人,双手一摊回答:“架构设计完备,开发顺畅,没有遇到阻碍。”
在复杂的大模型系统里声称一路平顺,恰恰暴露出没有真正落地。
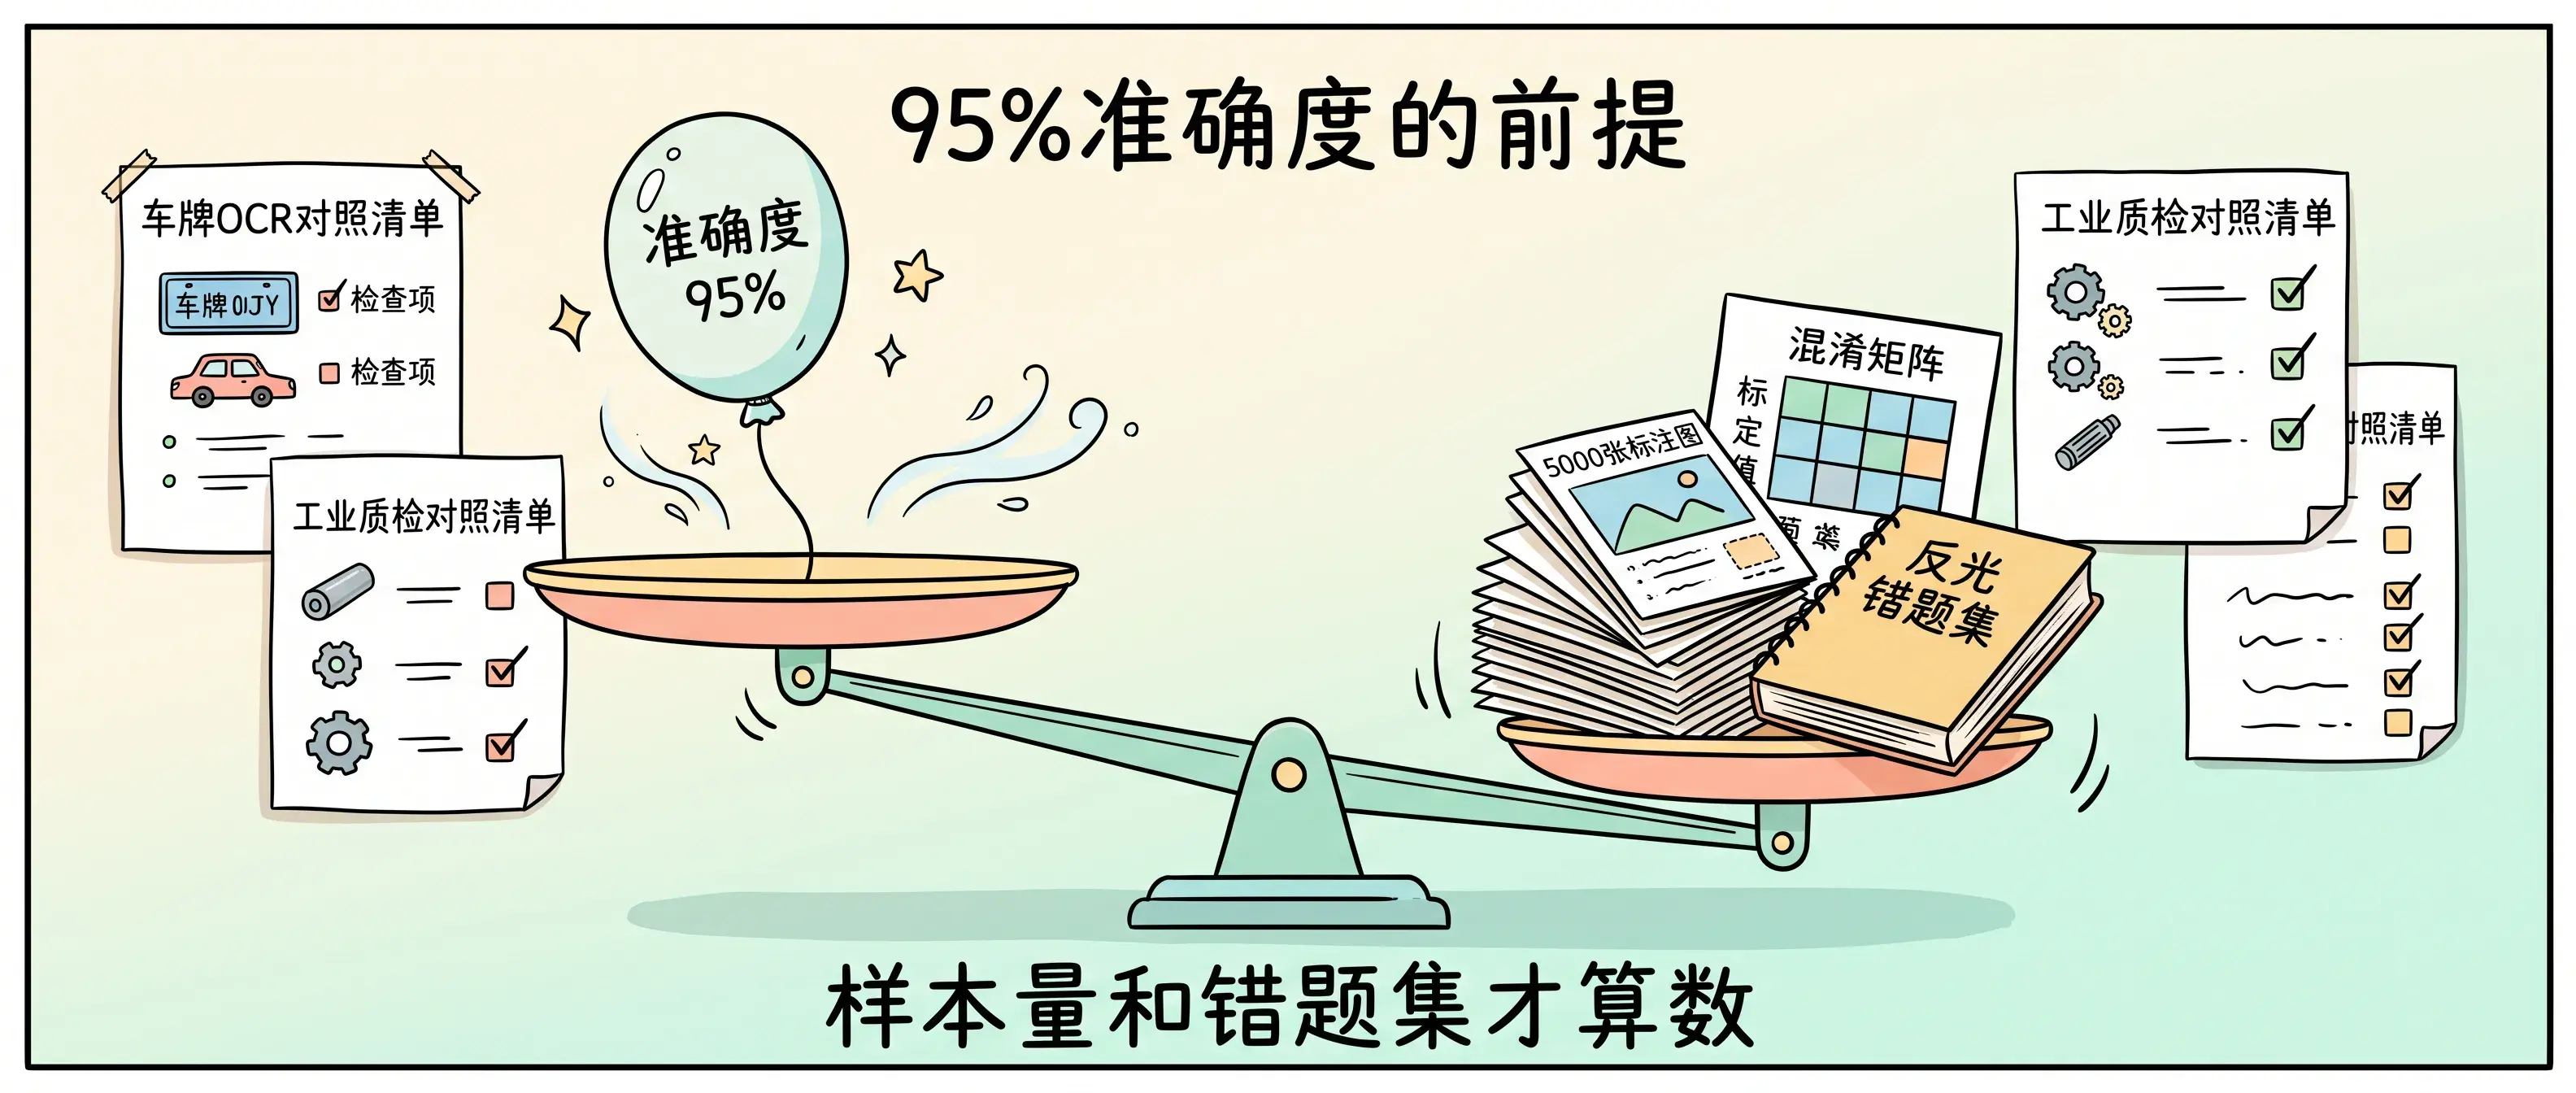
95% 的多模态准确度,离开样本量毫无意义
聊到多模态,简历写着“图片识别准确度 95%”。
我问候选人:“测试集有多少张图片?正负样本比例多少?召回率维持在多少?”
对方答不上来。
95% 这个数字,脱离样本量和业务场景,没有任何参考价值。
什么场景能做到 95%?任务范围极窄、环境高度受控。
发票与身份证文字 OCR、车牌识别、配合拍摄的人脸比对,能跑出 98% 到 99% 的成绩。工厂固定机位流水线质检,光照固定、背景单一,靠几千到上万张标注图训练专用模型,也能摸到 95% 到 99%。
换到复杂业务,95% 站不住脚。
零售货架商品识别,SKU 多、商品互相遮挡;服装款式细分;设备外壳划痕检测;还有需要主观判断的任务,比如判定损伤来自人为破坏还是自然磨损。两个质检员对着同一张图都无法达成 95% 的共识,模型做不到稳定 95%。
直接调用通用多模态大模型 API,不做大量标注样本训练,在垂直业务里很难达到这个水平。
更严重的问题在样本量。
测试集只有 20 张图,对了 19 张,统计置信区间在 76% 到 99%,纯属随机波动。测试集给到 100 张,范围在 89% 到 98%。拉到 1000 张以上,95% 才有说服力。
数据里还藏着注水陷阱。
类别不平衡。一万件零件里只有 5 个残次品。算法把所有零件判成合格,准确率直接达到 99.95%,缺陷召回率等于 0。残次品没有找出来,高准确率掩盖了整批废品。
测试集与训练集重叠。拿训练过的图片做测试,分数虚高,上线遇到真实样本就会崩溃。
面试时最有效的追问:
“剩下的 5% 错在哪些图片上?举两个具体的错题例子。”
亲手做过评估的人,脑子里立刻浮现出具体的难缠图片:金属反光的误判、型号相近造成的混淆。连一个错误例子都说不出,这个数字绝非亲手测得。做不出严谨的测试集,优化无从谈起。
我们鼓励用工具,不接受用工具伪装
我不排斥候选人借助 AI。
我自己写代码,终端挂着 Claude Code,编辑器开着 Cursor,处理杂乱数据让模型生成正则。工具能把繁琐事务压缩进几秒。善用工具属于工程师的生产力优势。
用工具提效,靠工具伪造经历,两者截然不同。
借助 AI 梳理思路、改写文段,属于正常应用。凭空编造没做过的架构,属于造假欺骗。
在面试现场偷瞄屏幕念稿,语调生硬、眼神飘忽,面试官一眼就能识破。大模型吐得出通用理论,给不出带着现场油污的工程细节。
遇到不懂的问题,坦白说明边界:“这块我之前没有实际测过。按照我的理解,排查时我会先抓日志看错误分布。”
诚实作答的评价,高过对着提词器念一段套话。
面试官寻找能够解决现实问题的人,不需要一台复读机。
动手搭一个能跑的小东西
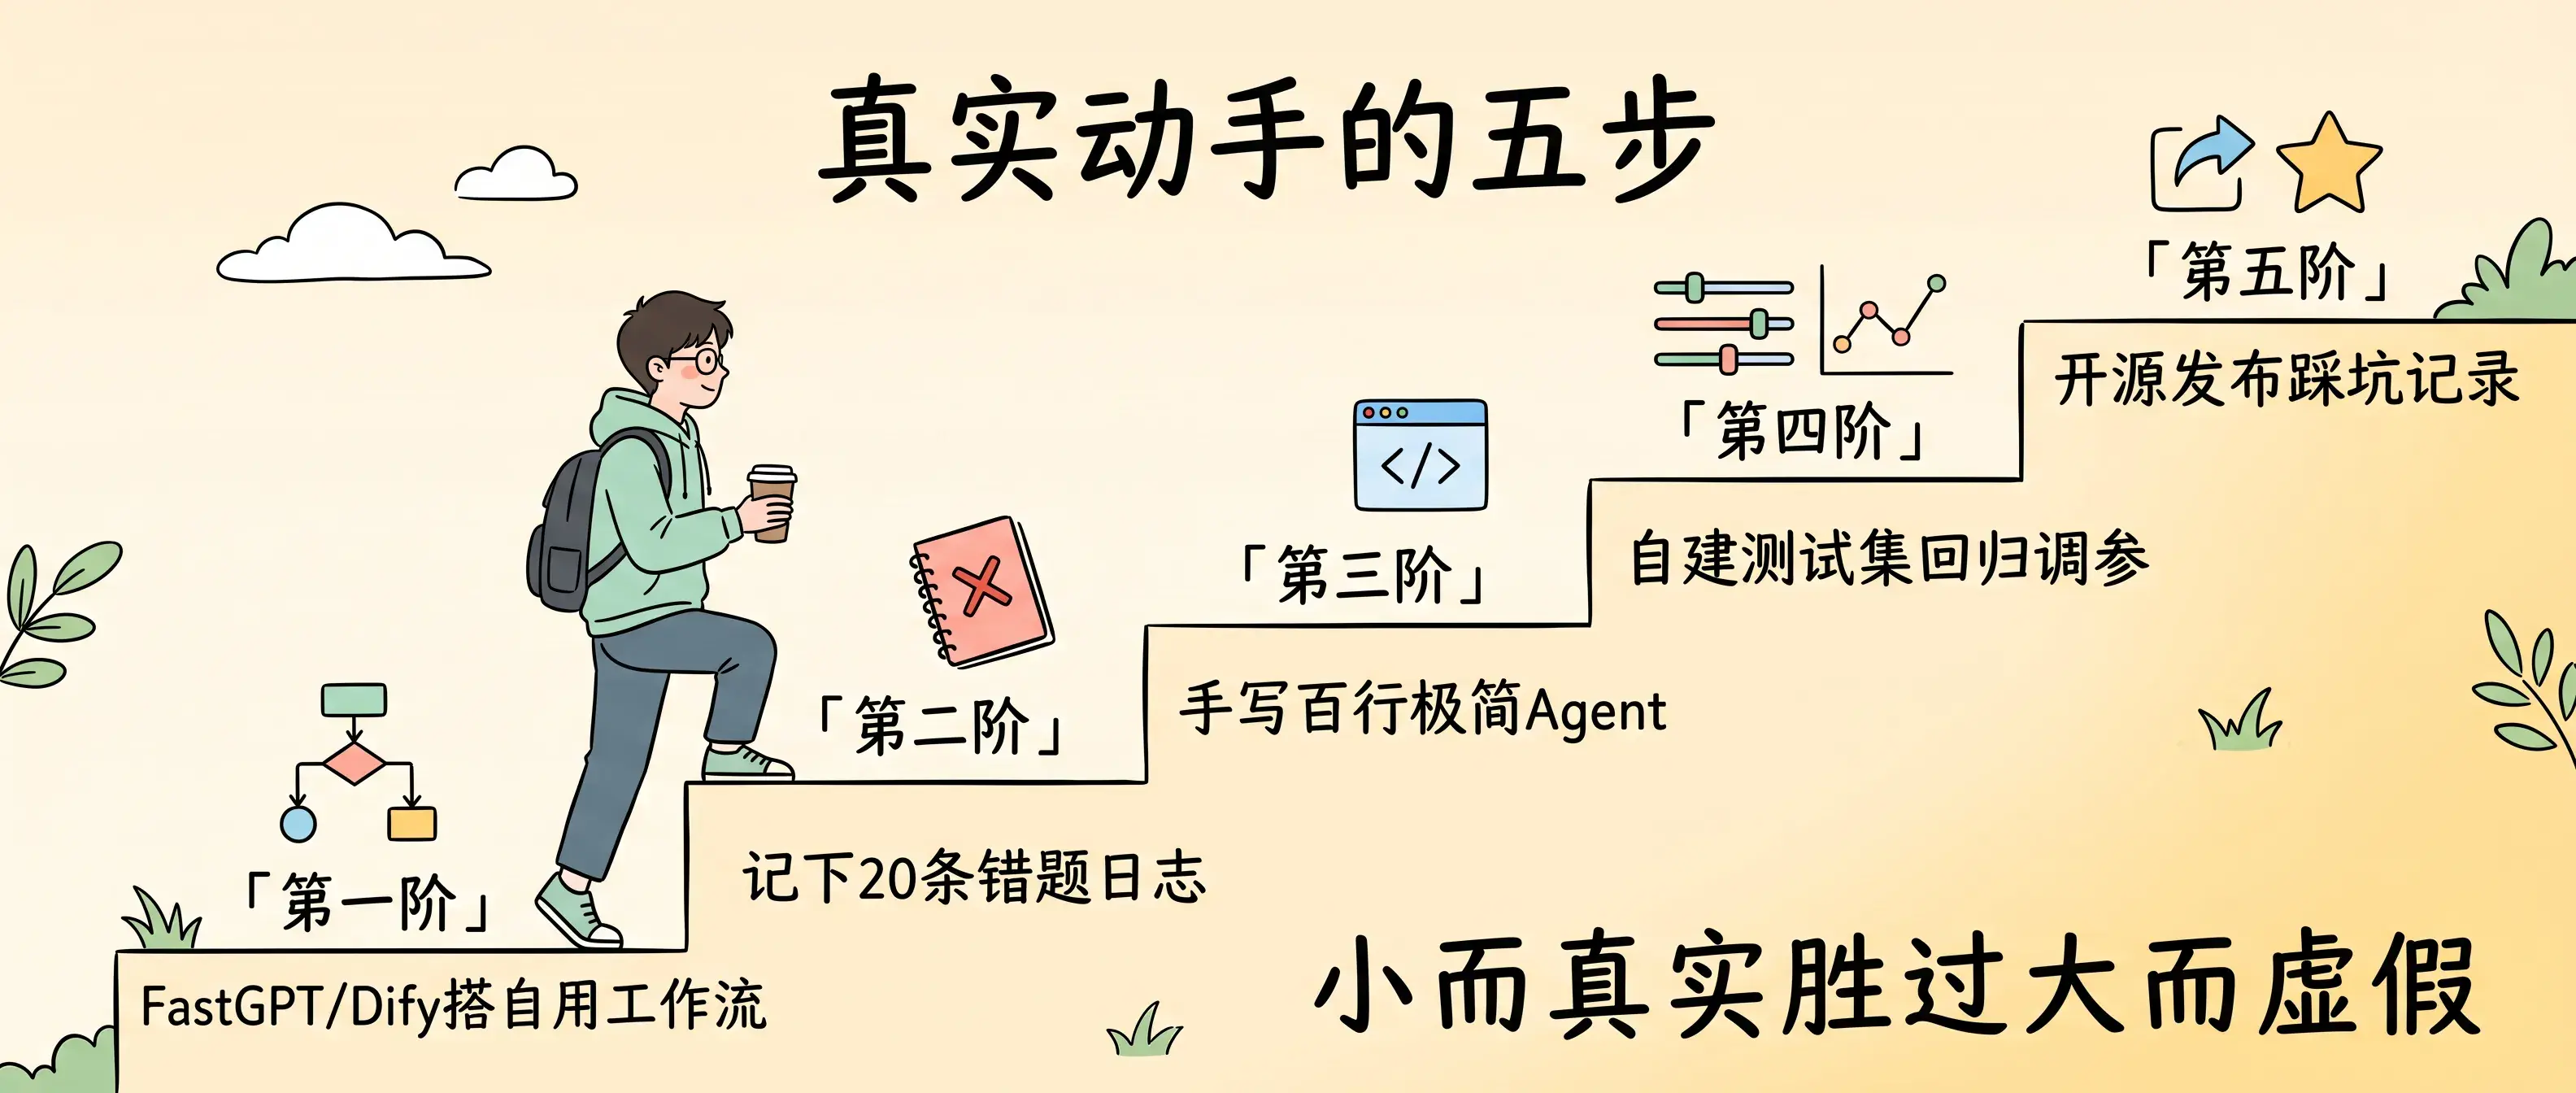
想在这个领域扎下根,不妨试试这条动手的路径:
用起来。在 FastGPT 或 Dify 上,把每天遇到的事务搭成工作流。整理阅读笔记,归纳发票,跑通真实流程,每天自己用,感受输入输出的边界。
记问题。建一个错题本。把模型答错、答非所问、工具调用失败的案例保存下来。分析失败原因,分清提示词歧义、召回文档偏差,或者字段截断。
拆开看。推开框架封装。用 Python 和基础库,手写一百行以内的最小 Agent。自己构造提示词,写循环解析模型返回的文本,提取动作和参数,调用本地函数,再把返回值拼回上下文。脱掉框架包装,看清数据与代码的真实接口。
做评估。准备二三十条真实测试样本。每次改动提示词或调整模型参数,跑一遍脚本,统计耗时、Token 花费和通过率。用测试数据对比改动效果,不用感觉做判断。
写下来。把遇到的报错、排查思路和解决过程整理成文,开源到 GitHub 或发在博客上。
一个小而真实的项目,胜过十个虚构的宏大构想。在面试里讲清如何把召回率从 60% 提到 80%、中途尝试了哪三种文本切分策略,比在纸面上写着负责企业级平台有说服力得多。
好奇心落在泥土里
我们期待的敲门砖,包含学习能力、好奇心与探索精神。
学习能力体现在你能讲出最近学了什么新技术、怎么学的、学完做出了什么小工具。
好奇心体现在你会追问底层原因,翻看开源框架的源码,跑一跑新出的轻量模型。
探索精神体现在遇到报错会自己排查日志、动手写脚本验证,不等待别人给现成答案。
吹嘘概念很容易,花时间拼凑方案随处可见。能坐下来洗脏数据、抓日志、一帧帧做错题分析的人,团队更争取。
把精力沉下去,答案都在写过的代码里。
我们目前在招 AI Agent 工程师,负责落地真实的 AI 业务项目。如果你手头有亲手跑通的工程实践,愿意在一线踏实做落地,欢迎在后台私信我。
 一个月合入两千个 PR:SpaceXAI Lauren Tan 烧掉 1.5 万亿 Token 背后的验证工程