大家好,我是 Jason。
前几天聊完月底那台 512G 的 M5 Ultra,微信里多了很多讨论。
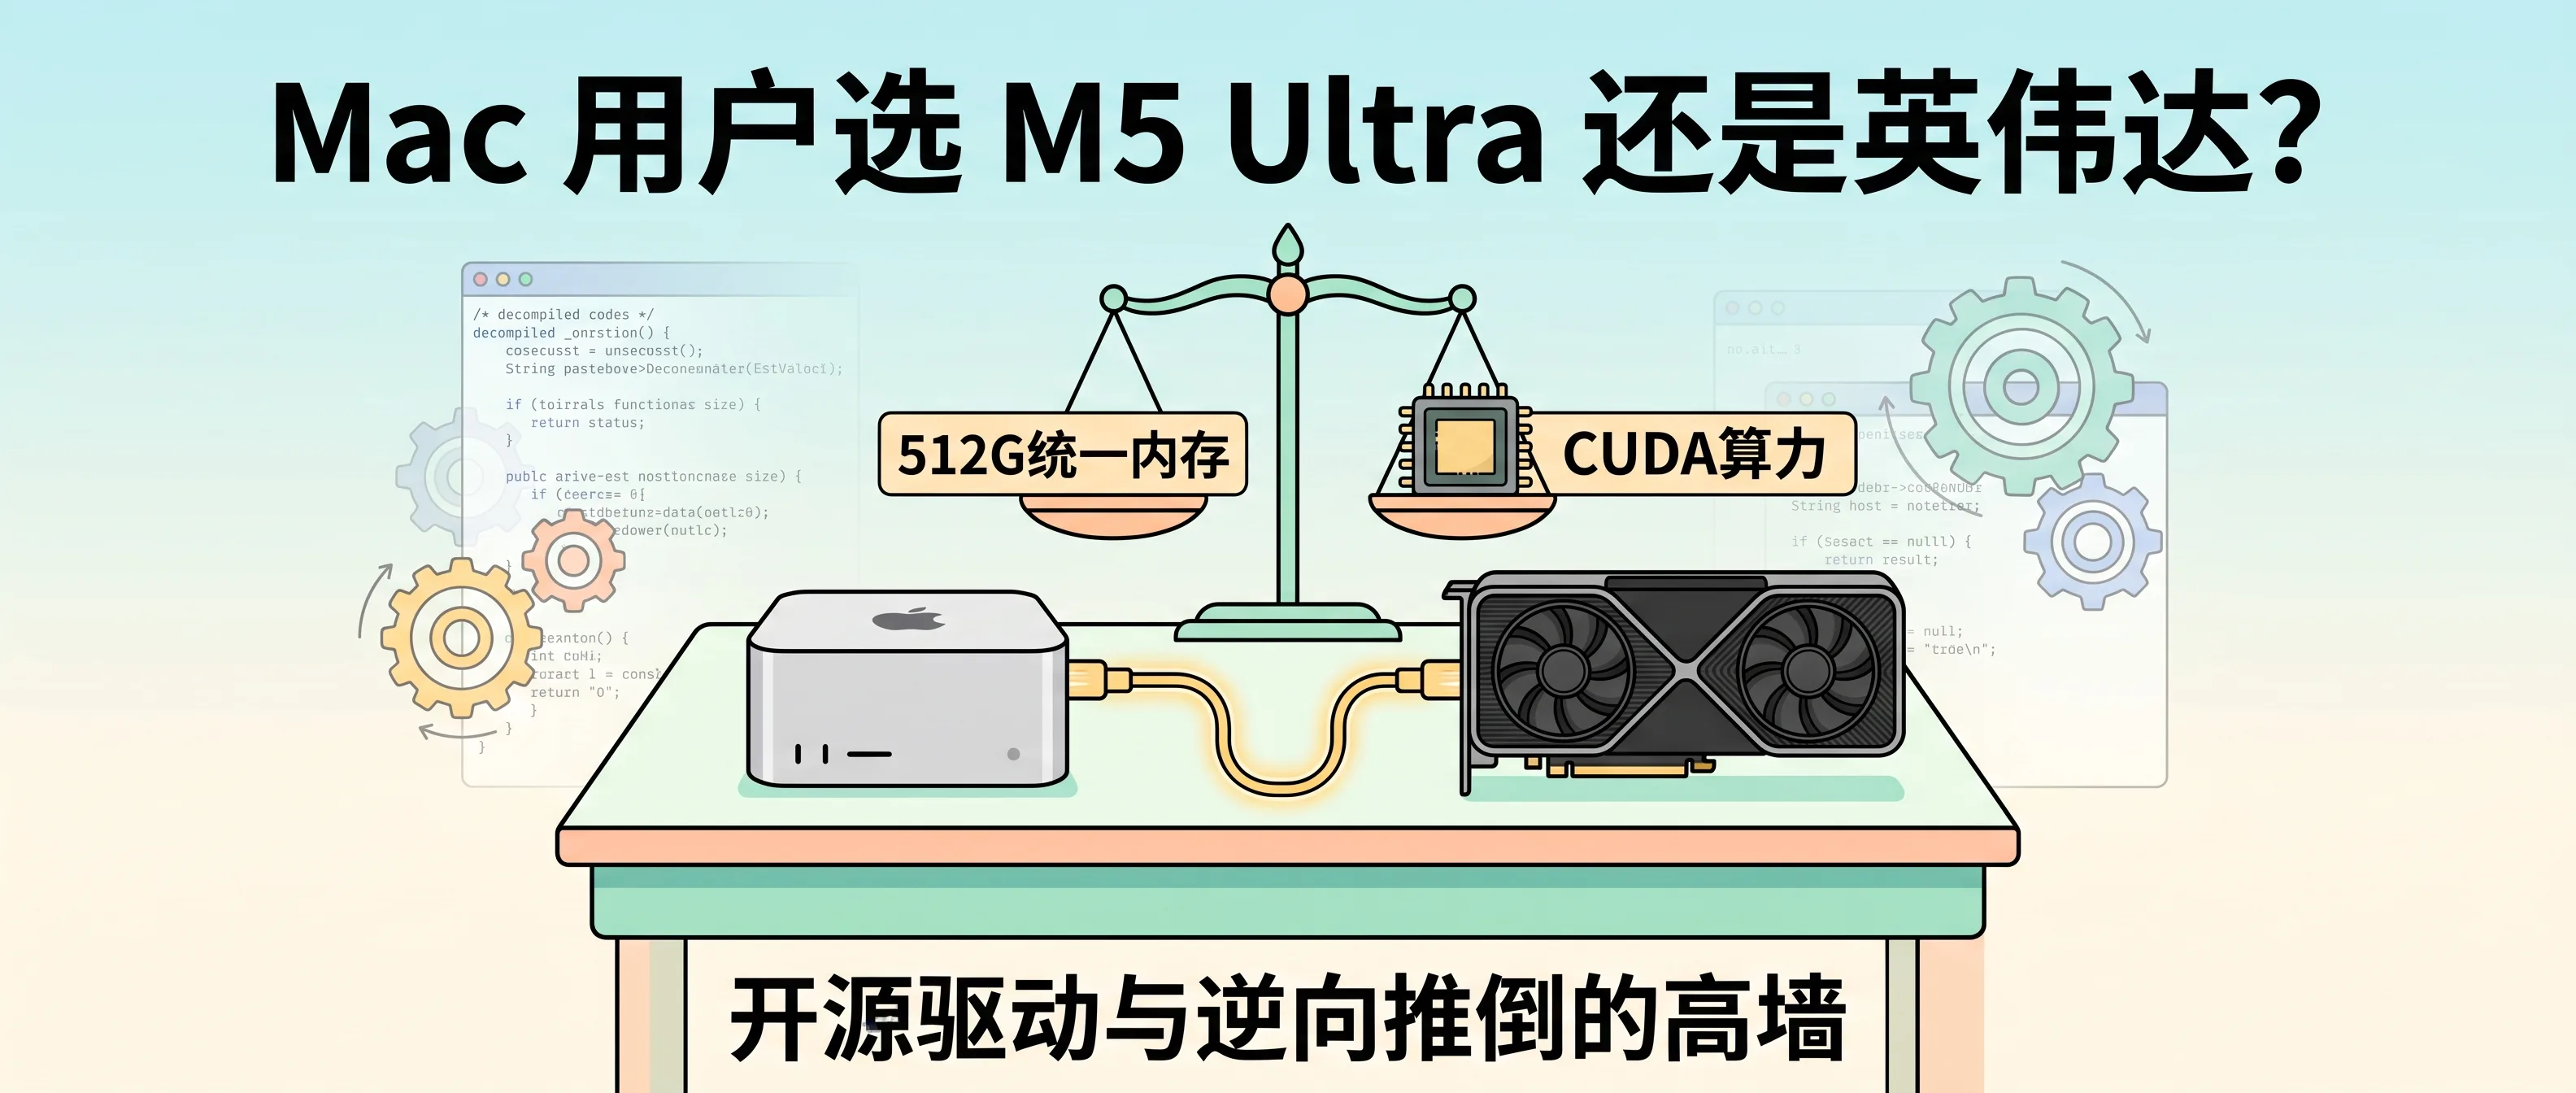
大家算来算去,纠结的还是那 12 到 15 万元的预算。
十几万买一台桌面主机,摆在任何团队面前都是一笔需要签字的实打实开销。
用这笔钱去组装一台多卡 x86 工作站,能买到充裕的浮点张量算力,也能直接接入完备的 CUDA 生态。
可很多习惯了 macOS 终端、快捷键和窗口管理的人,换回别的系统写代码,总觉得动作脱节。
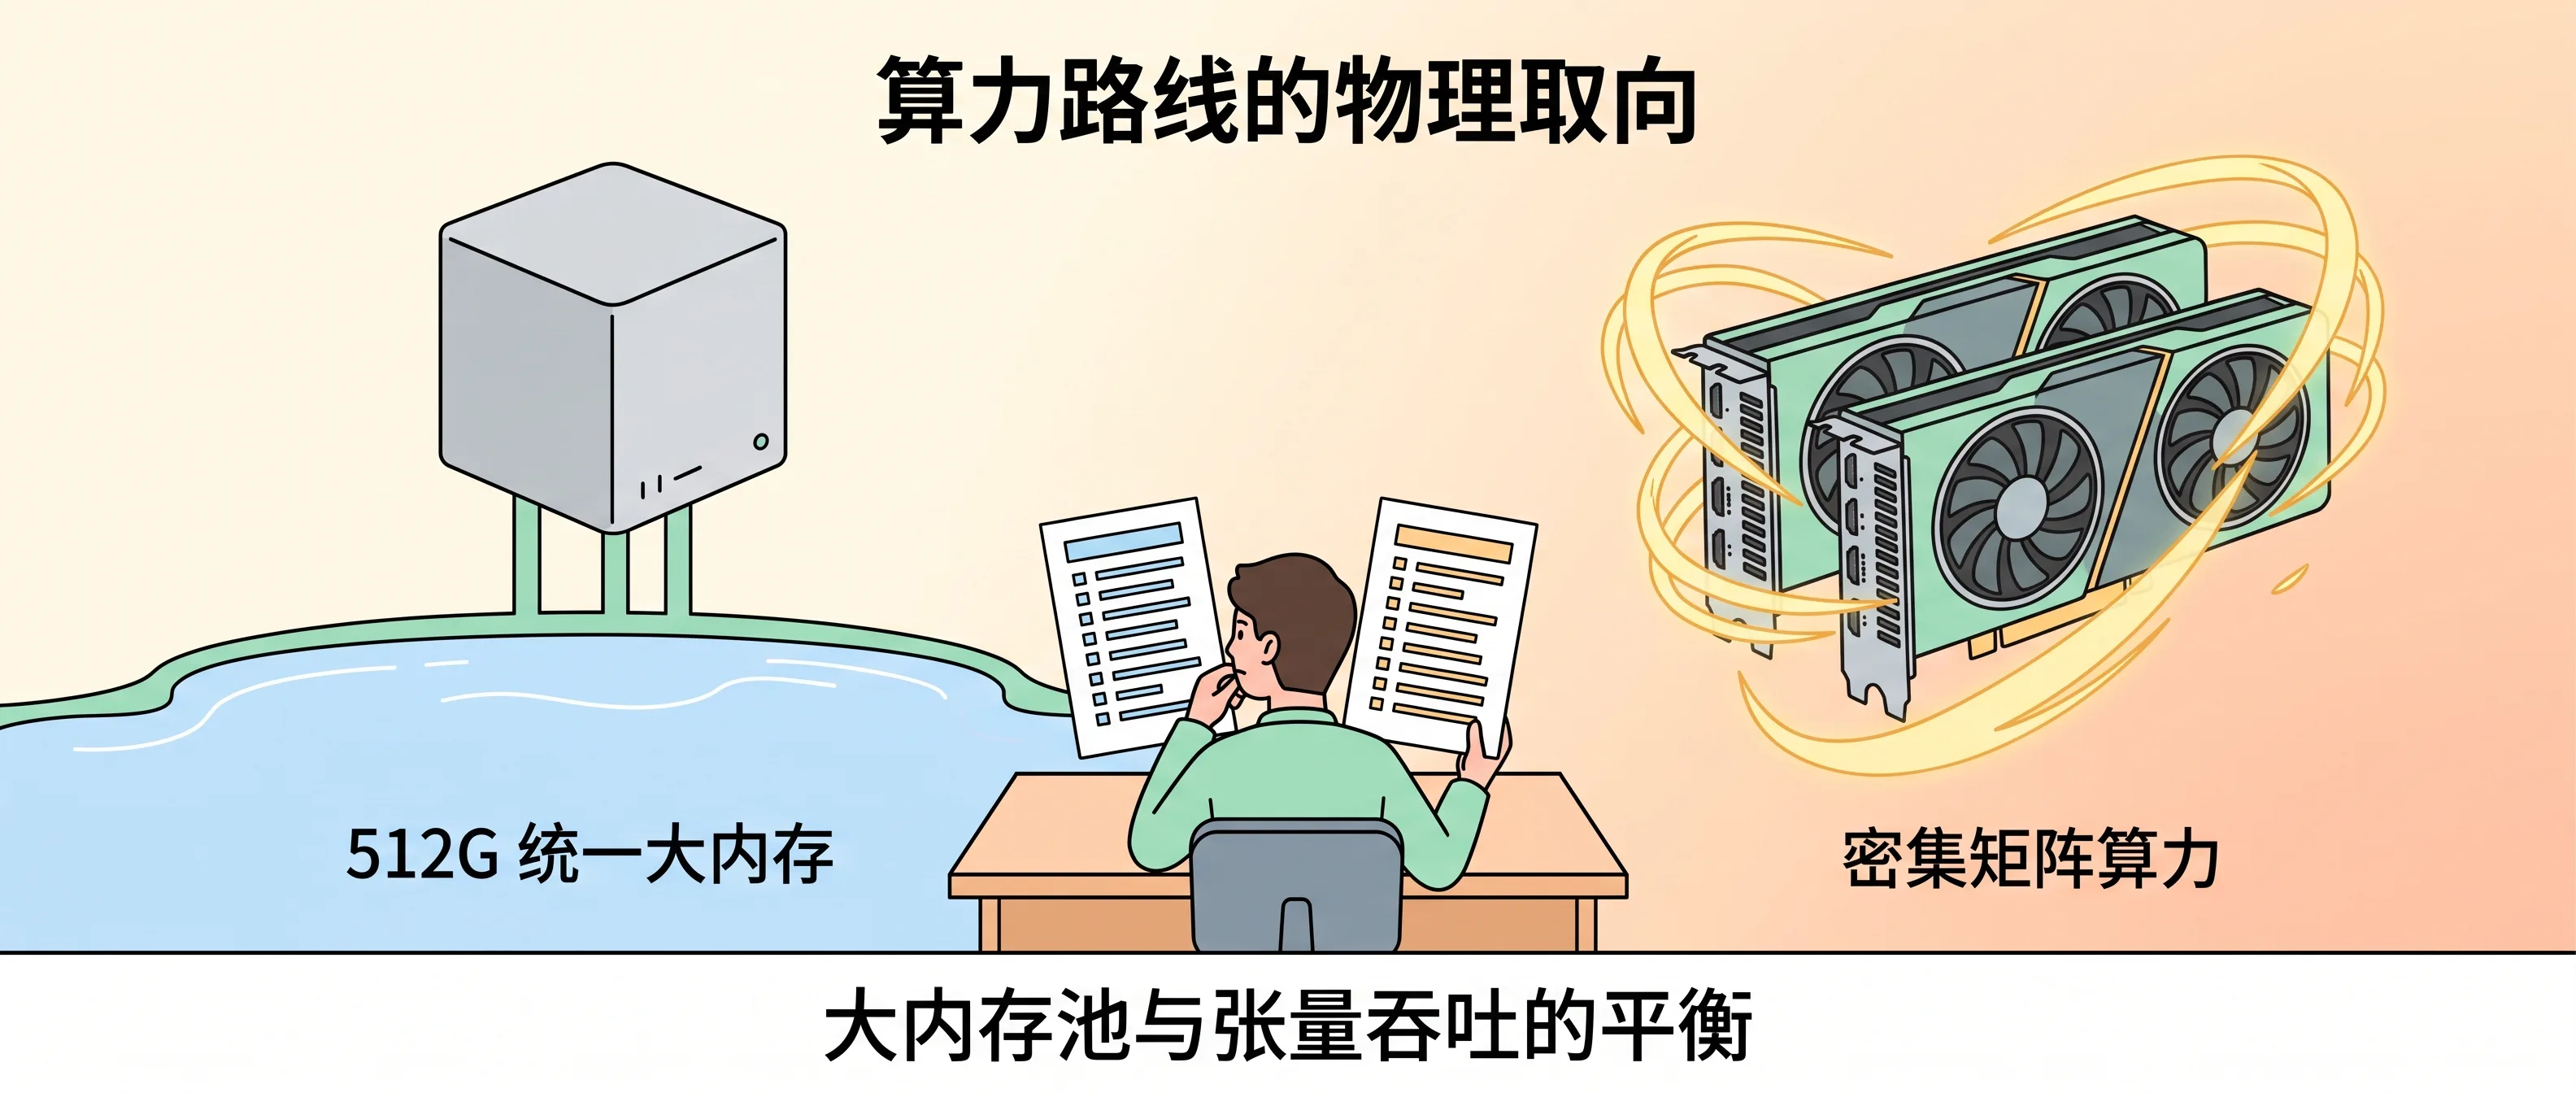
苹果统一内存的优点很直观。显存和内存合并在一起,模型权重一口吞下,不需要费心思去写张量切分代码。整机两百瓦的功耗,深夜跑长任务听不见风扇响。
它的短板也摆在台面上。面对高并发训练和密集的通用矩阵运算,苹果自研 GPU 的浮点吞吐依然追不上英伟达的高端芯片。很多算法库第一优先级适配 CUDA,苹果平台往往要等开源社区慢慢跟进。
要是手里的 Mac 能直接插上一张英伟达显卡,很多人就不用在系统和算力之间来回二选一了。
苹果关上英伟达的大门,到现在整整过去了六年。
正当所有人都觉得这两条路线老死不相往来的时候,GitHub 上冒出了一个叫 nullmoth/nvidia-macos-driver 的开源项目。
沉寂六年的铁板,被撬开了一道缝隙。
迟到六年的连接:现代显卡如何在 macOS 重新点亮
从 macOS 10.14 Mojave 之后,苹果系统就抹掉了英伟达显卡的原生驱动支持。
图灵、安培、Ada Lovelace,再到刚推出的新架构,在 Mac 用户眼里全都成了另一个机箱里的零件。
nullmoth 针对安装 macOS 15 Sequoia 系统的 Intel 处理器电脑和 OpenCore 黑苹果设备,重新搭建起图形转译管线。
从 GTX 16 系列一直到最新的 RTX 50 系列,显卡插在主板上,系统顺利认出型号,支持系统界面渲染,并直接运行 Metal 3 与 Core ML 计算任务。
这套工程的搭建路线非常清晰:
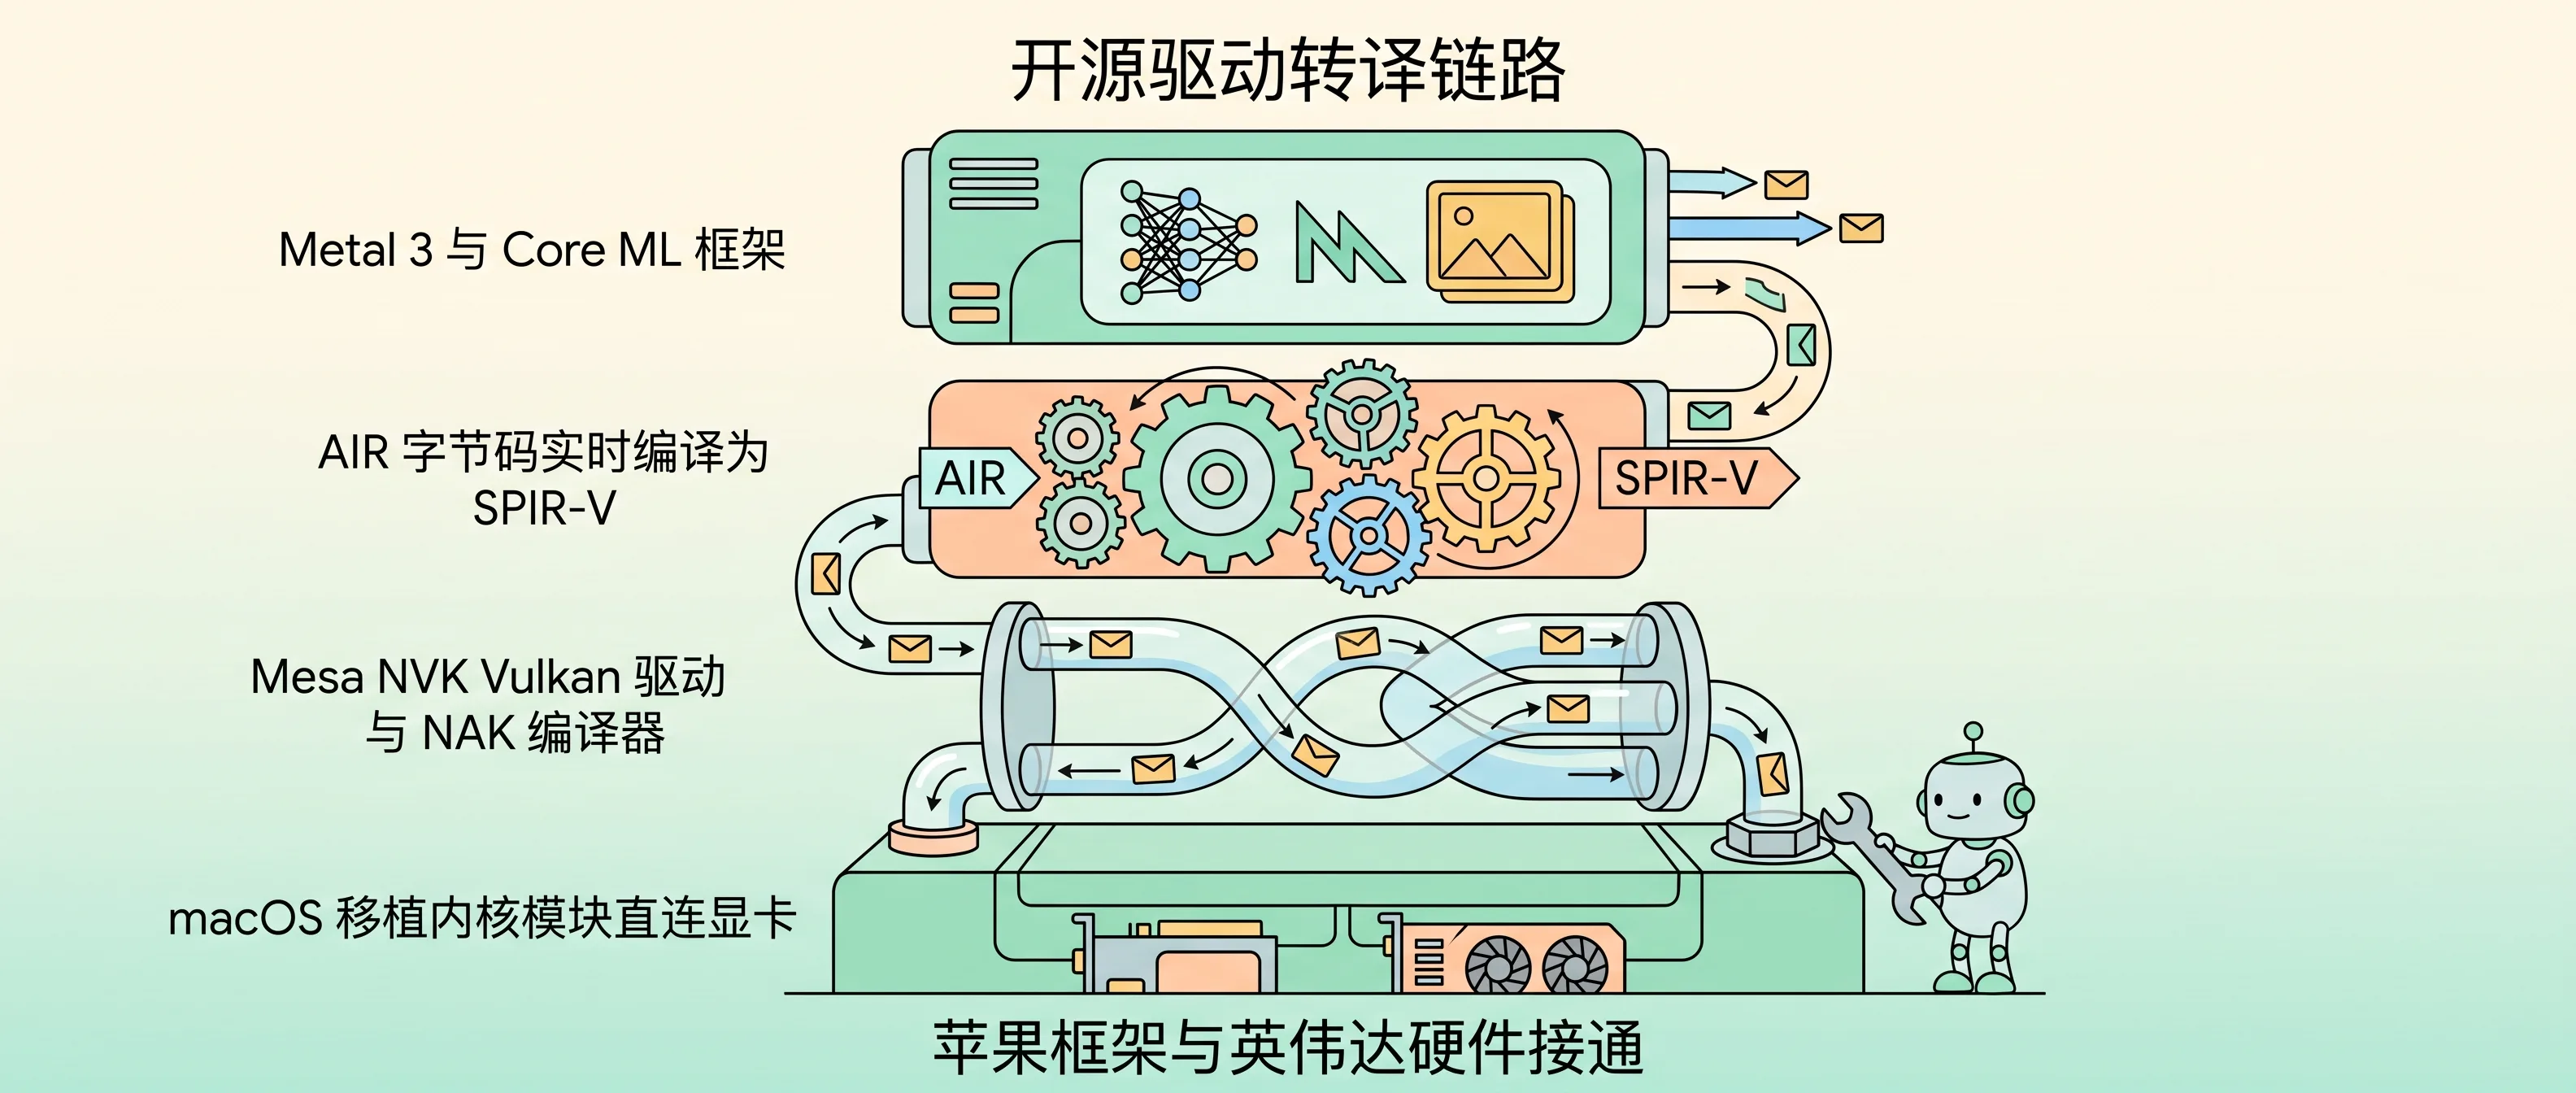
首先是内核底层的接管。作者把英伟达官方开源的 GPU 内核驱动(r610 分支)移植到了 macOS 内核中,编译出 NVRM、NVAccel、NVRMFB 和 NVRMAGDC 四个内核扩展模块。这几个模块负责最基础的硬件自检、电源管理、显存映射以及 PCIe 通道通信,让操作系统能够直接摸到底层硬件。
其次是用户态驱动的搭配。项目直接引入 Mesa 开源图形库里的 NVK 驱动,在英伟达现代显卡上提供标准的 Vulkan 指令支持。
再往上是整个项目最具技术含量的一环:着色器跨界转译。苹果系统里的图形和计算任务由 Metal 接管,输出的是苹果私有的 AIR 字节码。项目团队写了一个名为 libnvmtl_translate 的转译动态库,在内存中动态拦截 AIR 字节码,实时翻译成工业通用的 SPIR-V 格式,再灌给 Mesa 的 NAK 编译器去生成显卡执行指令。
最上层是系统组件的桥接。项目将这些逻辑整合成一个安装在系统 GPU 目录下的驱动包。在 WindowServer 界面合成器、Metal 3 甚至 Core ML 看来,底层就像连接着一块原生的苹果加速卡,光线追踪、网格着色器以及 MetalFX 超分辨率等特性都能顺畅跑通。
为了省去繁琐的手动命令,作者还写了一个叫 1401 的 Mac 辅助工具。这个工具自动扫描机器的 OpenCore 引导配置,配置好系统 NVRAM 参数,开启 8GB 大小的显存寻址窗口,重启之后显卡就能接管屏幕输出。
为什么在当下成真:AI 正在打通闭源系统的围墙
稍微接触过操作系统和驱动开发的人都清楚,逆向工程的工作量有多大。
苹果的图形堆栈没有开放文档,AIR 字节码规范并不公开,动态库里塞满了经过混淆的二进制符号。
换在几年前,要完成这样一套跨系统转译,需要一支懂汇编、懂编译器、懂微架构的资深工程团队,关起门来死磕一两年。
nullmoth 之所以能在当下由小团队推进完成,底层的工具链发生了剧烈变化。
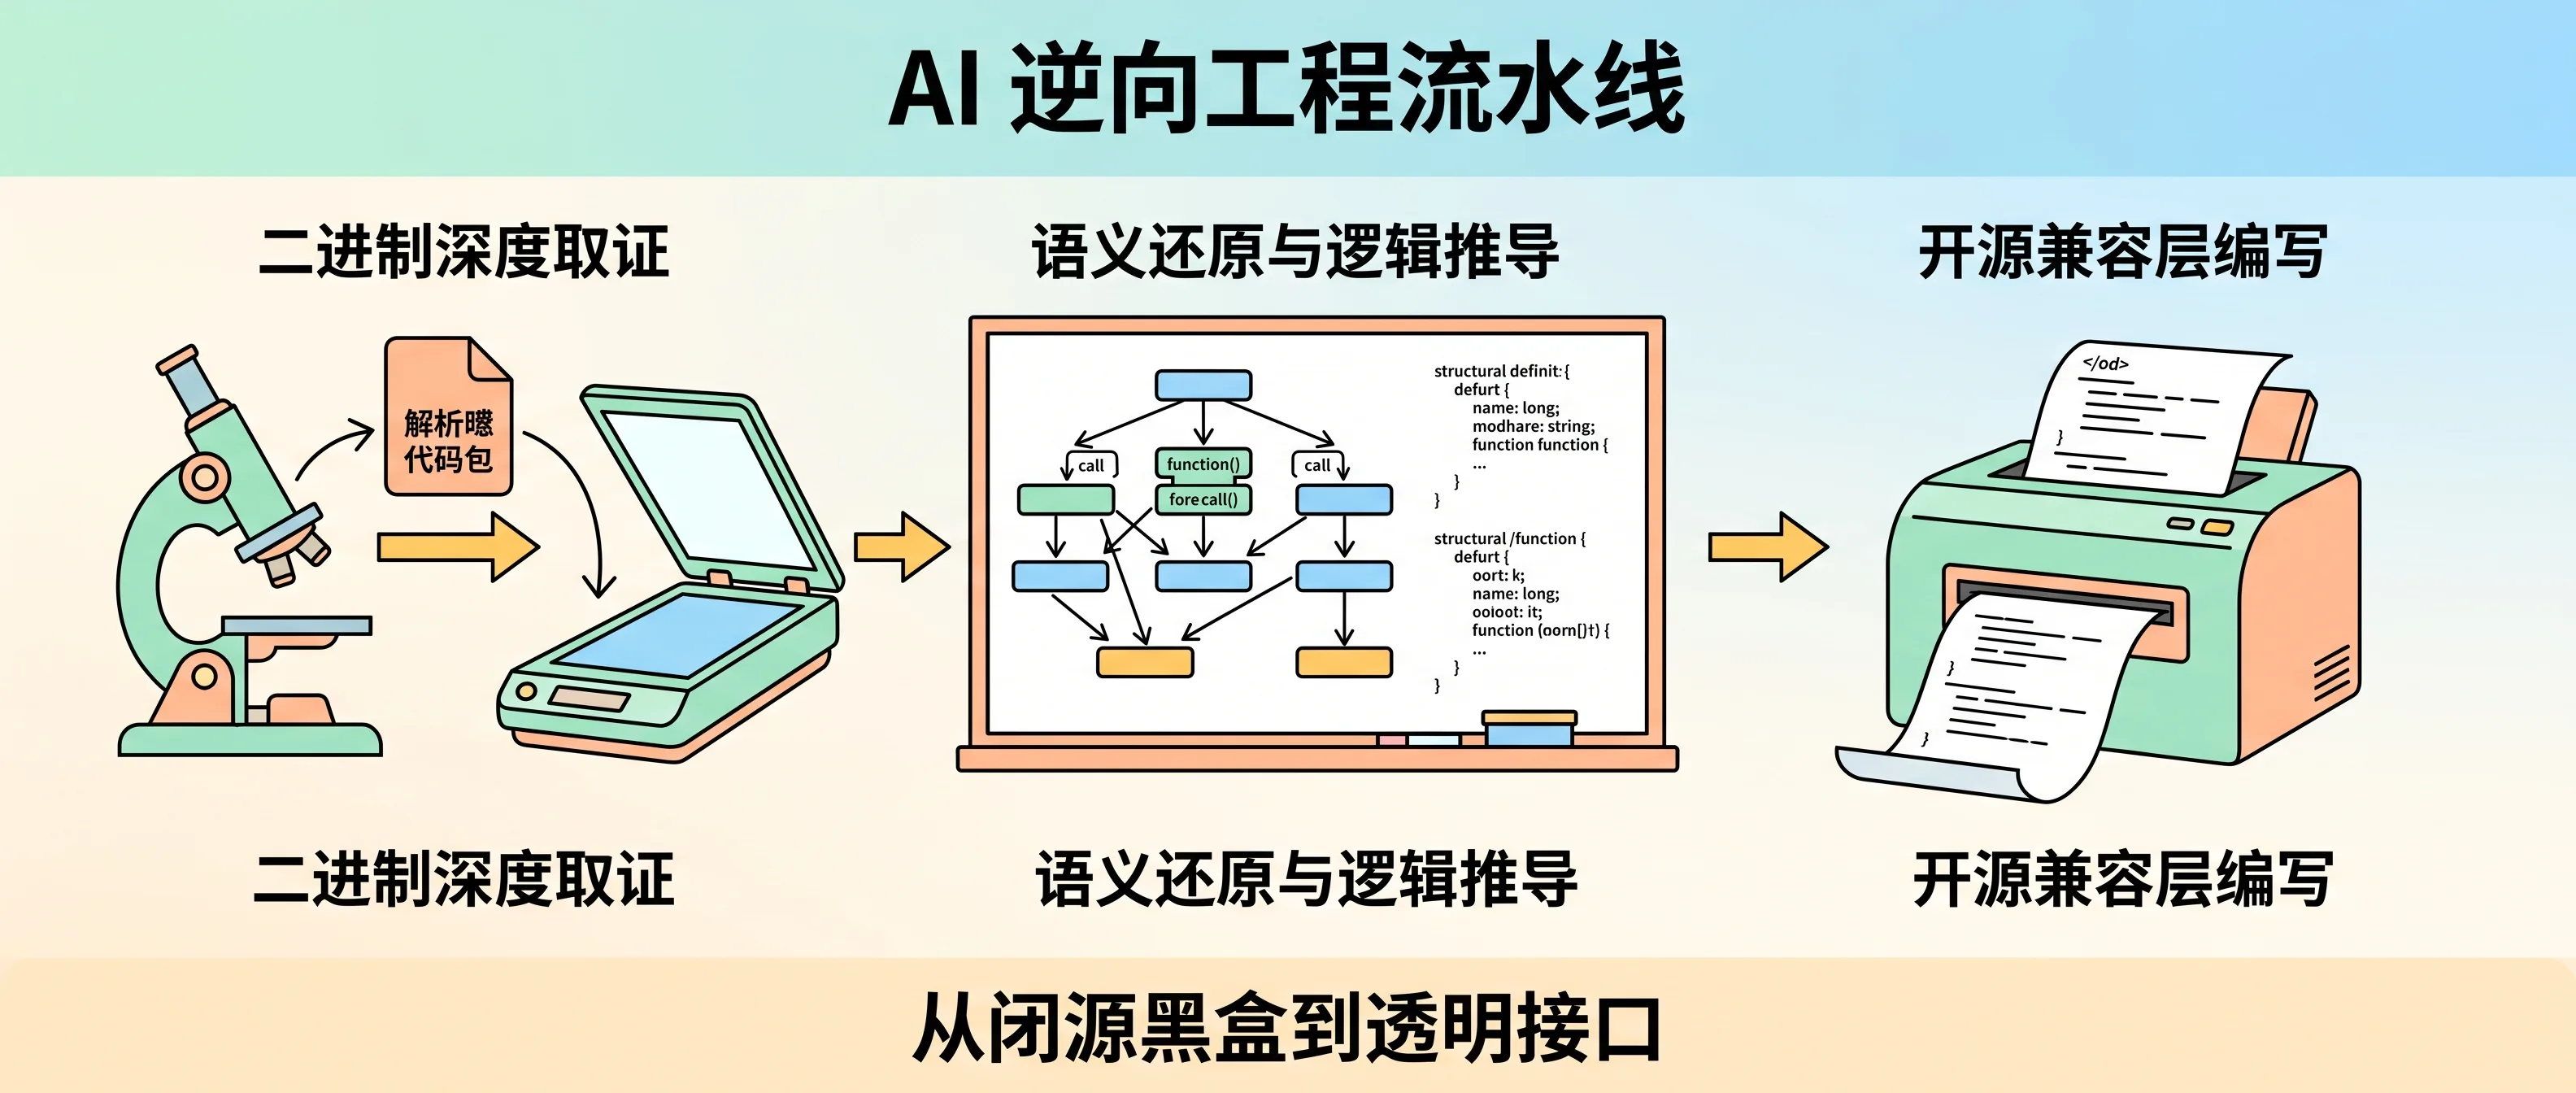
最近 GitHub 上出现了一个叫 morluto/rea 的开源项目。
它是一个专为编码 Agent 设计的模型上下文协议工具。
以往我们让 AI 参与逆向,模型只能看公开的技术手册或者干瘪的反编译文本,稍微遇到未导出的结构体就会胡乱猜测。
rea 直接把 AI 代理与本地安装的 Hopper、Ghidra、IDA Pro 等专业逆向套件打通。
当遇到一个没有源码的商业动态库时,AI 代理可以通过本地协议自主触发反编译,读取函数交叉引用图,从机器码中梳理出虚函数调用表,推导内存对齐结构。
理清未公开接口的数据走向后,AI 代理直接按照开源规范写出功能对等的兼容代码,绕开版权争议。
这就是技术的奇妙之处。
商业公司出于生态利益建立起封闭的高墙,内部不开放接口与驱动。
在装配了逆向工具的 AI 面前,这些原本密不透风的二进制壁垒正在失去神秘感。只要系统对外提供服务、只要机器指令在内存里运行,AI 就能顺着调用轨迹抽丝剥茧,从外部将闭源系统打通。
软件开发没有完,大爆发才刚刚拉开序幕
行业里常能听到一种疲惫的论调:移动互联网过去了,该写的软件都写完了,未来只有几个大模型底座值得投入。
每次看到这种说法,我都觉得结论下得太草率。
过去的软件开发之所以让人觉得停滞,是因为工程阻力太大。
大厂商为了圈住用户,人为构筑了各种封闭规范。开发者想把两套优秀的工具串联起来,往往需要耗费数月去写琐碎的适配层,最终因为精力和成本放弃。
无数精妙的想法,就这么被卡死在兼容性的泥潭里。
现在我们站在了意图编码(vibe coding)与 AI 逆向交汇的节点上。
开发者的角色从打字员变成了意图的发起者。你只需要清楚系统之间该如何配合,AI 就能帮你去翻底层的反编译指令,去对齐内存结构,去搭起原本无人问津的跨平台管道。
生态之间的摩擦力正在降到极低的水平。
曾经因为商业竞争老死不相往来的硬件与系统,被个人开发者用几千行转译代码接通。
那些躺在企业仓库里的老旧设备,正在被重新写出的轻量驱动赋予现代计算能力。
你很难预测接下来会有谁,带着明确的想法,vibe 出怎样让人惊叹的软件组合。
这绝对不是软件开发的黄昏。
相反,当封闭高墙被技术工具一块块敲碎,软件的大爆发才真正开始。
回到最开始的问题:手里的预算,到底投给 M5 Ultra 还是英伟达?
如果你要的是省心,要的是书桌上一台安静运行、能吃下 400B 模型的极简工作站,M5 Ultra 依旧是免去多卡拼装烦恼的选择。
但如果你热衷于折腾底层,或者手头有一套现成的 Intel 架构老设备与英伟达显卡,这条开源驱动路线提供了一个完全不同的观察视角。
硬件的规格由厂商定义,但软件的生命力永远属于动手解决问题的人。
只要有好奇心,技术的大门总会向你敞开。
 面试了一批 AI Agent 工程师后,我想说几句真话