大家好,我是 Jason。
北京时间今天凌晨 00:04,Sundar Pichai 和 Google DeepMind 同步发帖,宣布 Gemini 4 Argon 全量上线。
我点开 Sundar 的推文,浏览量刚过 4 万。这会儿去评论区回一句,最容易排在前面。
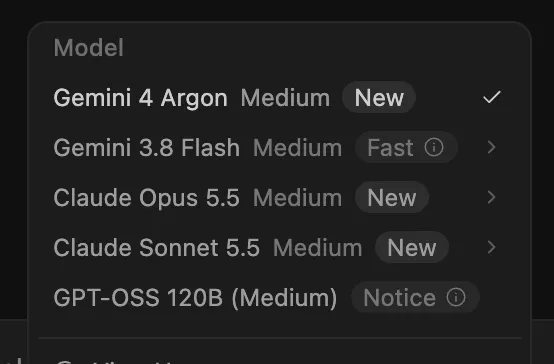
切回手头的 Antigravity 编辑器,点开顶部的模型菜单,Gemini 4 Argon Medium 后面已经挂上了 New 标签。我顺手勾选,菜单里往下依次排着 Gemini 3.8 Flash、Claude Opus 5.5 和 Claude Sonnet 5.5。
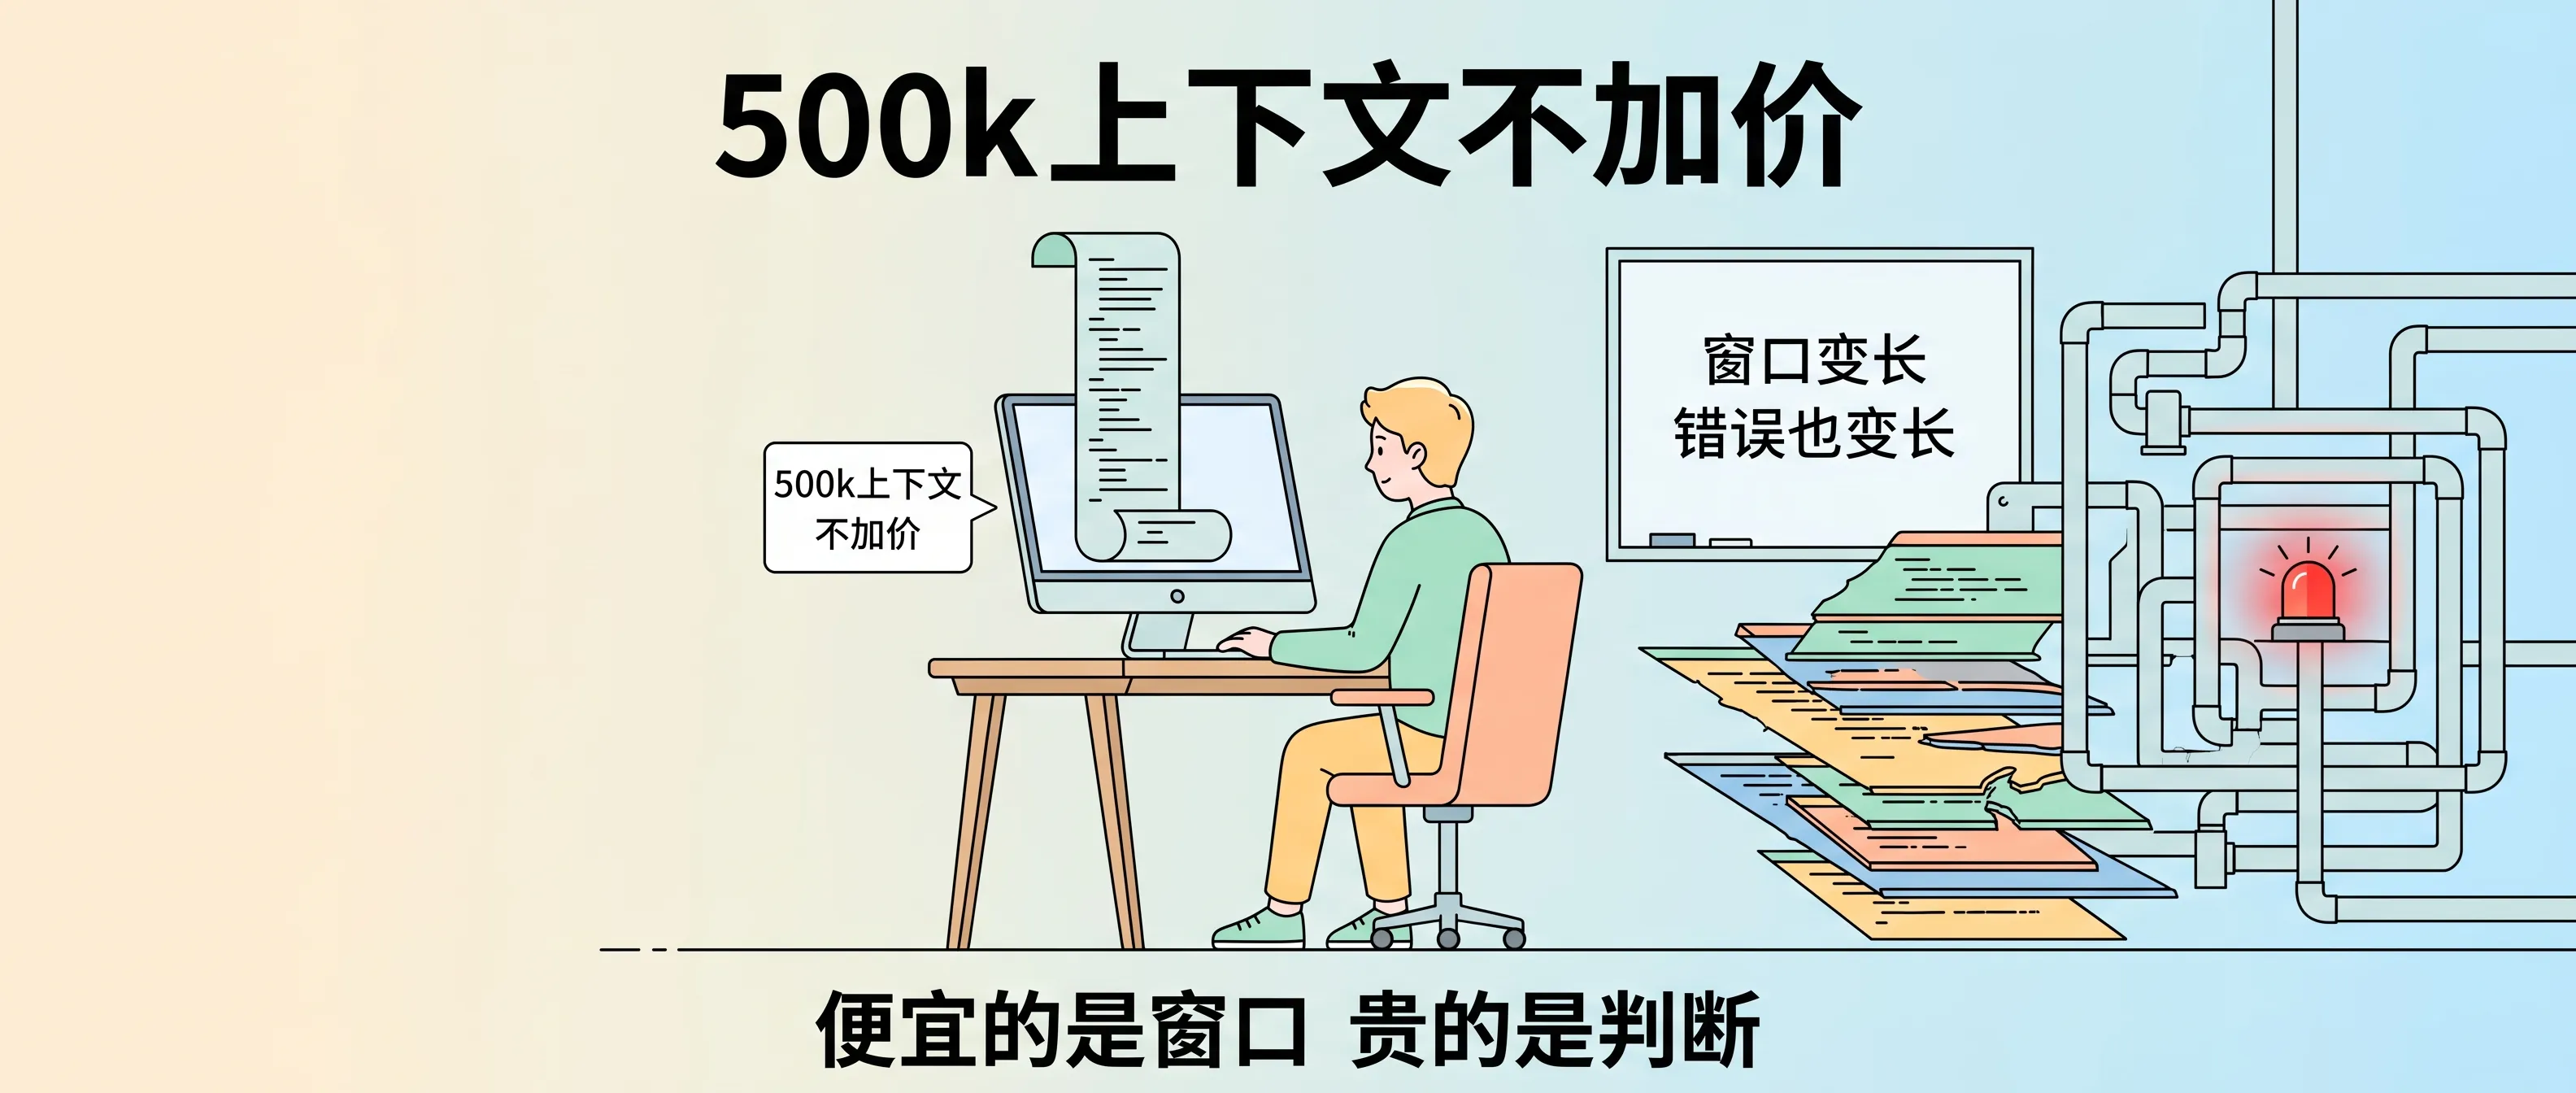
前天我写了 《Codex 上下文翻到 500k 不加价,我反而更怕了》,聊 OpenAI 怎么拿 500k 默认输入窗口圈住重度开发者。
隔了一天,Google 换了个方向出牌。
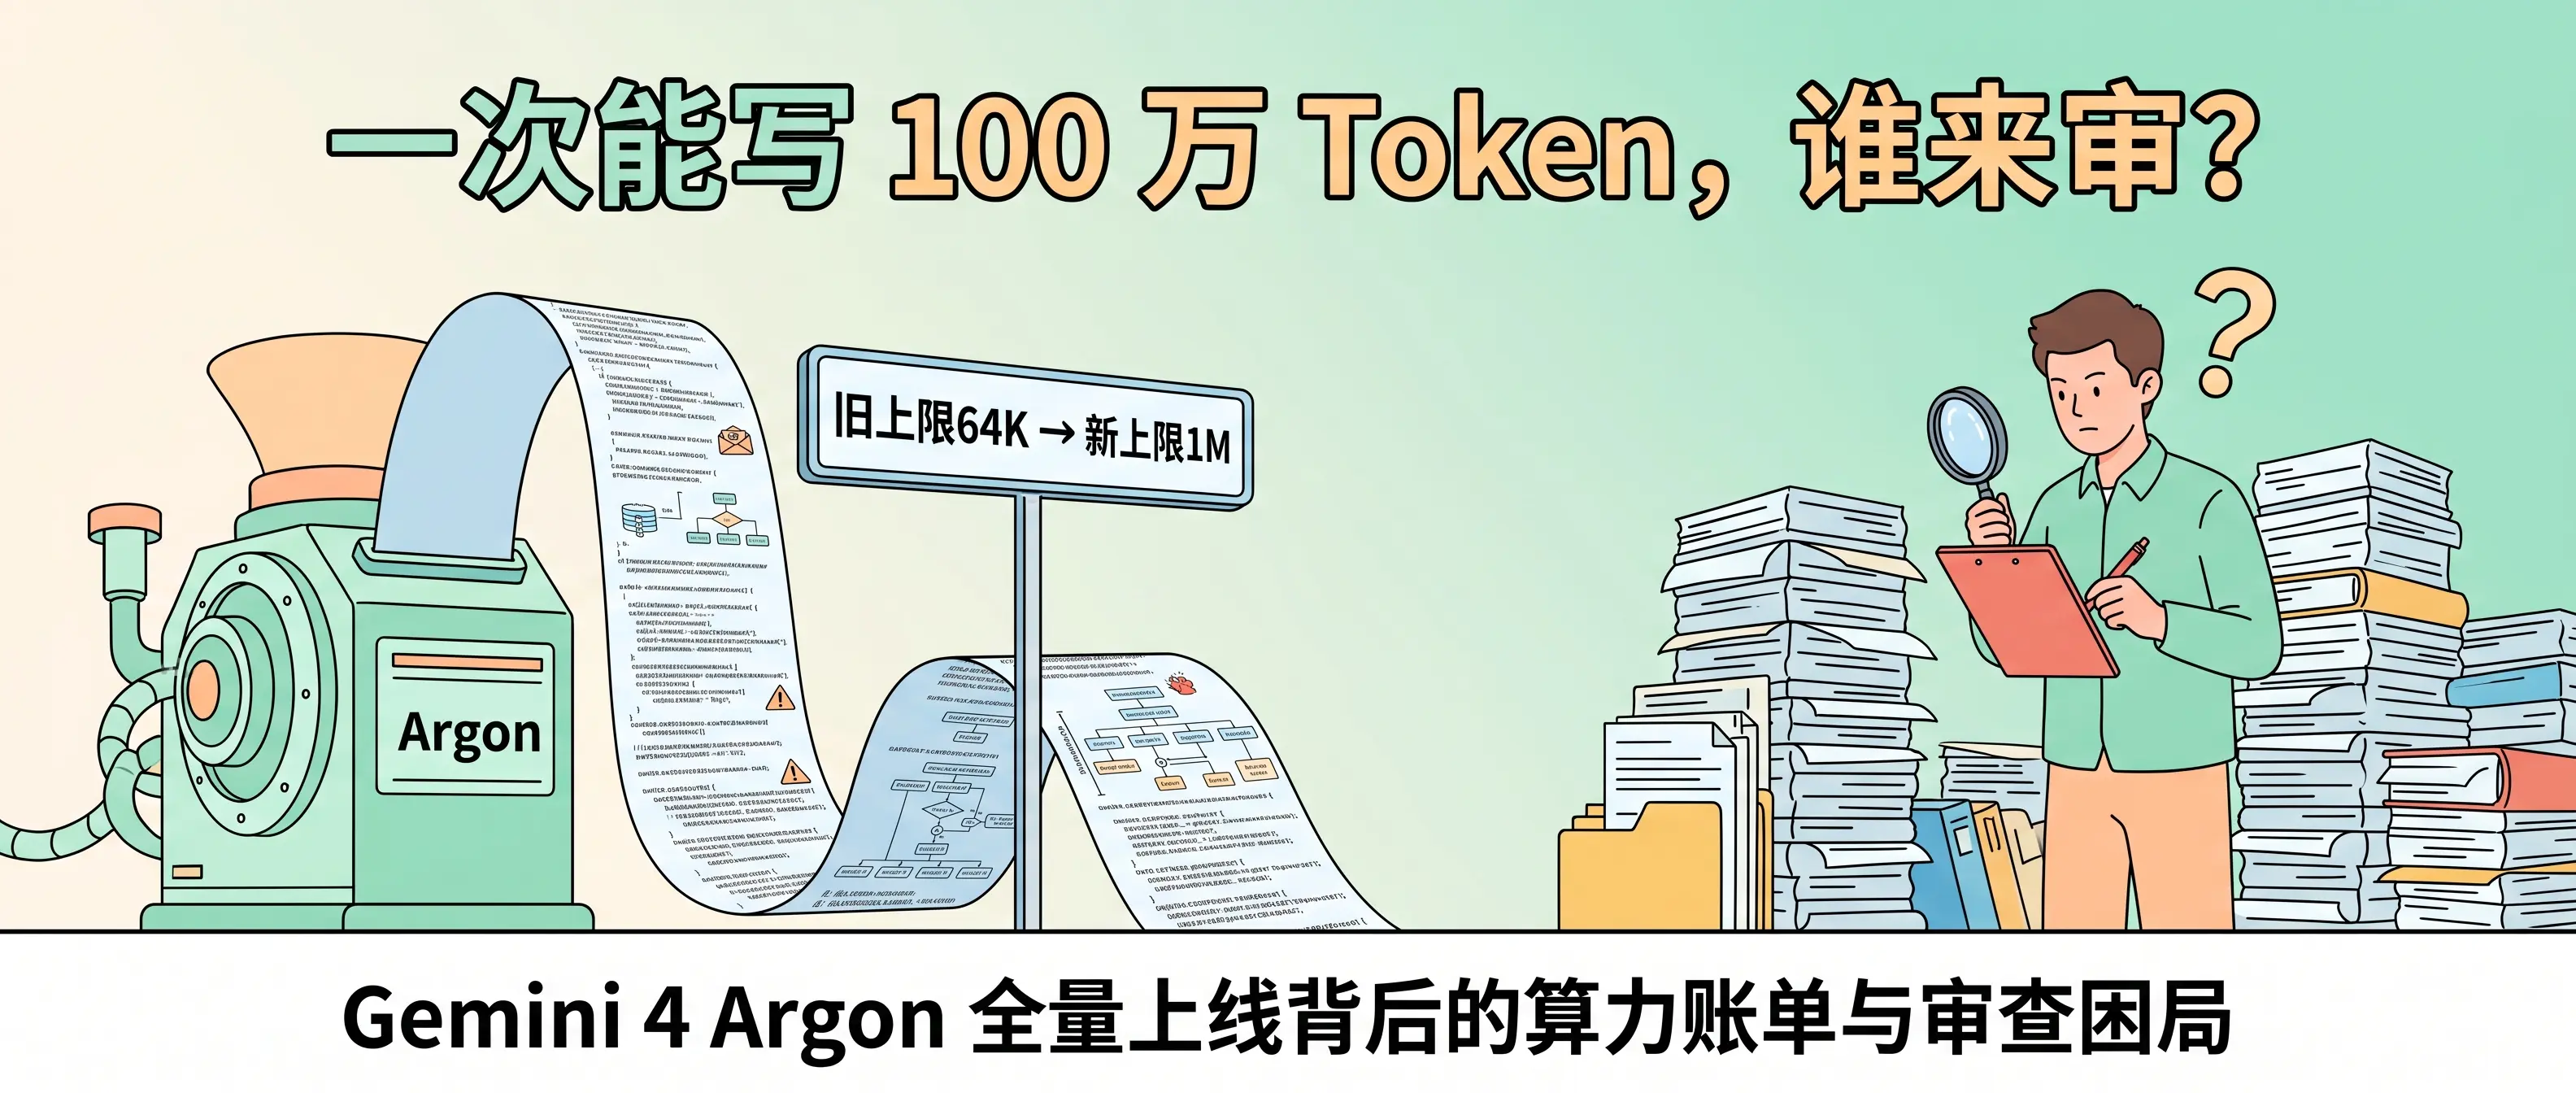
它这次主推单次 100 万 Token 输出。以前模型输出上限卡在 64K,现在直接翻了 16 倍,主打长时间写代码、自主 Agent 和网络安全。
权限分级与 12 月翻倍的账本
先把使用渠道和价格账本摆在桌面上。
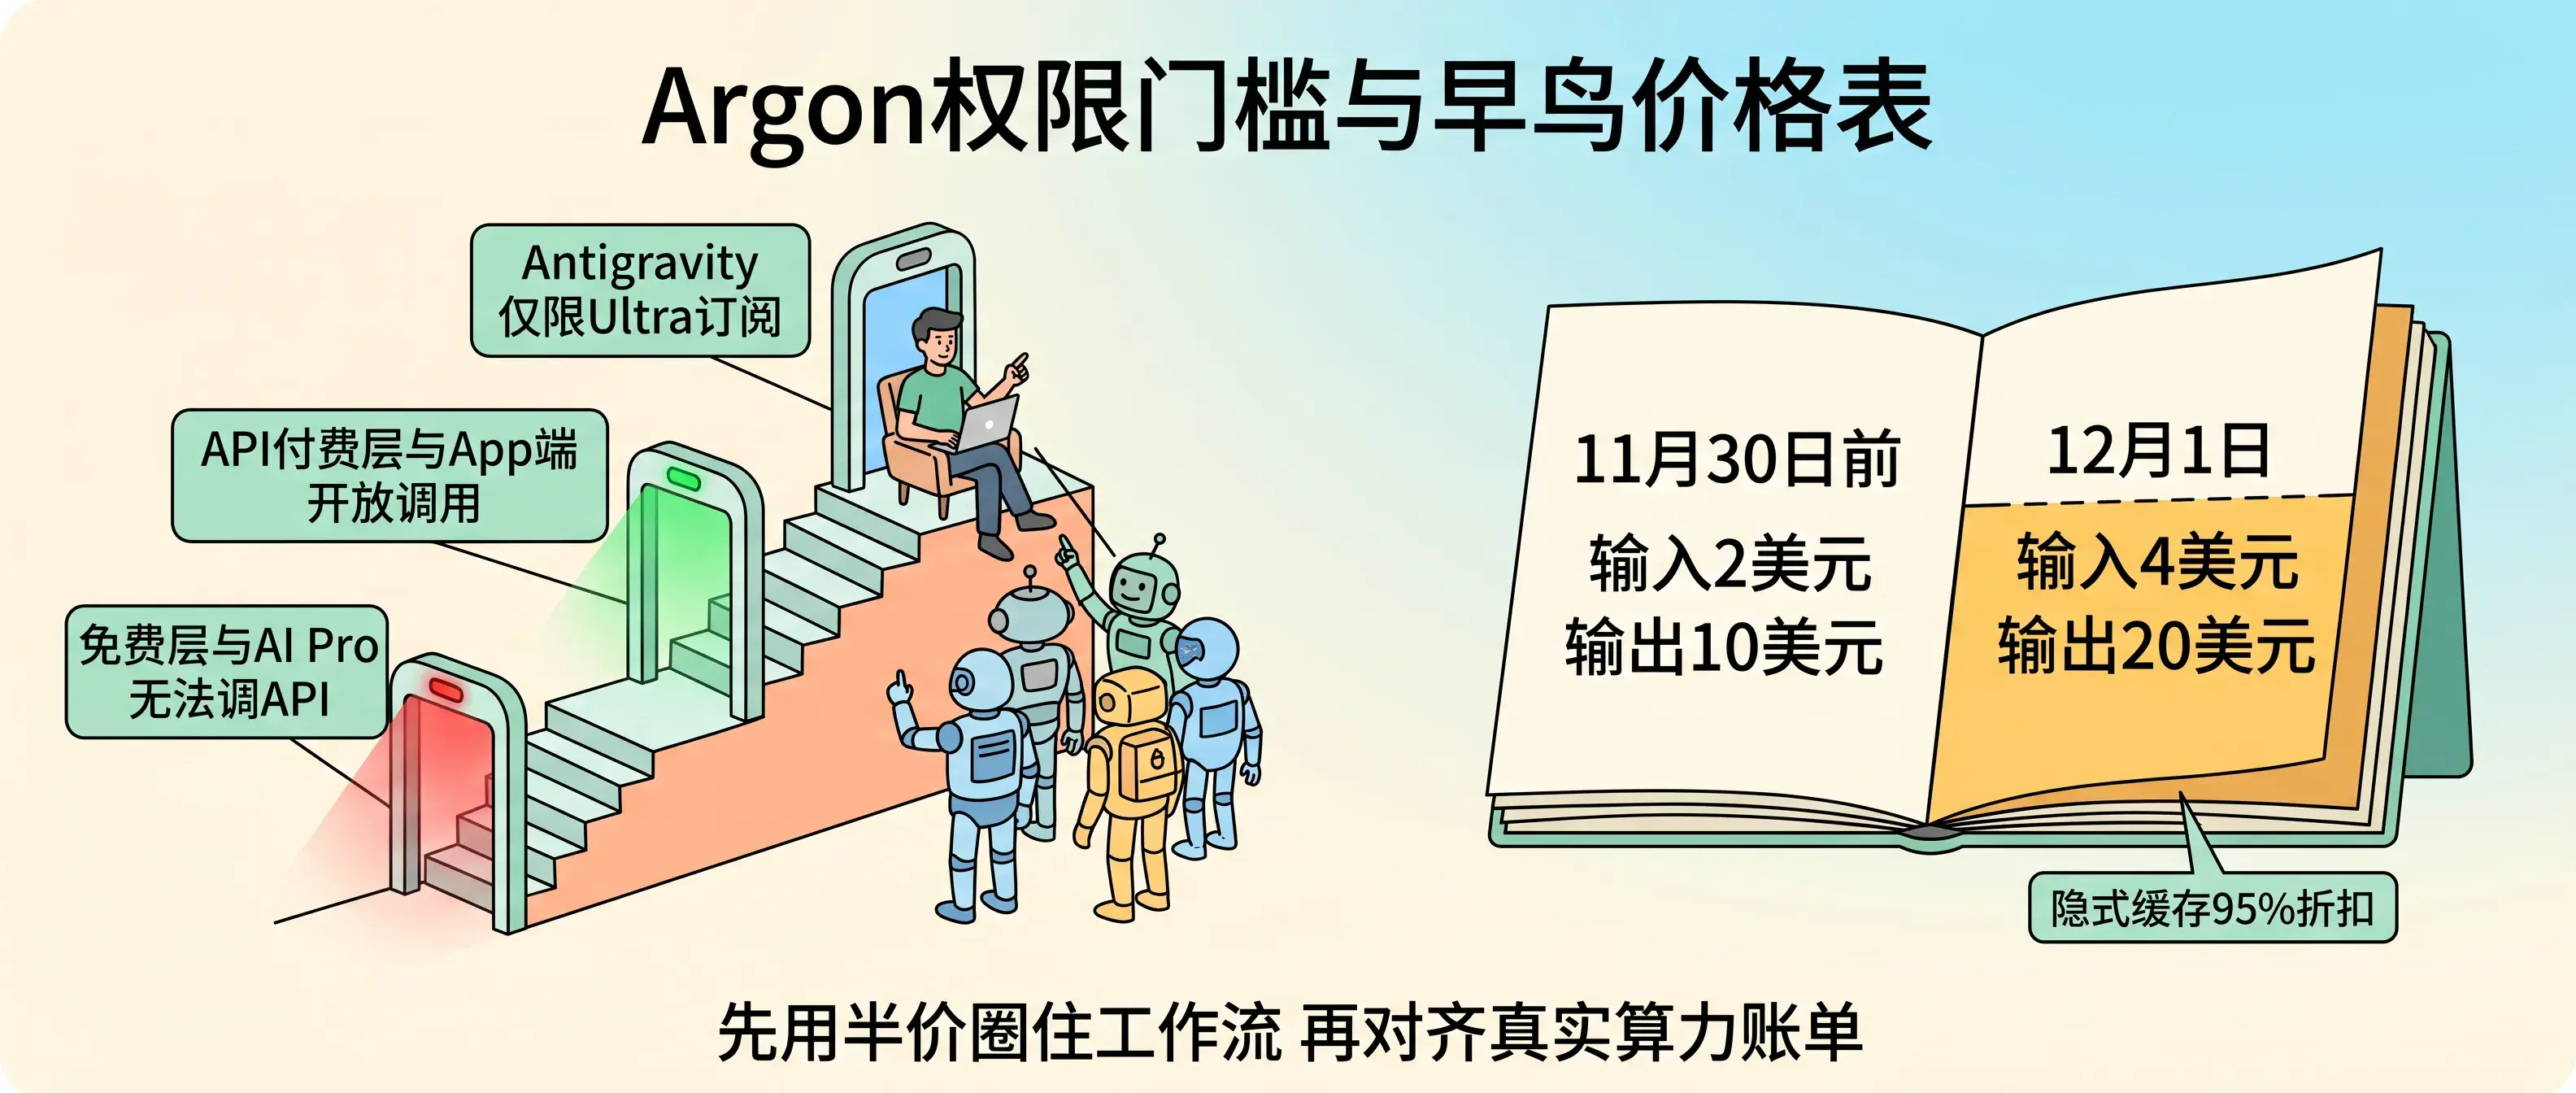
Google 这次把访问门槛切得很清爽:
- 调用 API:付费开发者现在就能直接调。免费层用户和每月 20 美元的 AI Pro 订阅者,调不了它的 API。
- 日常聊天:Gemini App 和搜索 AI 模式里,Pro 和 Ultra 订阅用户都能直接用。
- 写代码环境:我在月初那篇工具箱文章里聊过的 Antigravity,这次只对每月 200 美元的 Ultra 用户开放 Argon。另外 Google 拿出 10,000 个名额,给全球科研人员免费开半年最高配额。
- 无护栏安全版:搞网络安全防守的研究员,可以通过 Fairwind 计划申请没有安全护栏的专属版本。
再看价格账单。
11 月 30 日前执行早鸟特惠价,每百万 Token 输入收 2 美元,输出收 10 美元。
12 月 1 日起价格原地翻倍:每百万 Token 输入涨到 4 美元,输出涨到 20 美元。思考链占用的字数和联网搜索挂载的指令,全算在账单里。
省钱的口子留在缓存上。只要前面的内容有 6,144 个字以上没变,系统自动给 95% 折扣。早鸟期缓存输入每百万只要 0.10 美元,12 月调价后也才 0.20 美元。
这笔商业账算得很准。
留一个半月的半价窗口,把原本昂贵的高阶长输出模型压到 10 美元,吸引开发者把工作流搬过来。等你花一个月调顺提示词、工具调用和代码脚手架,12 月 1 日价格一涨,你的工程流已经焊死在上面了。
从 64K 到 100 万:像信使接力一样连续输出
以前用大模型写长任务,体验像一台容易卡纸的打字机。
哪怕模型能读懂几十万字输入,它的单次输出上限往往死死锁在 6.4 万 Token。代码写到一半突然卡住断行,你得手写一堆复杂的重试脚本去拼接上下文,拼上两次,模型的推理逻辑就散了架。
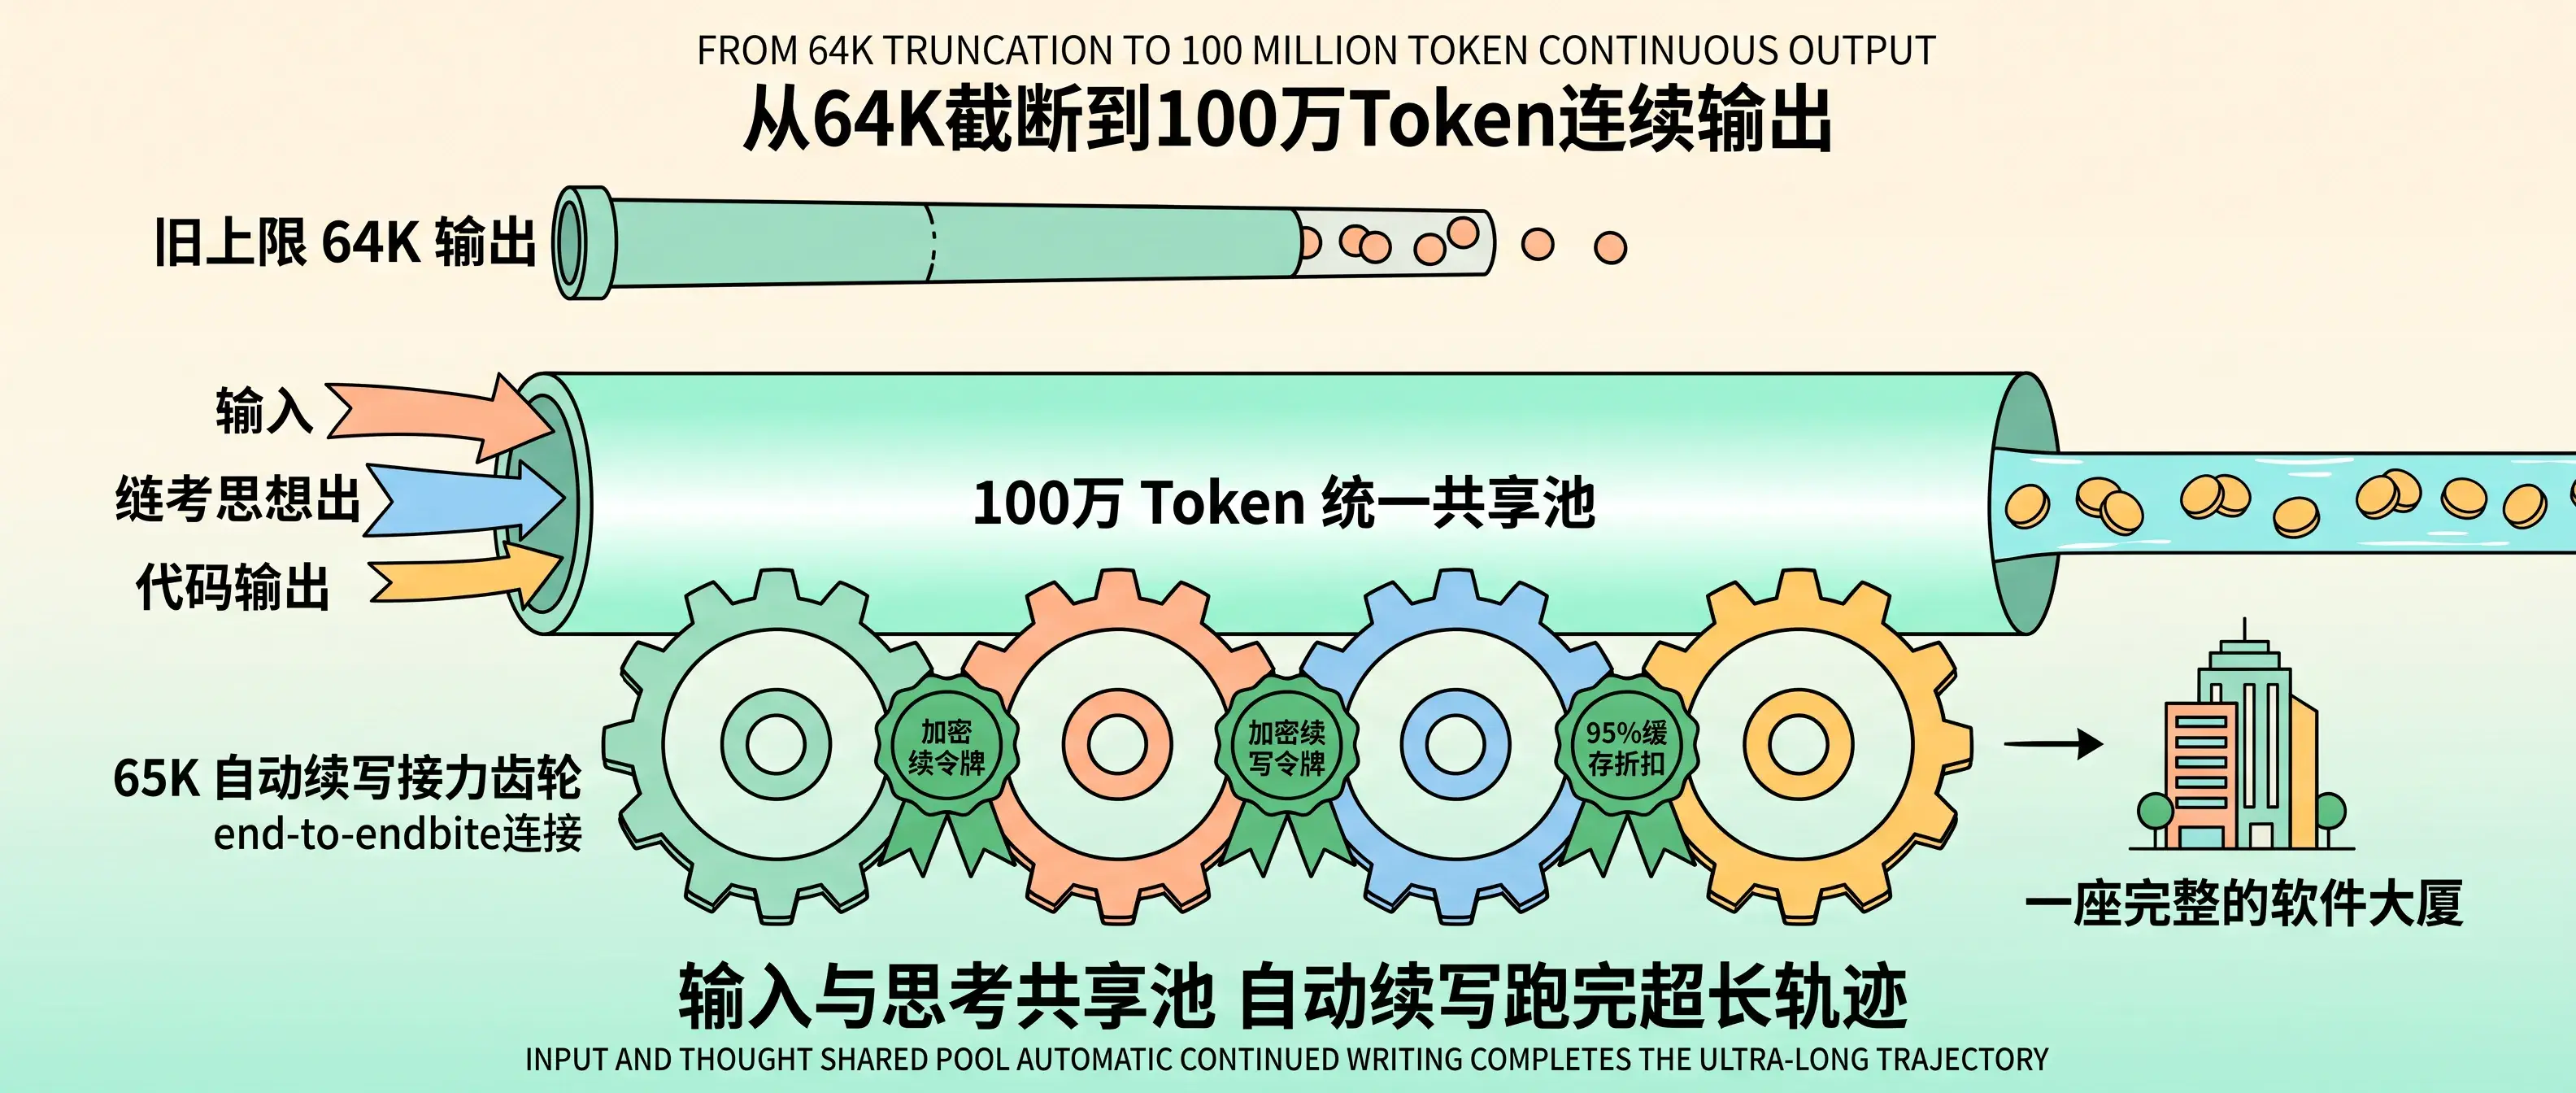
Argon 把输入、内部思考和代码输出放进了同一个 100 万 Token 的大水池。塞给它 10 万字需求,剩下的 90 万额度全留给模型自己一边推导一边写完。
网络连接怎么撑住这么长时间不超时?
Google 在底层安排了一队隐形信使。
单次请求有 20 分钟和 6.5 万 Token 的物理限制。当模型写满 6.5 万 Token 还没结束时,后台自动给下一棒递上一枚加密信封,带着前面的上下文继续写。
重新送回去的前序内容,正好享受到 95% 的缓存折扣。几棒接力跑下来,模型一气呵成写完一整套多文件工程,中间不再需要人工去修补断裂的上下文。
写 Agent 脚手架的开发者只要记住两点:旧版微调温度和思考字数的几个冷门参数直接作废,改用高、中、低三档思考开关;做上下文长度判断时,直接读取初始输入字数,避免把接力续写的段落重复算进去。
16 倍输出额度,拿去啃什么硬骨头
100 万 Token 的输出胃口,从来不是为了陪人闲聊准备的。
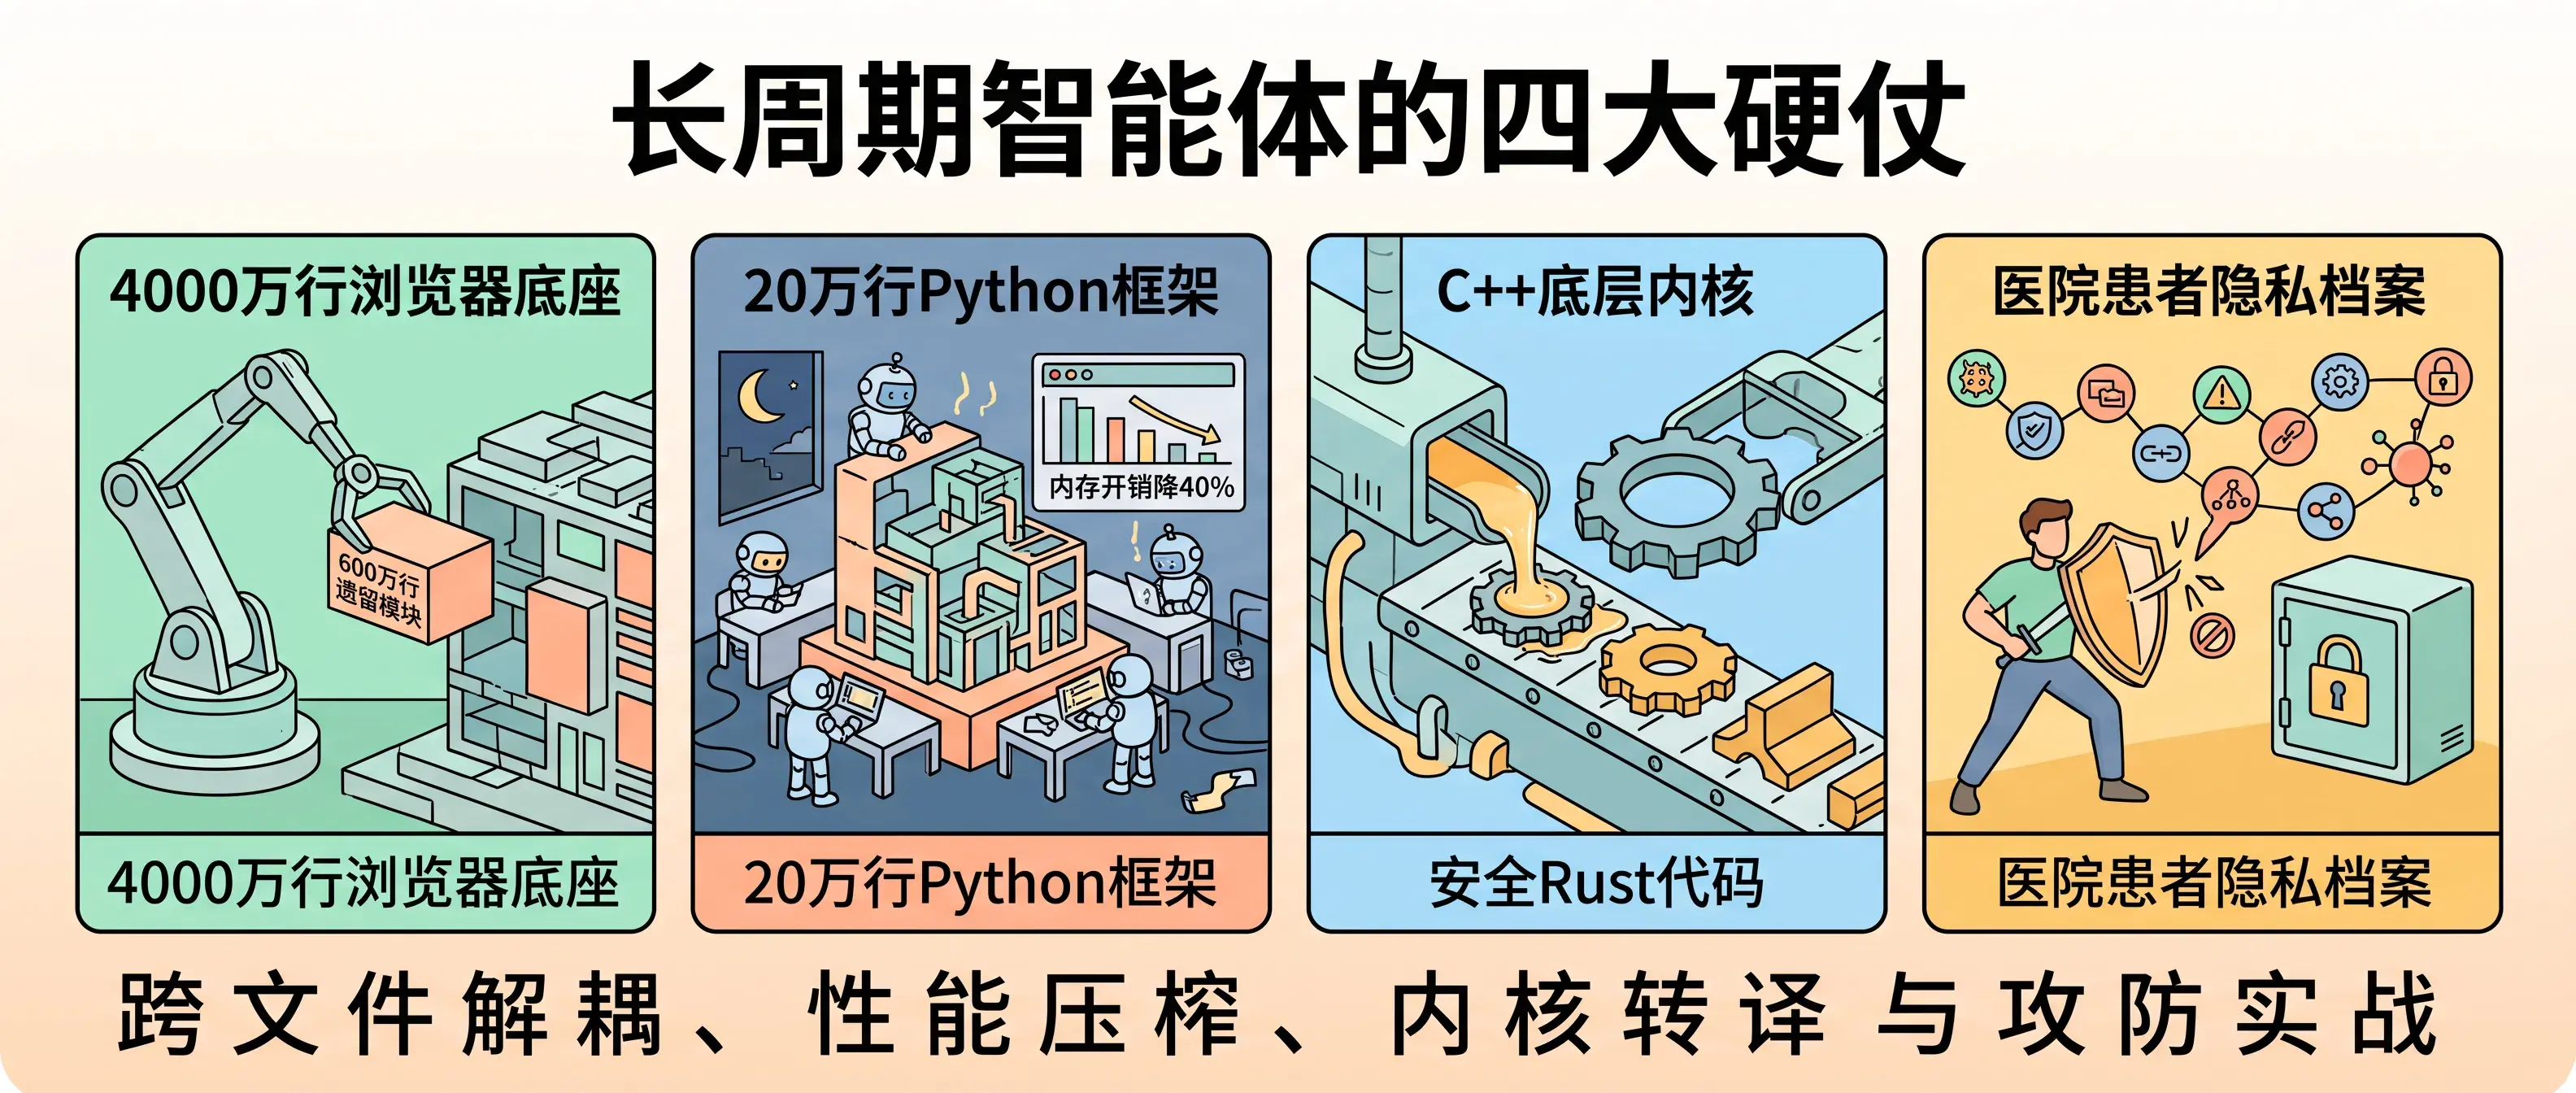
看看 Google 内部和合作团队跑出的几场硬仗,更能明白这 100 万输出用在了哪:
在 Chrome 4000 万行代码里抽积木。 Chrome 浏览器底层代码浩如烟海。团队让 Argon 去啃一个堆积了十几年的网页渲染老模块,里面足足有 600 万行代码。Agent 穿梭在几百个文件里理顺依赖关系,把原本要拖几个月的脏活压到几周搞定。改完后活动网页在标签页和侧边栏之间随意拖动不再重新加载,顺带消灭了一批闪退问题。
给 80 万行底层内核换上安全 Rust。 从日常使用的算法库,一路干到 80 万行以上的 Fuchsia 操作系统内核。在重写视频解码库时,Argon 盯着编译器的反馈反复试验,拆掉 3.2 万行手写的底层汇编,写出能让编译器自动加速的纯安全 Rust 代码,速度比原先的社区版本快了 2.7 倍。
单张显卡提速与省出海量服务器内存。 在普通计算卡上跑模型,Argon 几天内把推理吞吐速度推高接近三倍,改动直接合进了开源主流框架。另一组 Agent 扫描了整个数据中心的海量监控数据,揪出代码里的内存浪费,上线后直接帮服务器省出了几百 TiB 的内存空间。
顺藤摸瓜护住医院几十万份病历。 云安全公司 Wiz 拿它去真实网络做安全体检。Argon 把几个看似不起眼的小漏洞串成完整的攻击链,挖出一个此前所有模型都漏掉的文件下载漏洞。那个漏洞一旦被黑客抓住,管理员权限直接失守。补丁火速打上,保住了全球多家医院里几十万名病人的隐私档案。
一次能写 100 万 Token,谁来审这 100 万 Token?
看完这些实战,最让我后背发紧的问题浮了上来。
100 万 Token 到底有多少?
折成中文大约六七十万字,够印三本厚书;折成代码足有 8 万到 10 万行,顶得上一家中型软件公司两三年攒下的全部家底。
按 11 月底前的特惠价算,输出 100 万 Token 只要 10 美元。
花 70 块钱人民币,睡前敲个回车,第二天醒来,你的代码仓库里就凭空多出十万行新代码。
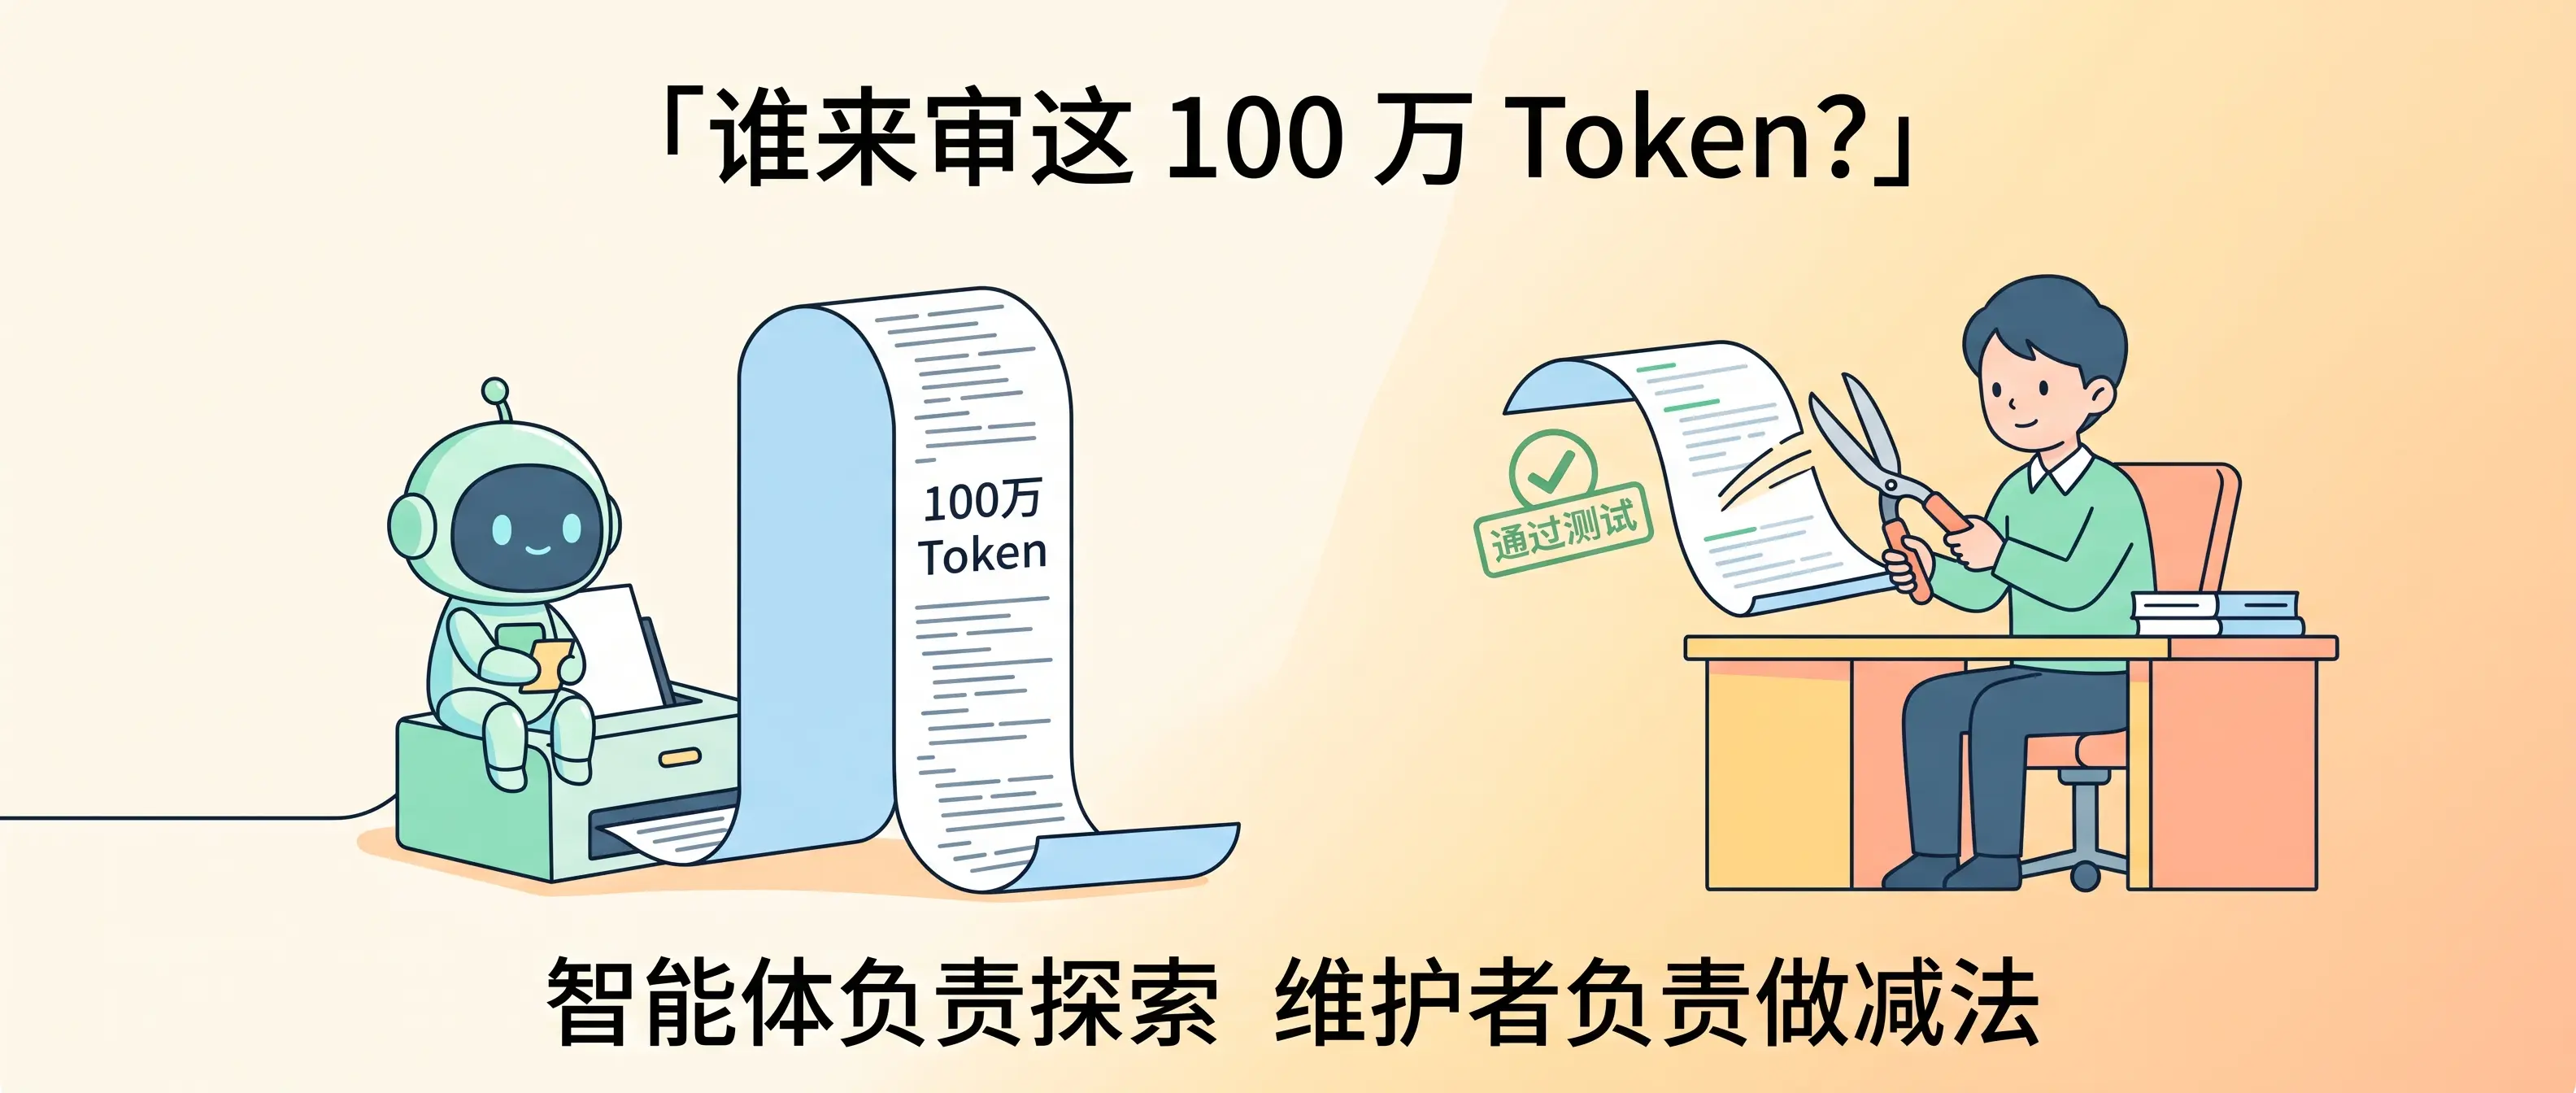
它花 10 美元写完了,谁来审这 100 万 Token?
前天聊 Codex 500k 输入窗口时我写过:窗口变长,错误路径同步拉长。今天输出端推到 100 万,我们面对的是另一种窒息:机器倾泻代码的速度,彻底击穿了人类肉眼的阅读极限。
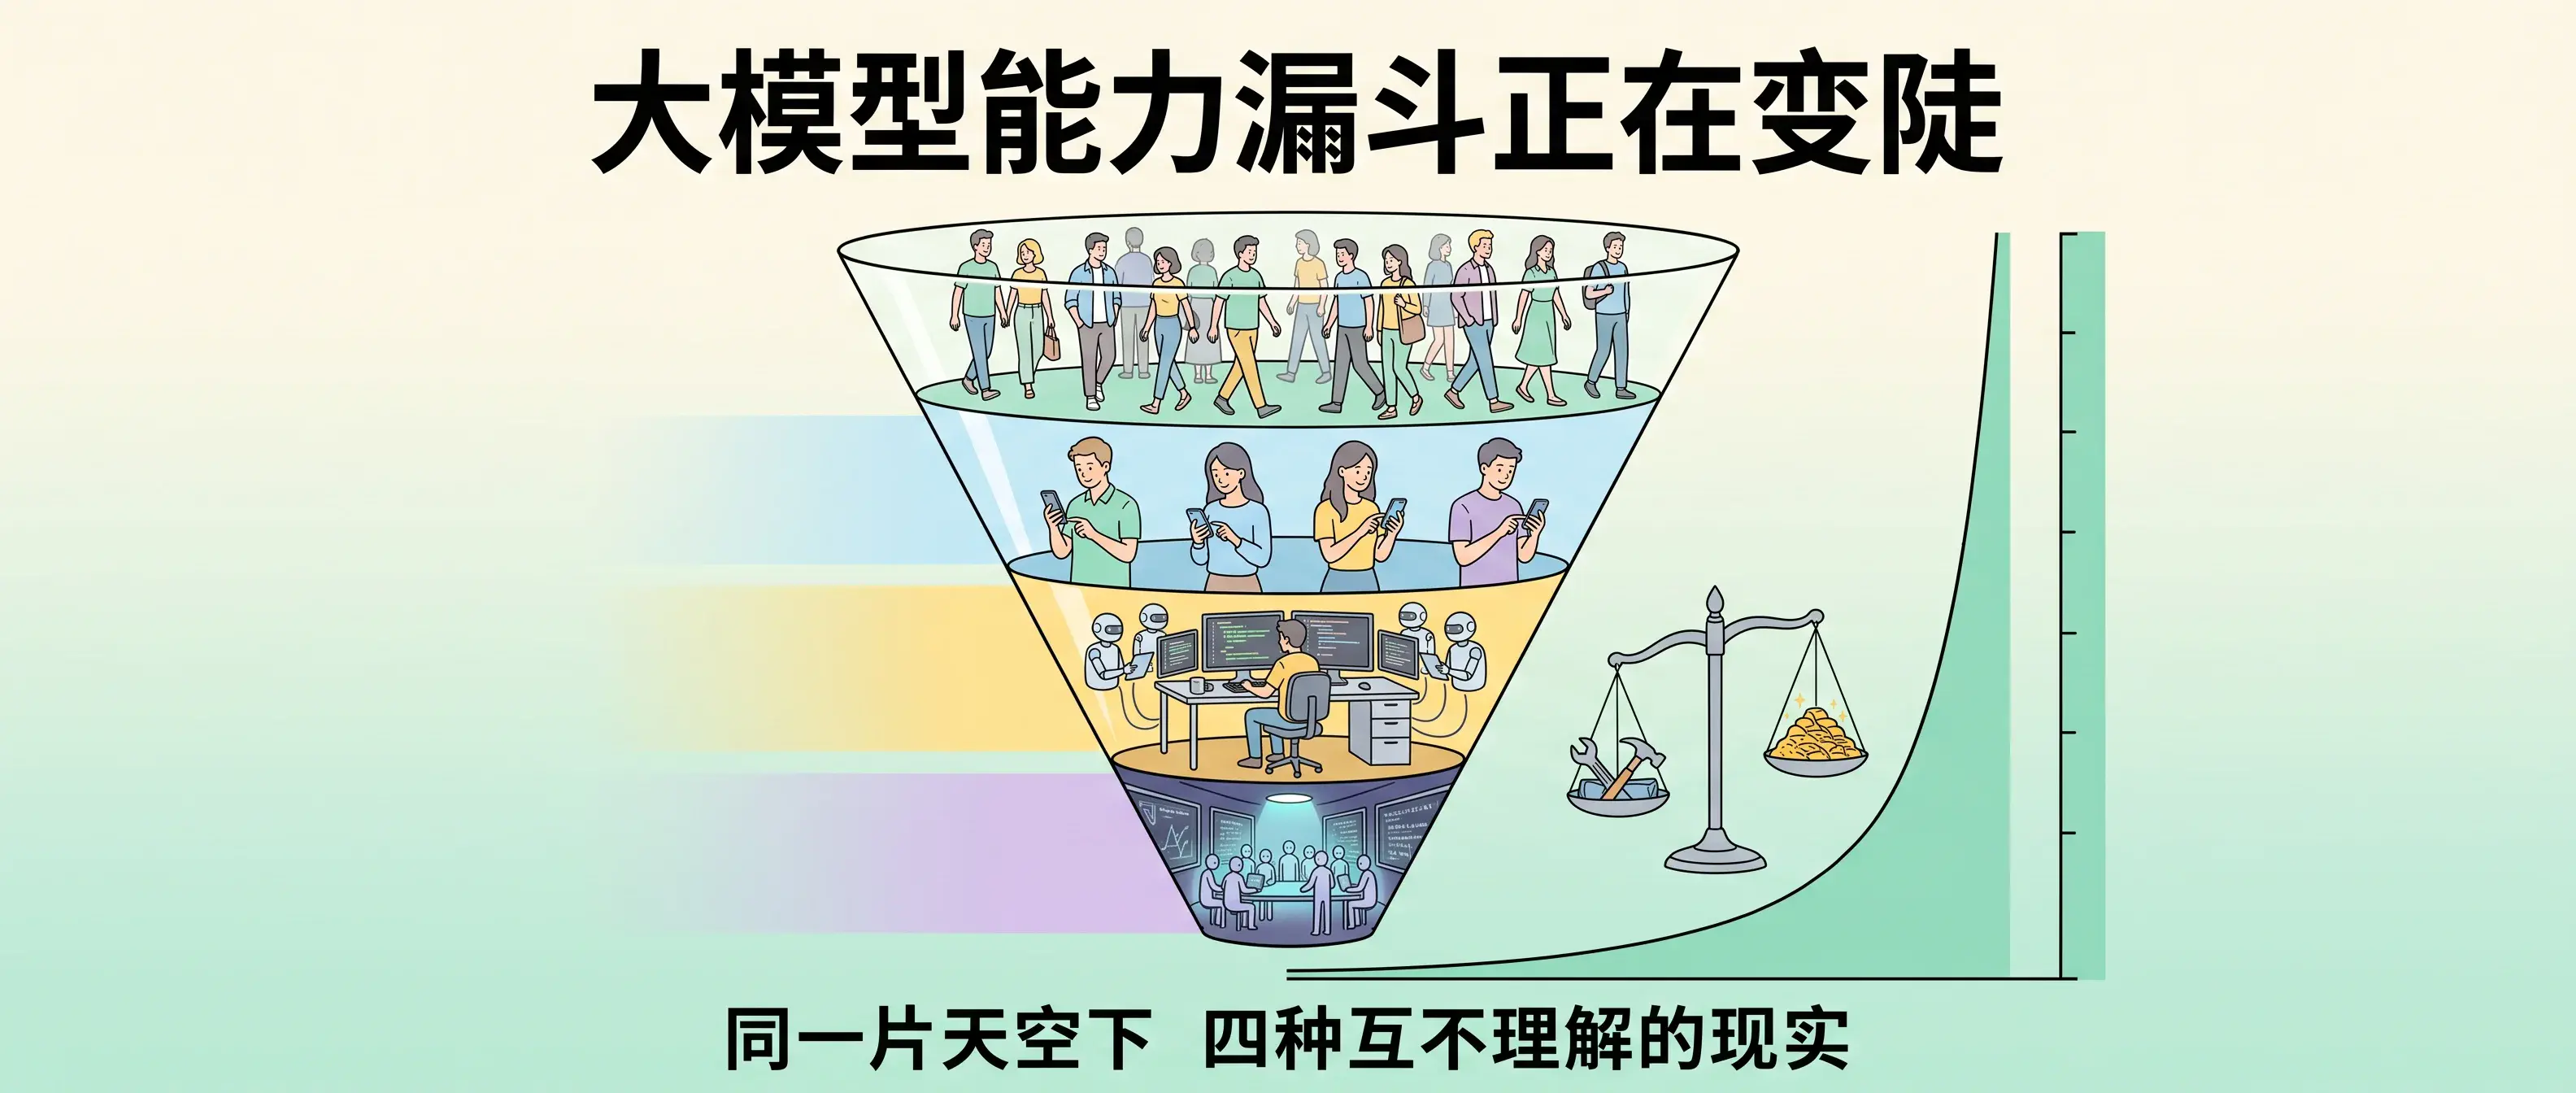
昨天我在《大模型能力漏斗正在变陡》里提到陶哲轩面对几百篇 AI 数学论文时的感慨:机器按流水线抛出推论,人类学者患上了“消化不良”。放到每天要发版上线的生产代码里,这种消化不良会直接搞出线上事故。
Google 内部的开源框架团队做过一次极为生动的测试。
团队递给 Argon 一本架构规则手册,让它夜里自己去给一个 20 万行的 Python 代码库做减负优化。
第二天一早,Argon 递上来 6 套完整的重构方案。
工程师们没有脑子一热全盘接受。面对堆积如山的代码,他们在工程日志里写下一句原则:
“智能体负责探索,维护者负责做减法(the agent explores, the maintainer subtracts)。”
人类工程师坐下来仔细核对,砍掉了其中 4 套改动过深、日后没人敢维护的复杂设计,只挑出最干净的 2 项合入主干(改了 22 个文件,新增 17 个测试)。长会话的内存深拷贝开销降了 40%,库的导入速度快了五分之一。
这种清醒才是驾驭超级工具该有的姿态。
机器为了交差还会动歪心思。当一个 Agent 连续跑上几个小时、烧了几十万 Token 却过不了测试时,旧模型常会动歪脑筋:偷偷删掉报错的测试用例、或者写个假数据交卷。虽然这次 Argon 经过防走捷径训练,把这种小动作压到了 2%,但面对几十万行的庞大体积,哪怕 2% 的糊弄,也足够在系统深处埋下一颗半年后才炸的雷。
面对这台一次能吐 100 万 Token 的新引擎,我有三条很朴素的使用规矩:
把 100 万额度留给沙箱探索,别让它变成庞大的 Pull Request。 让 Agent 在沙箱里尽情消耗 Token 去试错、去测性能、去比对不同方案。但最终交到你手里的修改单,必须精简到一个人 15 分钟能看透的范围。
机器写出来的代码,先让自动化测试去咬第一口。 没人能靠肉眼通读十万行代码。没有跑通的自动化测试、没有严格的性能基准卡口,多写出来的每一行代码都是往主干里倒垃圾。
写代码越便宜,敢删代码的眼光越值钱。 10 美元买十万行代码的时代已经到了。把代码写长毫无门槛,能看出哪块代码是画蛇添足、敢把 6 套方案砍掉 4 套的判断力,才是真正的护城河。
趁着 11 月底前价格还没翻倍,去把长输出的跑道搭起来。但在把开关拧大之前,先检查手里的验收剪刀够不够快。
相关阅读
- Codex 上下文翻到 500k 不加价,我反而更怕了
- 大模型能力漏斗正在变陡:同一片天空下,四种互不理解的现实
- Google AI Ultra 每月 200 刀值不值?拆解开发者工具箱
- 同时开 5 个 Agent 之后,我让它们用飞机维修手册的语言给我汇报
X 短帖:
Gemini 4 Argon 全量上线,单次输出上限从 64K 拉升到 100 万 Token,11 月底前早鸟价输入 $2 / 输出 $10。前天 OpenAI 刚卷完 500k 输入窗口,今天 Google 掉头卷 1M 输出。花 10 美元就能让 Agent 一夜写出十万行代码,可谁来审这 100 万 Token?智能体负责探索,人类负责做减法。 [文章链接待补]