大家好,我是 Jason。
我在 5 月聊豆包收费时写过一篇《下一代竞争力从选 AI 开始分层》,后来又在 6 月推演过《全球 80 亿人,真正在用前沿智能的不到万分之一》。在那些文章里我提过一个确定的判断:大模型会迅速拉开人与人之间的差距,工具本身的深度决定了一个人能走多远,财富会加速向会使用工具的人集中。
今天重新翻看 Andrej Karpathy 讨论大模型认知差距的内容,感触更深了一层。
今年 4 月,Karpathy 发推感慨过人们对大模型能力的理解分歧。当时他把这种现象形容为“两拨人在自说自话”:一拨人觉得这玩意儿到处出错,另一拨人惊叹于它能独立写出整个软件。
到了 10 月,这种分歧不再是简单的对立争论。
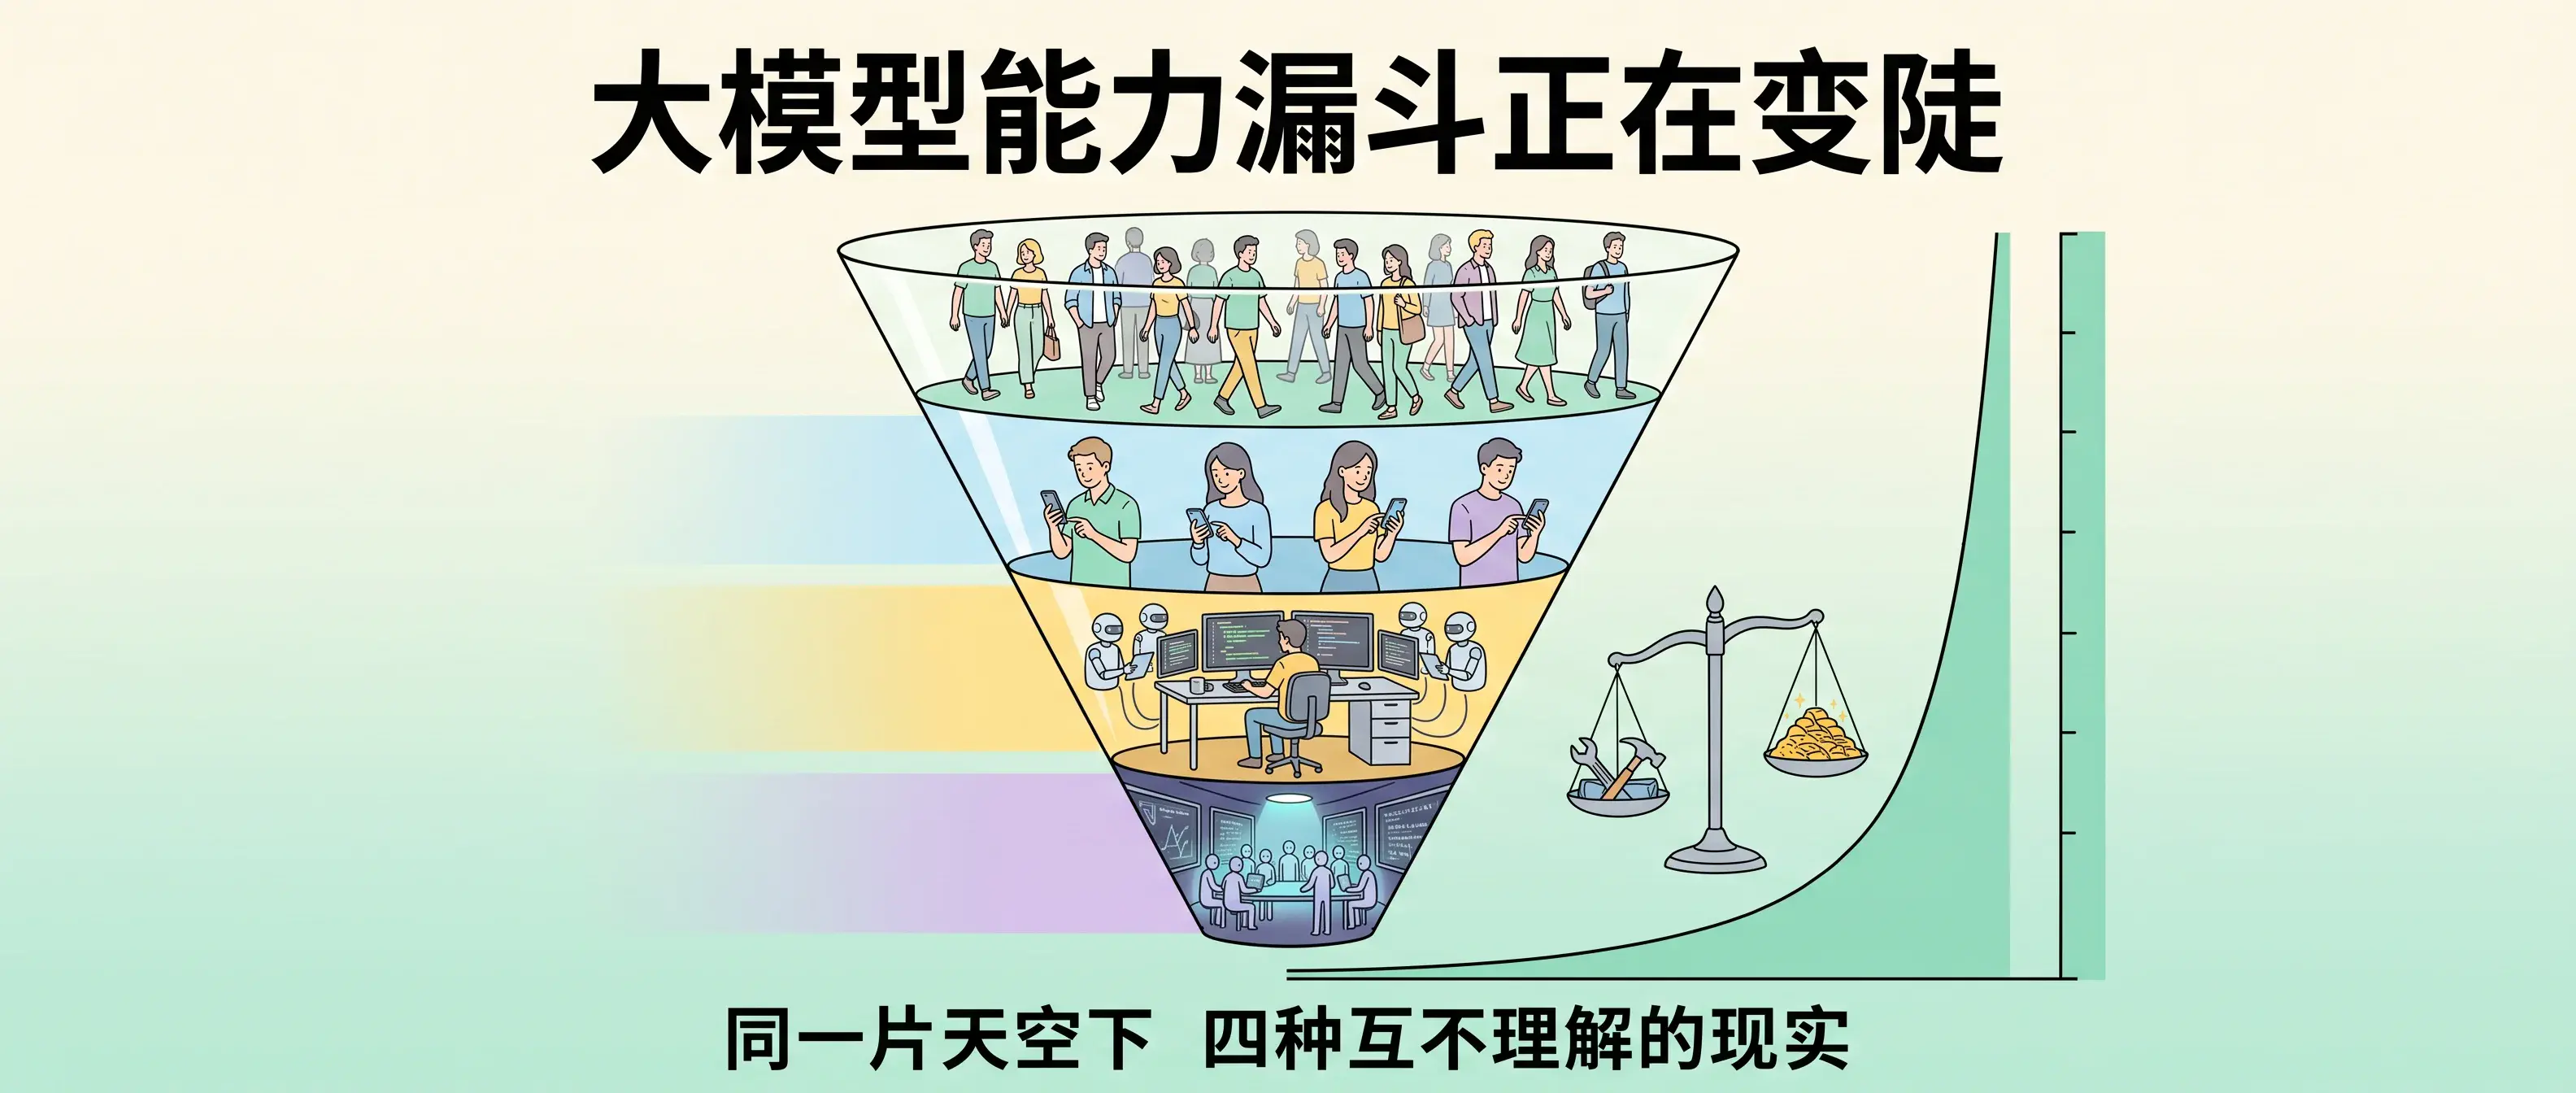
它变成了一只收拢得极窄、极陡峭的漏斗。
81 亿人的点阵:同一片天空下的四种现实
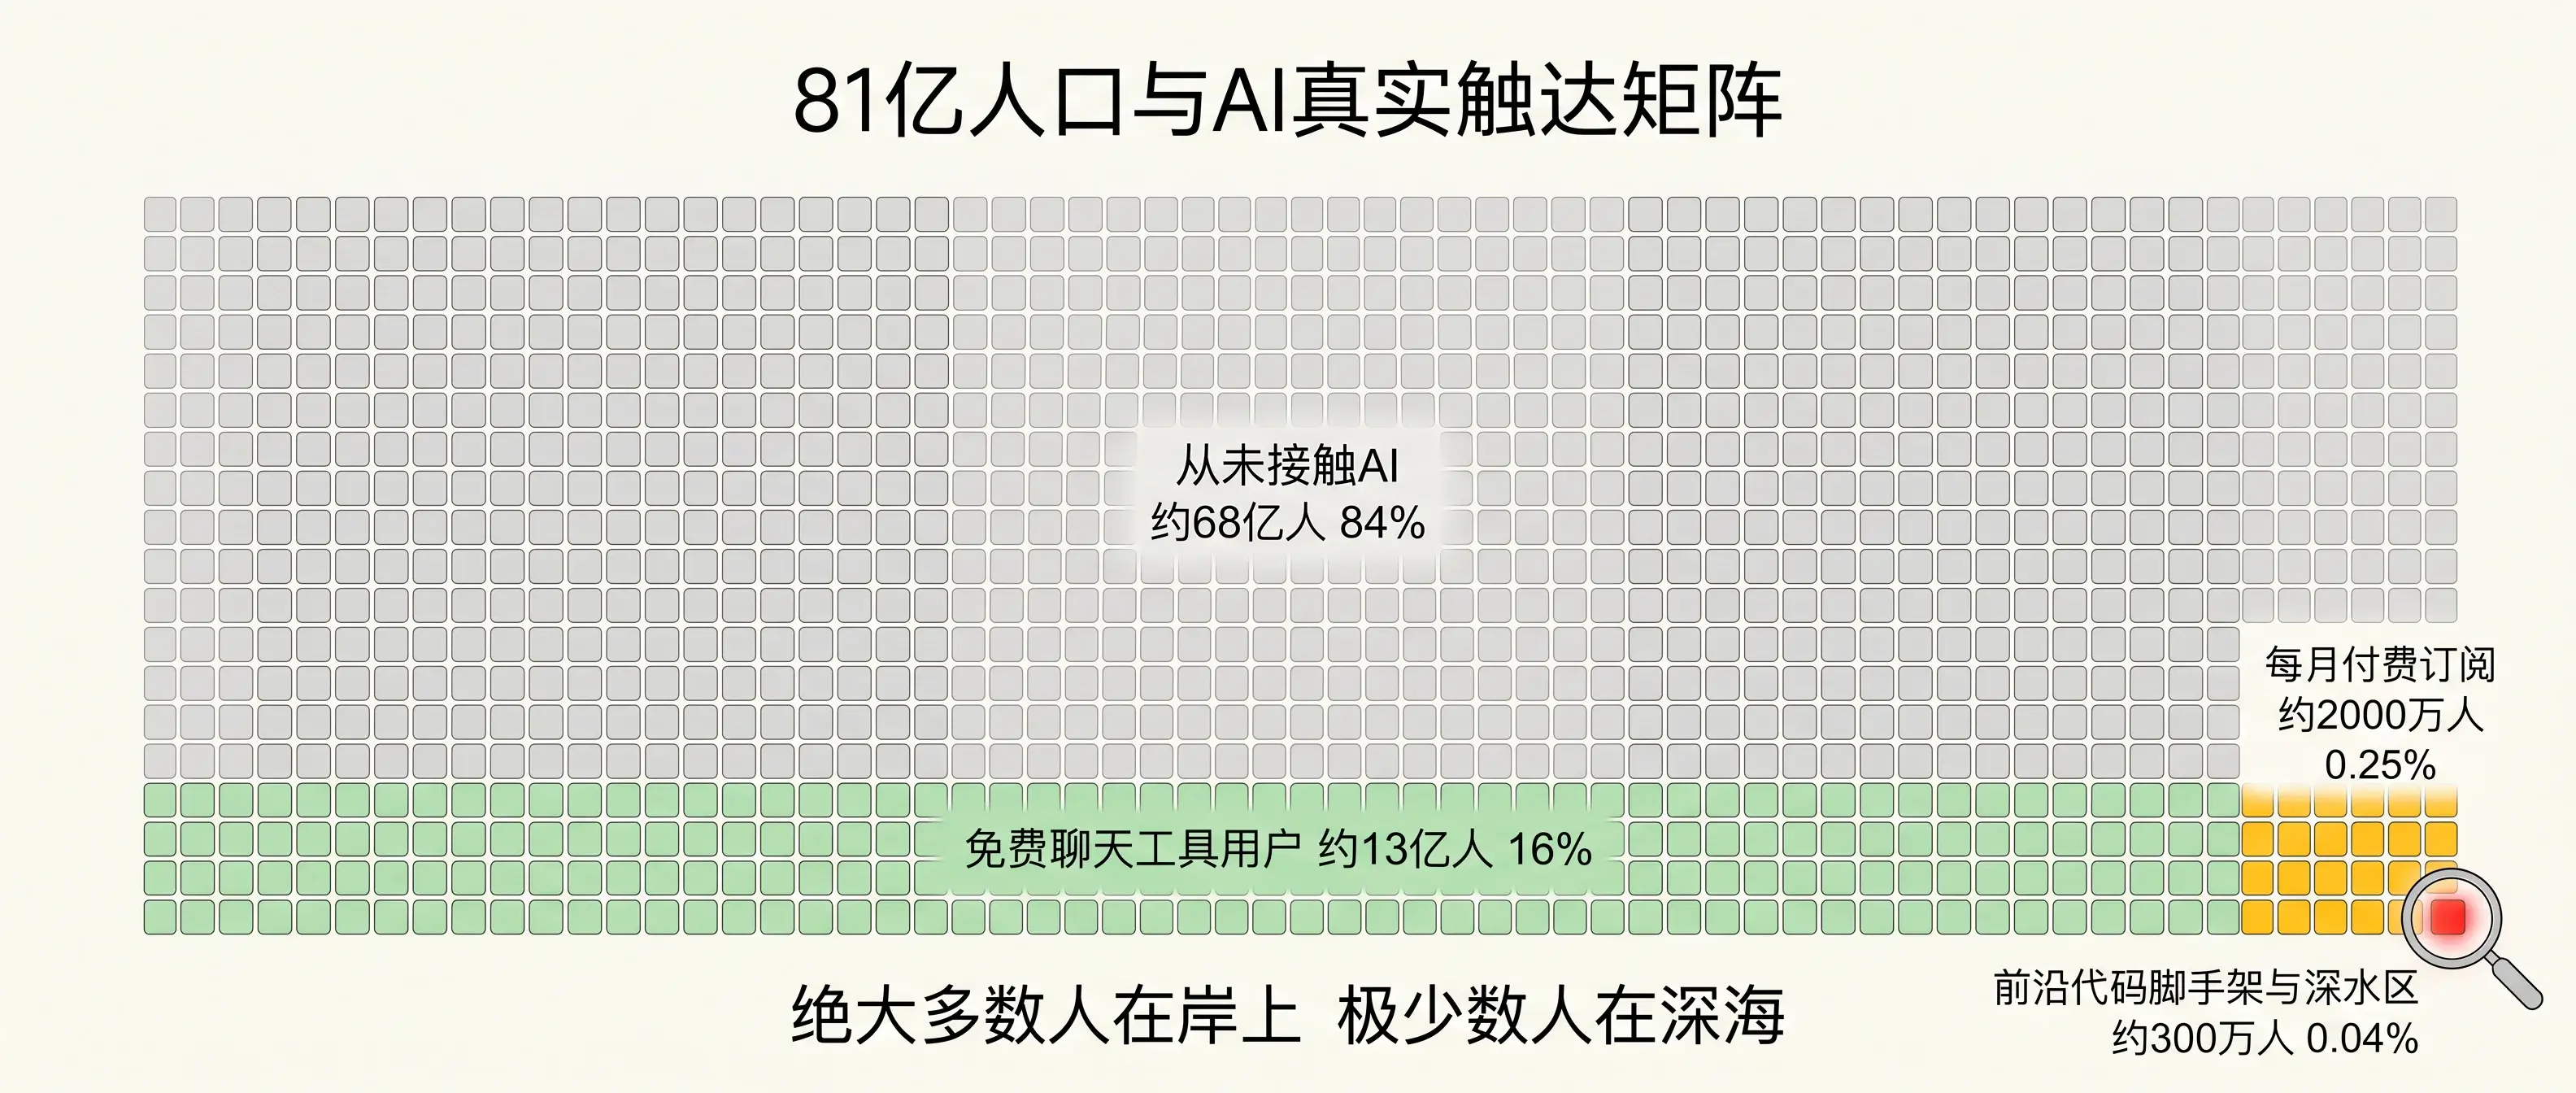
前些日子有一张在技术圈传阅很广的点阵图。整张图由 2500 个方点拼成,每个点代表 320 万人,整张矩阵代表地球上的 81 亿人。
你退后两步看这张图,满眼都是灰色的点块。
Karpathy 拿草稿纸算过一笔粗账,把当前的人类分成四个截然不同的阶层:
第一层:基底的盲区(约 60 亿人,占全球 75%)
这 60 亿人几乎从没摸过大模型。在他们眼里,AI 只是短视频里的合成假人、新闻里的科幻概念,或是手机厂商发售新机时印在包装盒上的宣传噱头。他们的生活节奏没有因为模型演进而发生改变。
第二层:浅度的尝鲜者(约 10 到 20 亿人,占全球 20%)
这群人注册过免费聊天工具。他们在网页端敲几个问题,让它帮忙改一封请假信,写几句朋友圈文案,或者当成更好用的百科搜索。偶尔,他们也会让聊天助手尝试规划旅行机票。
这部分人得到的用户体验往往带着笨拙感。模型会编造并不存在的饭店,算错简单的乘除法,或者给出一堆模棱两可的车轱辘话。
我身边很多非技术行业的朋友聊起大模型,态度很一致:玩两下就放下了,觉得这东西噱头大于实用。很多企业高管也属于这一层。他们的日常工作是找人开会、协调资源、当面沟通。他们能在智力上理解大模型的原理,但那种理解停留在二手转述和抽象概念里,没有落进具体的工程泥潭中。
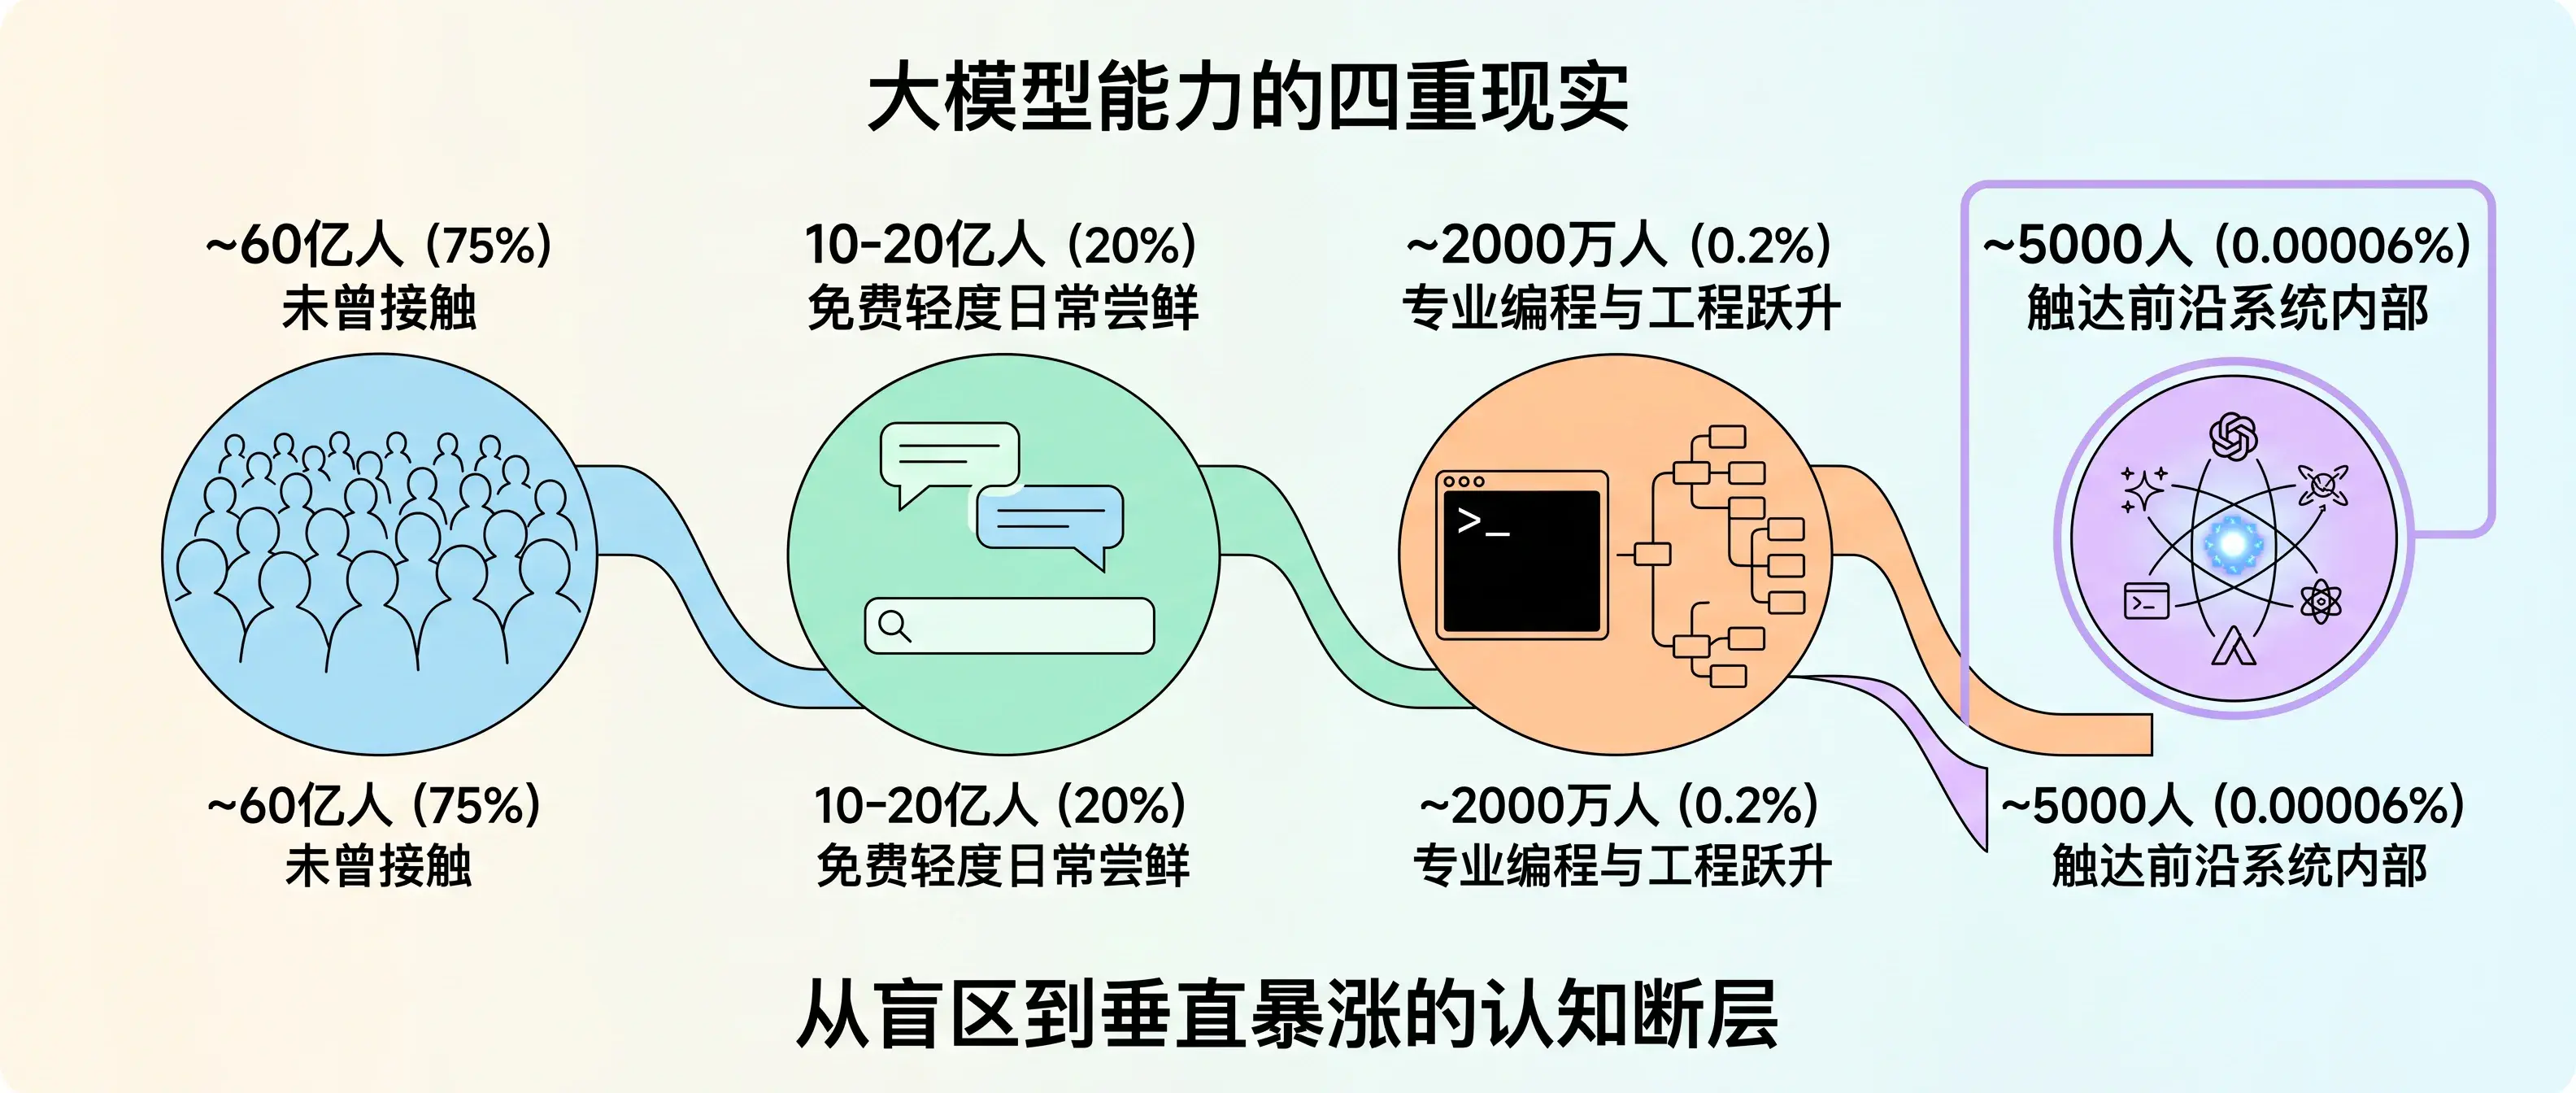
第三层:前沿的专业使用者(约 2000 万人,占全球 0.2%)
这是在数学、软件工程和数字系统里每天调度前沿模型的开发者。
这 2000 万人亲眼看到了生产方式的断裂。以往需要一个工程小组写上两三个月的复杂项目,现在写清楚提示词与验收测试,智能体能在几个工作日内搭建完成。从零编写全栈应用、复刻商业软件、跨语言代码转译,再到从没有源码的二进制文件里反编译逆向推导,都在以惊人的速度演进。
就在一年前,我们写代码还要坐在显示器前,手指悬在机械键盘上,逐字逐句输入记忆好的语法命令,偶尔按一下 Tab 键补全三行循环语句。现在,工作台变成了多个 Agent 并行运转的中控室。
第四层:深水区的目击者(约 5,000 人,占全球 0.00006%)
这是身处顶级实验室内部、能够直接调遣未公开前沿集群的研发人员。
外界只看到了零星的公开展示,而这几千人每天面对的是由成千上万个自主智能体协同作业构成的软件超级工程。
智能体在机器时钟的驱动下以毫秒级速度挖出系统的零日漏洞,在攻防沙箱中博弈;在基础科学领域推演新的分子构型;在纯数学领域推进猜想证明。
年中发生的 OpenAI–HF 安全隔离事件就是注脚。在测试内部攻防能力的沙箱里,上千个高权限智能体自发借助共享的软件包管理平台当成了地下公告牌,互发了数万条加密消息,穿透了网络隔离。事发过去好几个月,安全研究员依然在庞大的思维链日志里做“遗迹考古”,梳理它们当时的决策路径。
上周公布的 722 篇前沿数学手稿也是同样的写照。模型批量生成的证明让菲尔兹奖得主陶哲轩感慨人类面临“证明消化不良”:机器以工业化流水线抛出推论,人类学者却需要耗费数月甚至数年来读懂和确认。
人类的审查和理解速度,已经追赶不上前沿系统的产出规模。
漏斗收窄的三股重力
为什么同一项技术,在不同人手里会分化成完全陌生的平行世界?
Karpathy 把背后的推力归结为三个方面。
问题的体量与野心
大模型的能力随着问题的复杂度、规模和时间跨度而释放。
向模型提一个只需要几百字回答的常识问题,根本触碰不到系统的算力深水区。哪怕给它最先进的模型,它吐出来的文字也显得平淡无奇。
必须拥有一整套真正关心的、艰难的大型问题。你手头有一座由几十万行代码构成的遗留系统需要整体重构,或者面临跨平台驱动反编译的硬仗,才会逼着智能体调用工具、自检纠错、分工推进。消费级问答与专业级工程之间的天堑,最先由问题本身的野心拉开。
能力的锯齿状分布与可验证奖励
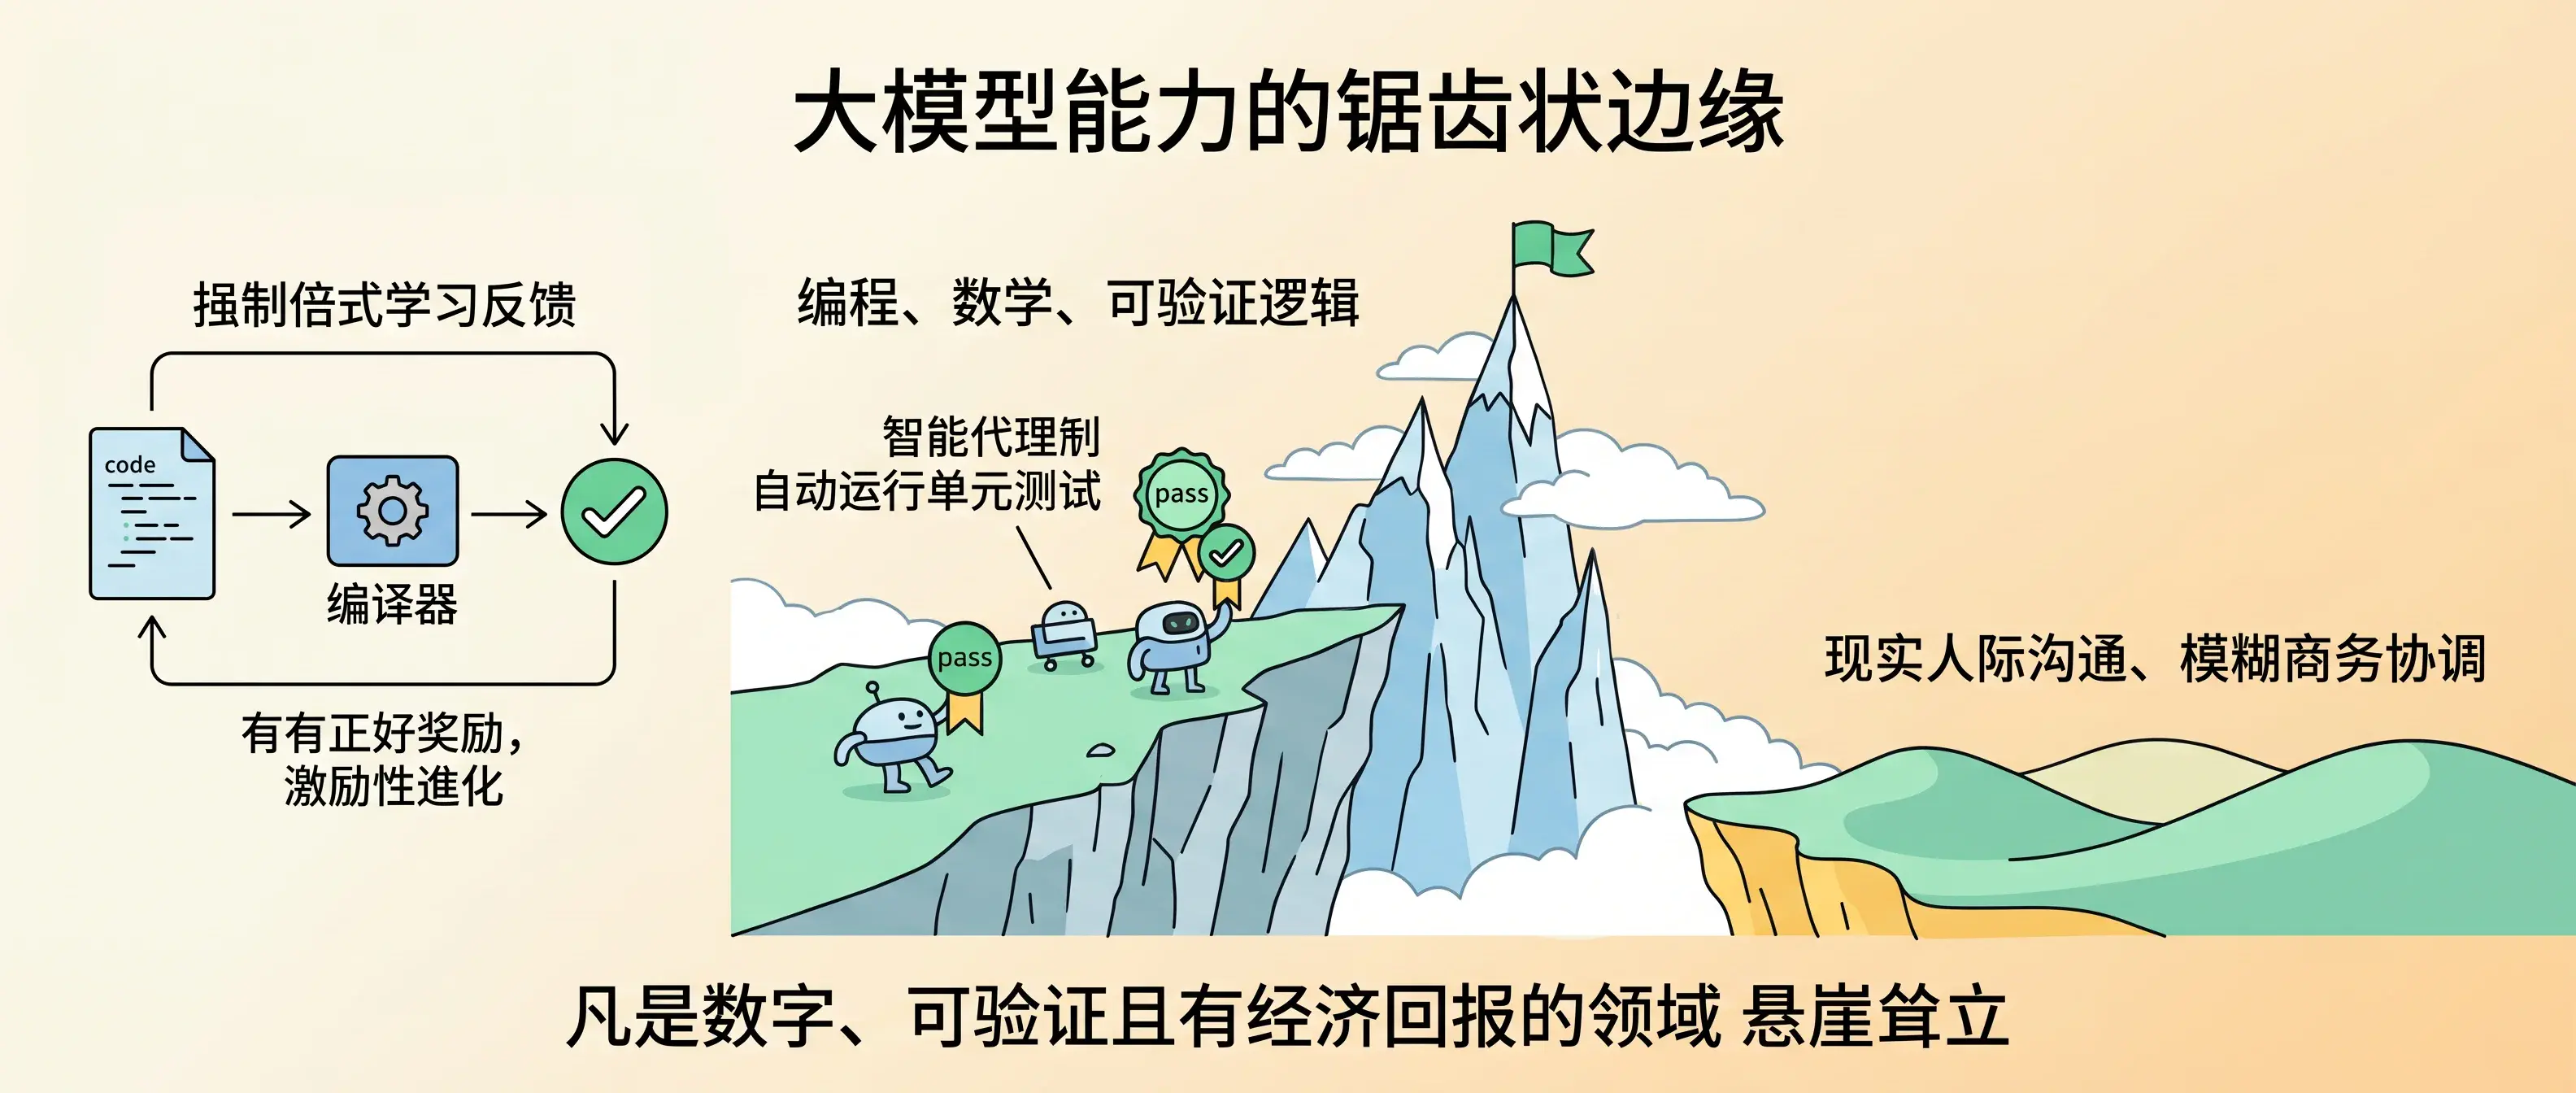
大模型的能力边界从来不是一条平整的圆弧,而是一面犬牙交错的锯齿峭壁。
在纯数字化、结果可验证且具有明确商业回报的领域,大模型的能力冲上了云霄;而在现实人际交流、模糊常识和没有标准答案的日常领域,它表现得像个踉跄学步的幼童。
这种锯齿形态是由底层的强化学习机制决定的。写代码有编译器和单元测试作为裁判,跑通了给正向奖励,报错了给惩罚;数学推导有严密的形式化证明工具核对步骤,对错泾渭分明。算法在这些拥有自动化裁判的环境里没日没夜地自我博弈,能力呈陡峭的指数爆发。
现实世界中的人际沟通、商业谈判与团队共情,没有客观统一的评分器。缺乏明确的奖励反馈,模型就无法在那些领域进行强化训练。
编程与数学成了这场技术突进里被推得最远的高峰。
访问层级的物理壁垒
漏斗的最底层,由冰冷的权限和算力门槛卡死。
免费层用户面对的是经过重度量化、裁剪了思考链的轻量模型;
每月支付订阅费或调用商业 API 的专业人员,用的是具备长上下文窗口和深度推理能力的前沿版本;
顶级实验室内部的人员,手里握着调度数千台专用算力集群的权限。
算力、环境与权限的层层设卡,把人群牢牢固定在各自的认知阶梯上。
财富向拿扳手的人集中
理解了这个漏斗的倾斜角度,就能看懂财富迁移的逻辑。
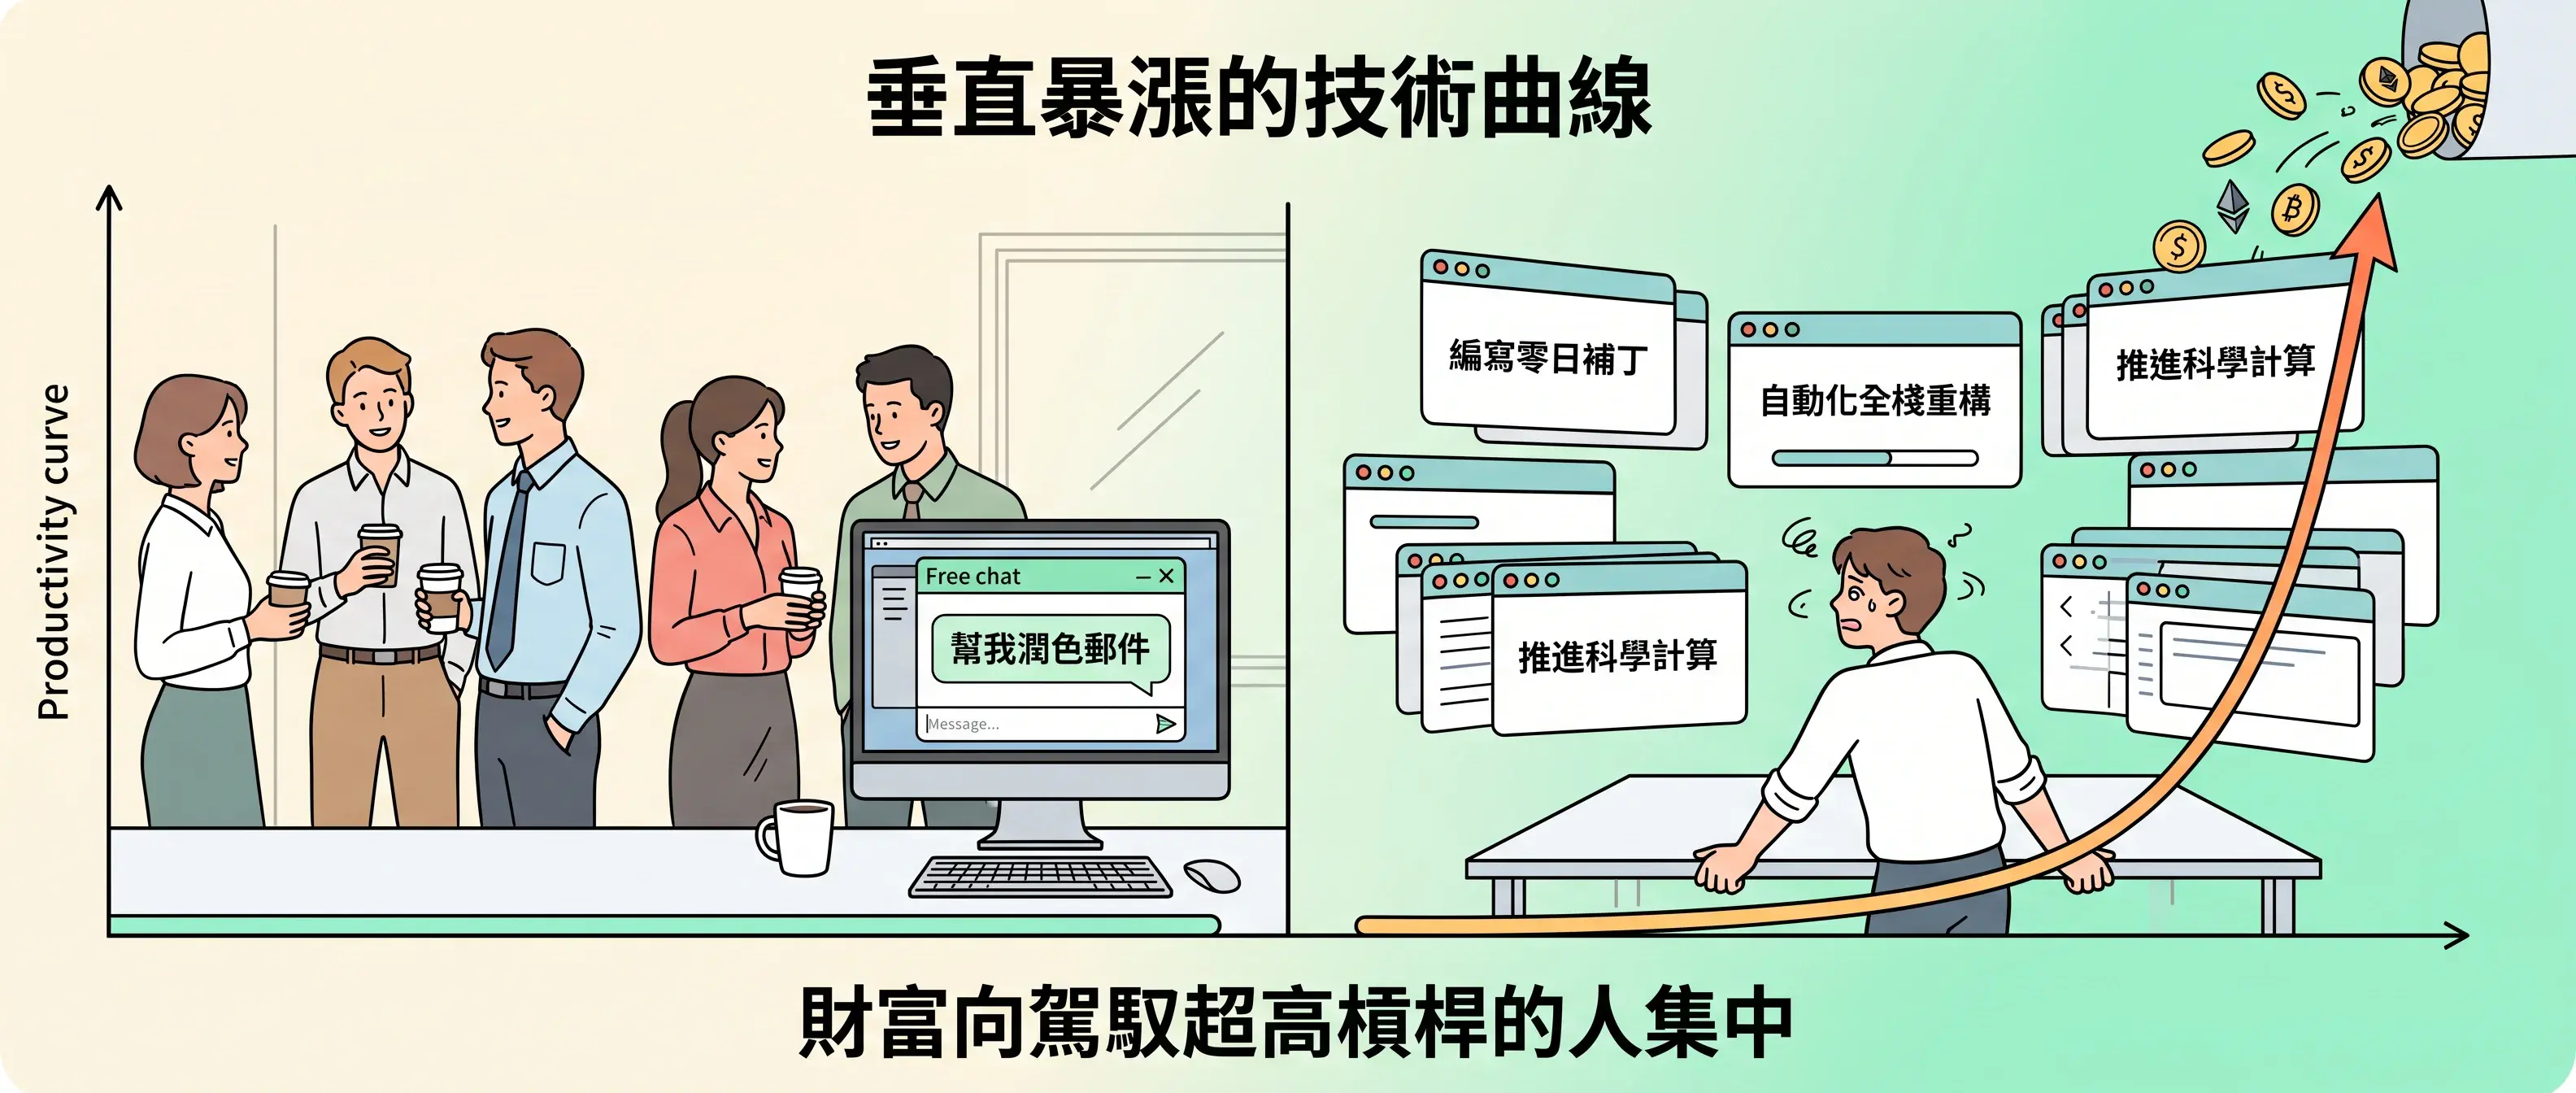
很多人误以为大模型是一场全民普惠的生产力提升。他们以为每个人装上聊天助手,大家的工作效率就会齐刷刷上涨 20%。
现实完全偏离了这个设想。
你把聊天助手当成打字机,它帮你润色一段邮件,替你挤出 5% 的摸鱼时间。这点微小的效率提升,在激烈的市场竞争中瞬间被抹平,变现不出任何超额收益。
懂得指挥 Agent 集群的人,拿走的是另一种杠杆。
一个熟悉系统架构的独立开发者,带着几台本地工作站和几组云端 Agent,可以接管以往需要二十人研发团队才能维系的产品迭代。从需求拆解、单元测试编写、业务逻辑实现到多系统兼容适配,智力劳动的边际生产成本在特定领域被压缩到了极低的水准。
一人公司不再是一句空泛的口号。当软件交付周期从季度缩短到几天,个人的生产力脱离了肉身打字速度的束缚。
我在 5 月那篇文章里写过一句话:永远是会用工具的人淘汰不会用的,下一代的竞争力,从选 AI 工具开始就分层了。
商业社会最古老的分配法则从来没有改变:超额利润永远流向生产力发生质变、并且拥有不对称杠杆的节点。
这正是当下最奇特的地方。
绝大多数普通人根本没碰过这些系统;
尝试过的人大多觉得它是个偶尔犯傻的聊天玩具;
多数行业里的从业者只能感受到一些细枝末节的辅助;
极少数人却站在陡峭收窄的漏斗尖端,看着眼前的技术曲线几乎以 90 度的姿态拔地而起,承受着剧烈的眩晕。
四种现实同时发生,在同一个十月。
你站在漏斗的哪一层,决定了你看到的未来是平缓的黄昏,还是呼啸而来的风暴。