大家好,我是 Jason。
今天刷 X,看到 OpenAI Codex 负责人 Tibo(@thsottiaux)发了一条动态:Codex 和 ChatGPT Work 里,GPT-6.1 Sol 默认上下文从 272k 提到 500k,最大能开到 1M。订阅用量内,长上下文不额外收费。
帖子引来 75 万次浏览,评论区刷满点赞和欢呼。
我盯住屏幕,后背发凉。
272k 这条被抹平的账单线
先看各家模型 API 针对长上下文的标价:
- Gemini 3.1 Pro:输入超过 200k,单价从每百万 $2/$12 涨到 $4/$18。
- Claude:Anthropic 现行价格页标明,4.6 之后的主力模型 1M 窗口按标准价计费;Haiku 5.5 属于例外,输入超过 100k 提价。
- OpenAI 自己的 API:GPT-6.1 Sol 输入超过 272k,单价从 $2/$10 涨到 $4/$15。
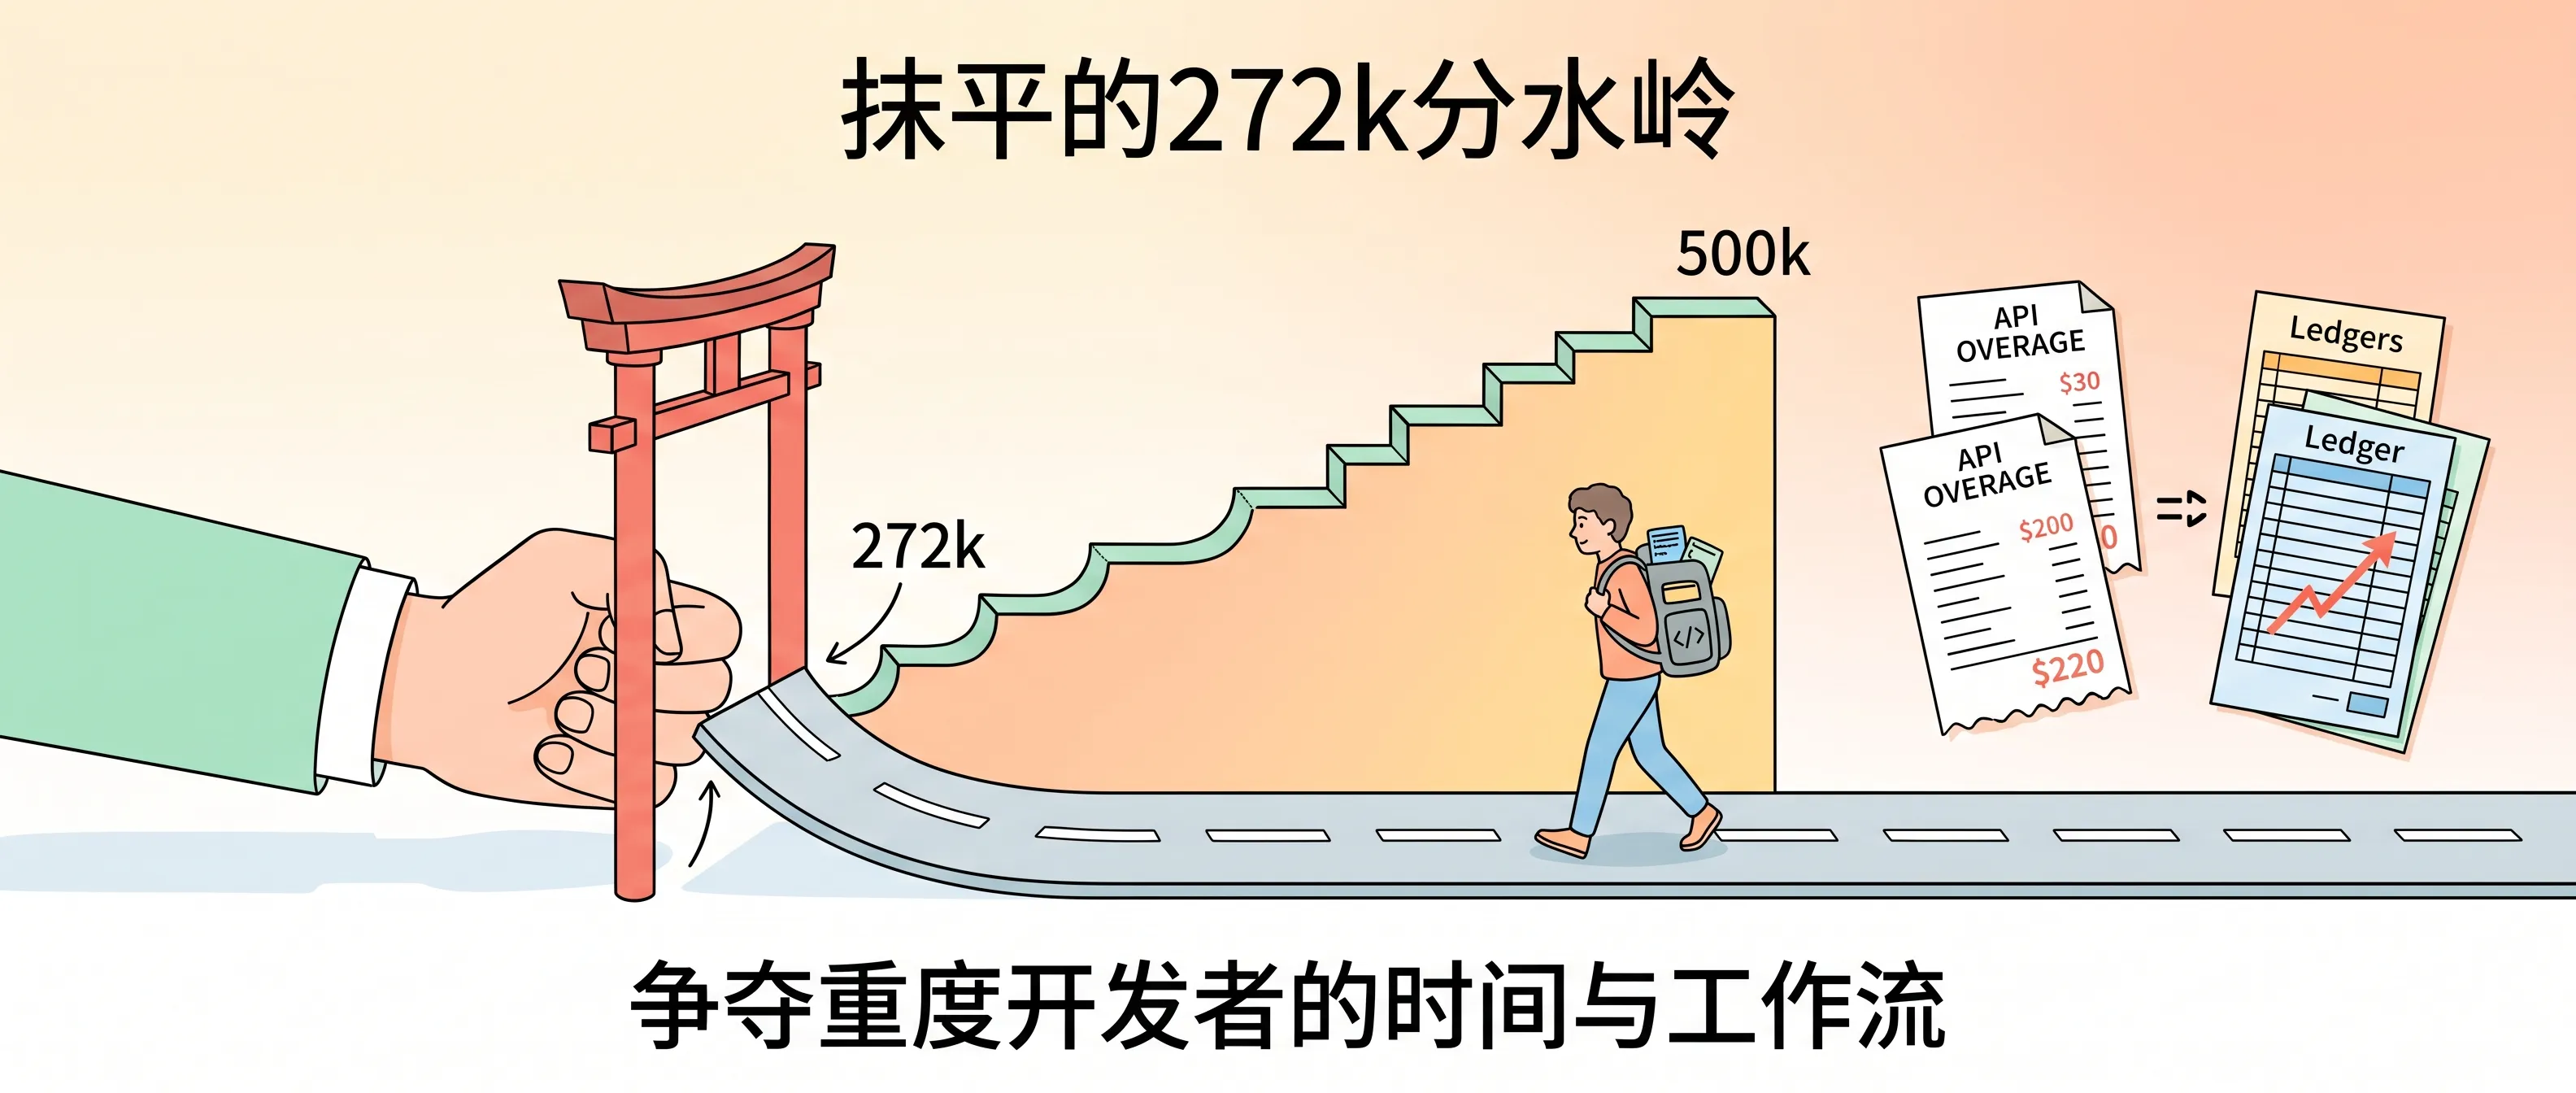
272k 这个数字,以前是一条明确的计费红线。
在 API 这一侧,过了 272k,Token 单价直接翻倍。Codex 把默认上下文卡在 272k,账算得清清楚楚:你在红线内调用,平台承担基础成本;你想越过红线,得自掏腰包补齐差价。
现在订阅把默认窗口推到 500k,并标明不加价。这等于把横在脚下的计费红线一脚踢平。
这是一场针对重度开发者的圈地战。
轻度用户敲几句提示词,碰不到 272k 的天花板。撑满上下文的人,是把整个代码仓库喂进会话、挂着 Agent 跑自动化长任务、从早到晚不关窗口的开发者。这群人消耗算力最多,付费意愿也最高。他们的工作流一旦焊死在哪家平台,迁徙成本极高。
谁先让这批人放下算盘,谁就能扣住他们手里的工程流。
我在 5 月写 KV Cache 和 Transformer 架构分析 时算过这笔账:长上下文从来不是免费的。Prefill 阶段的计算量顺着输入长度呈平方级($O(n^2)$)飙升;到了解码阶段,几十万 Token 产生的 KV Cache 显存开销直接按数十 GB 计算。并发稍一增加,单机显存就会被撑爆。物理规律摆在面前,各家 API 在超长输入上翻倍加价,是在对齐真实的显卡硬件成本。
现在 OpenAI 在 Codex 订阅里把 500k 变成默认标配,并且不加收一分钱。这绝非物理定律凭空消失,而是平台宁可烧钱垫付算力与显存开销,也要把高净值开发者的工作流死死焊在自家的生态里。
绿油油的菠菜与崩塌的假设
我自己常态化开着好几个 Agent:Claude Code 写主力代码,Codex 啃复杂工程,Grok Bot 挂在云端跑后台。一个人的公司,Agent 承担同事的角色。长上下文我天天开,坑也天天踩。
三次真实的翻车场景,至今记忆犹新。
第一回,Codex 在长上下文里吐出满屏废话。
会话拖到后期,模型逻辑散架,控制台刷出大片绿色字符,像堆在盘子里的烂菠菜。它用不容置疑的语气连写几百行代码,接口全靠凭空捏造。我花掉半小时通读代码排查调用链,最后确认全篇没有一行能进生产环境,只能整段删掉。
第二回,Claude 的长任务账单跑穿预算。
会话不断堆叠,每一次交互都要带着几十万 Token 的历史上下文重新走一遍网络,账单数字呈倍数跳动。一个小时烧掉的调用费,顶得上平时三天的用量。
第三回,遇到某家服务商对长上下文加收六倍单价。
我盯着价格表上的 6X 标识,瞬间读懂了对方的潜台词:这个方案在工程上行不通,别这么用。
把这三次经历放在一起,现实露出了底色:
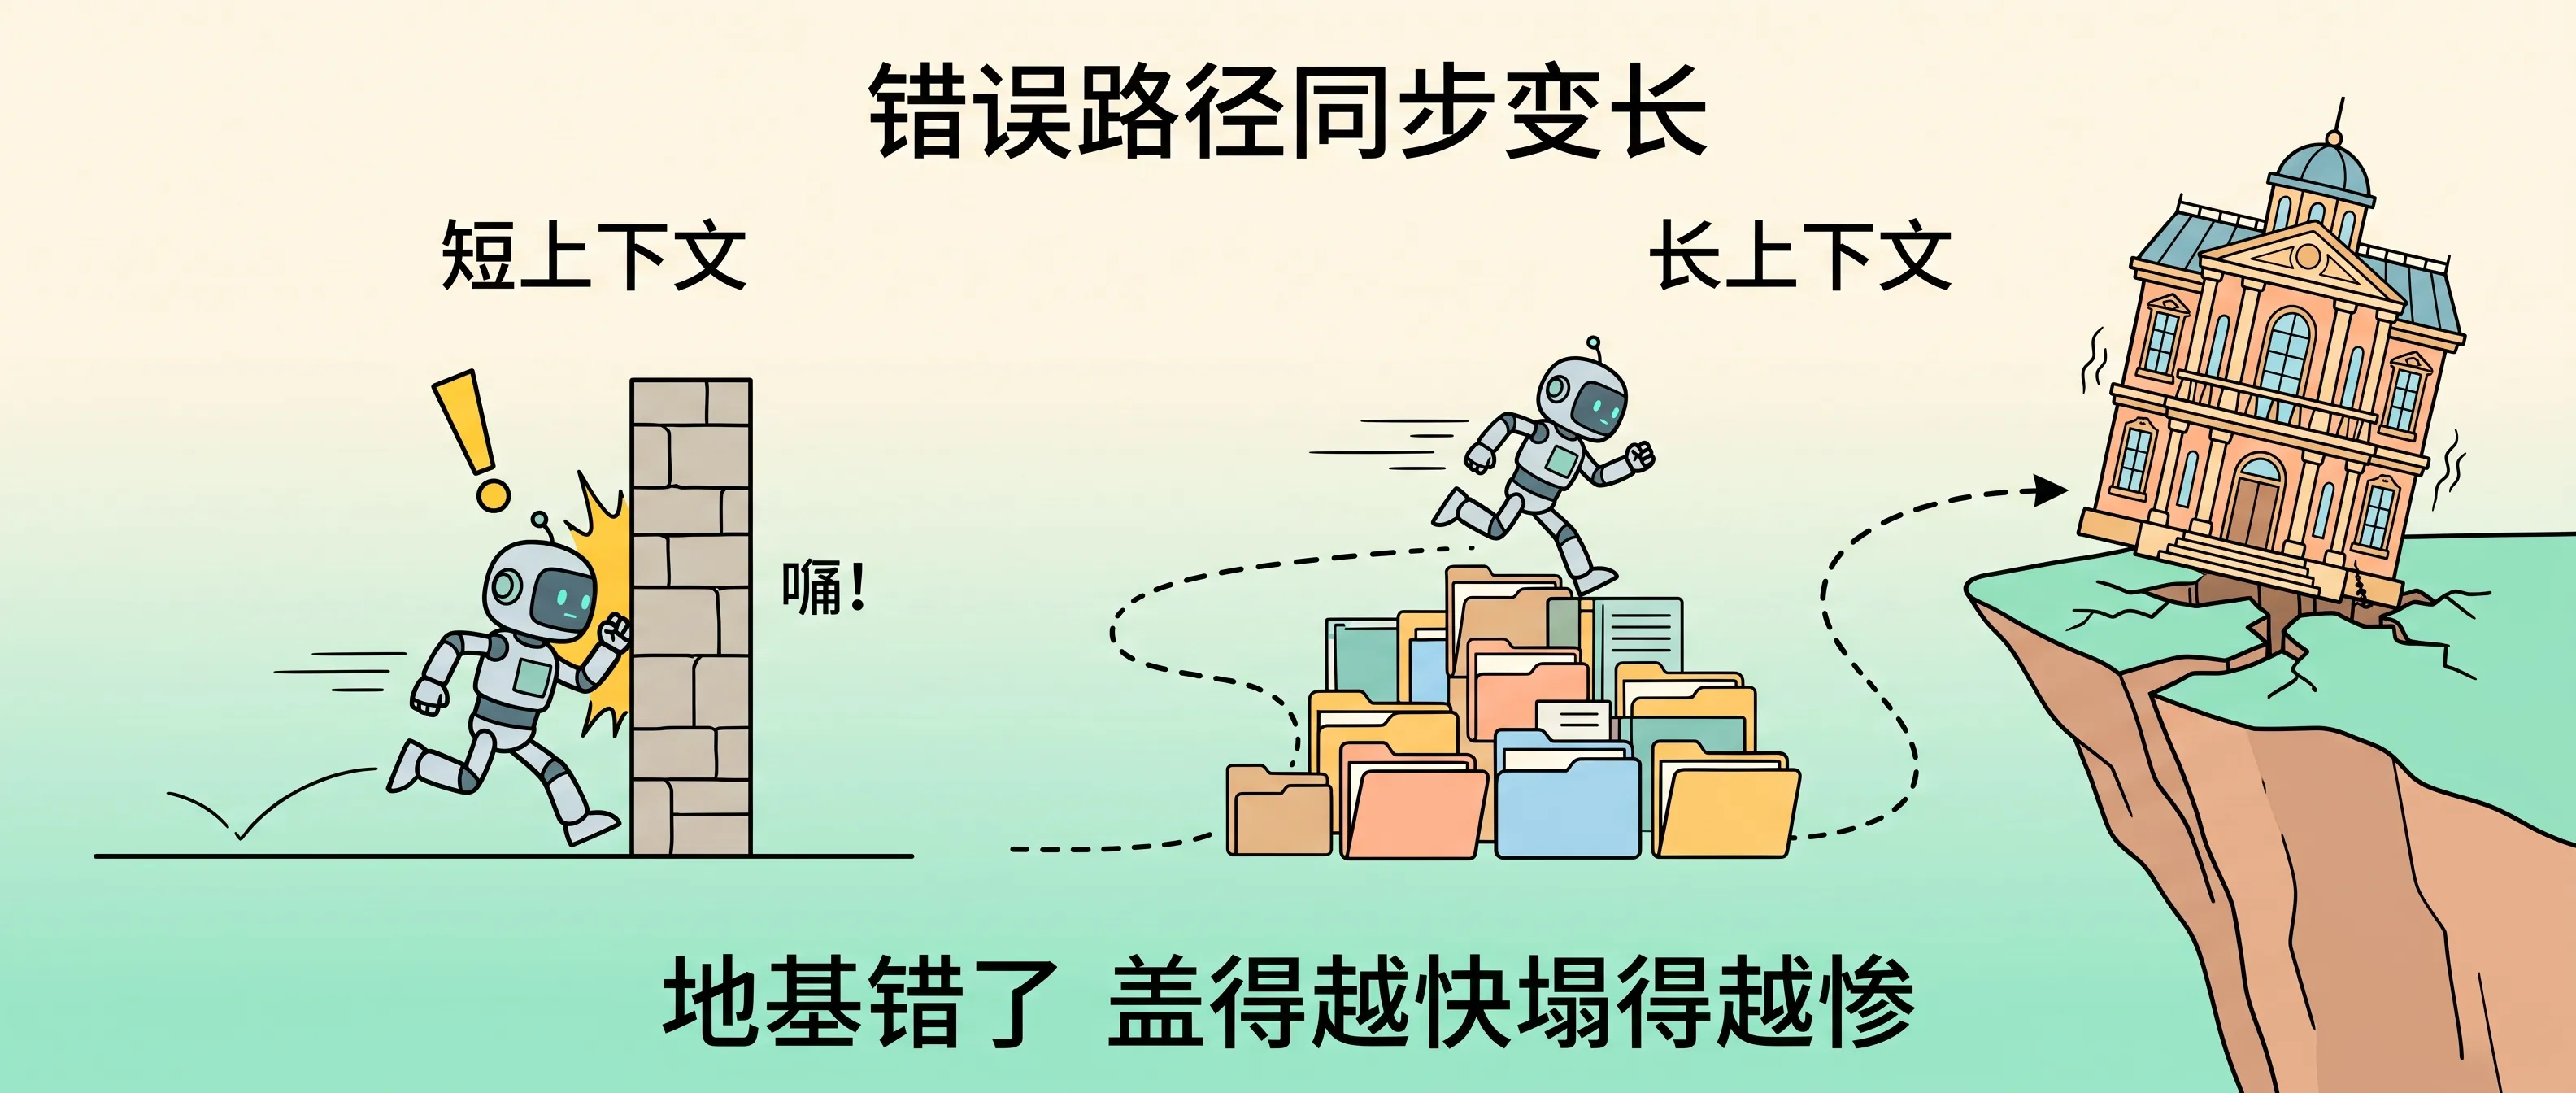
上下文变长,错误路径同步拉长。
在短上下文里,模型一旦猜错变量,跑两步就会撞墙报错,你能当场抓住破绽。到了长上下文,它能沿着一个假想的前提走出去上千米:翻看几十个文件,改动上百处代码,最后递上一份结构整洁的汇总文档。表面天衣无缝,地基却是悬空的。
幻觉在长上下文里格外昂贵。
平台不加价,免去的只是 Token 的账面费用。时间成本和注意力成本,没人替你买单。一个错误的假设渗进 400k 的会话中,后续每一次往返都在这个错误上添砖加瓦。等你发现端倪,要想排查、回滚、推倒重来,消耗的是三四个来回的漫长等待,以及自己脑力里的黄金时间。
Token 可以免费,开发者的精力绝不廉价。
给长任务立下四条规矩
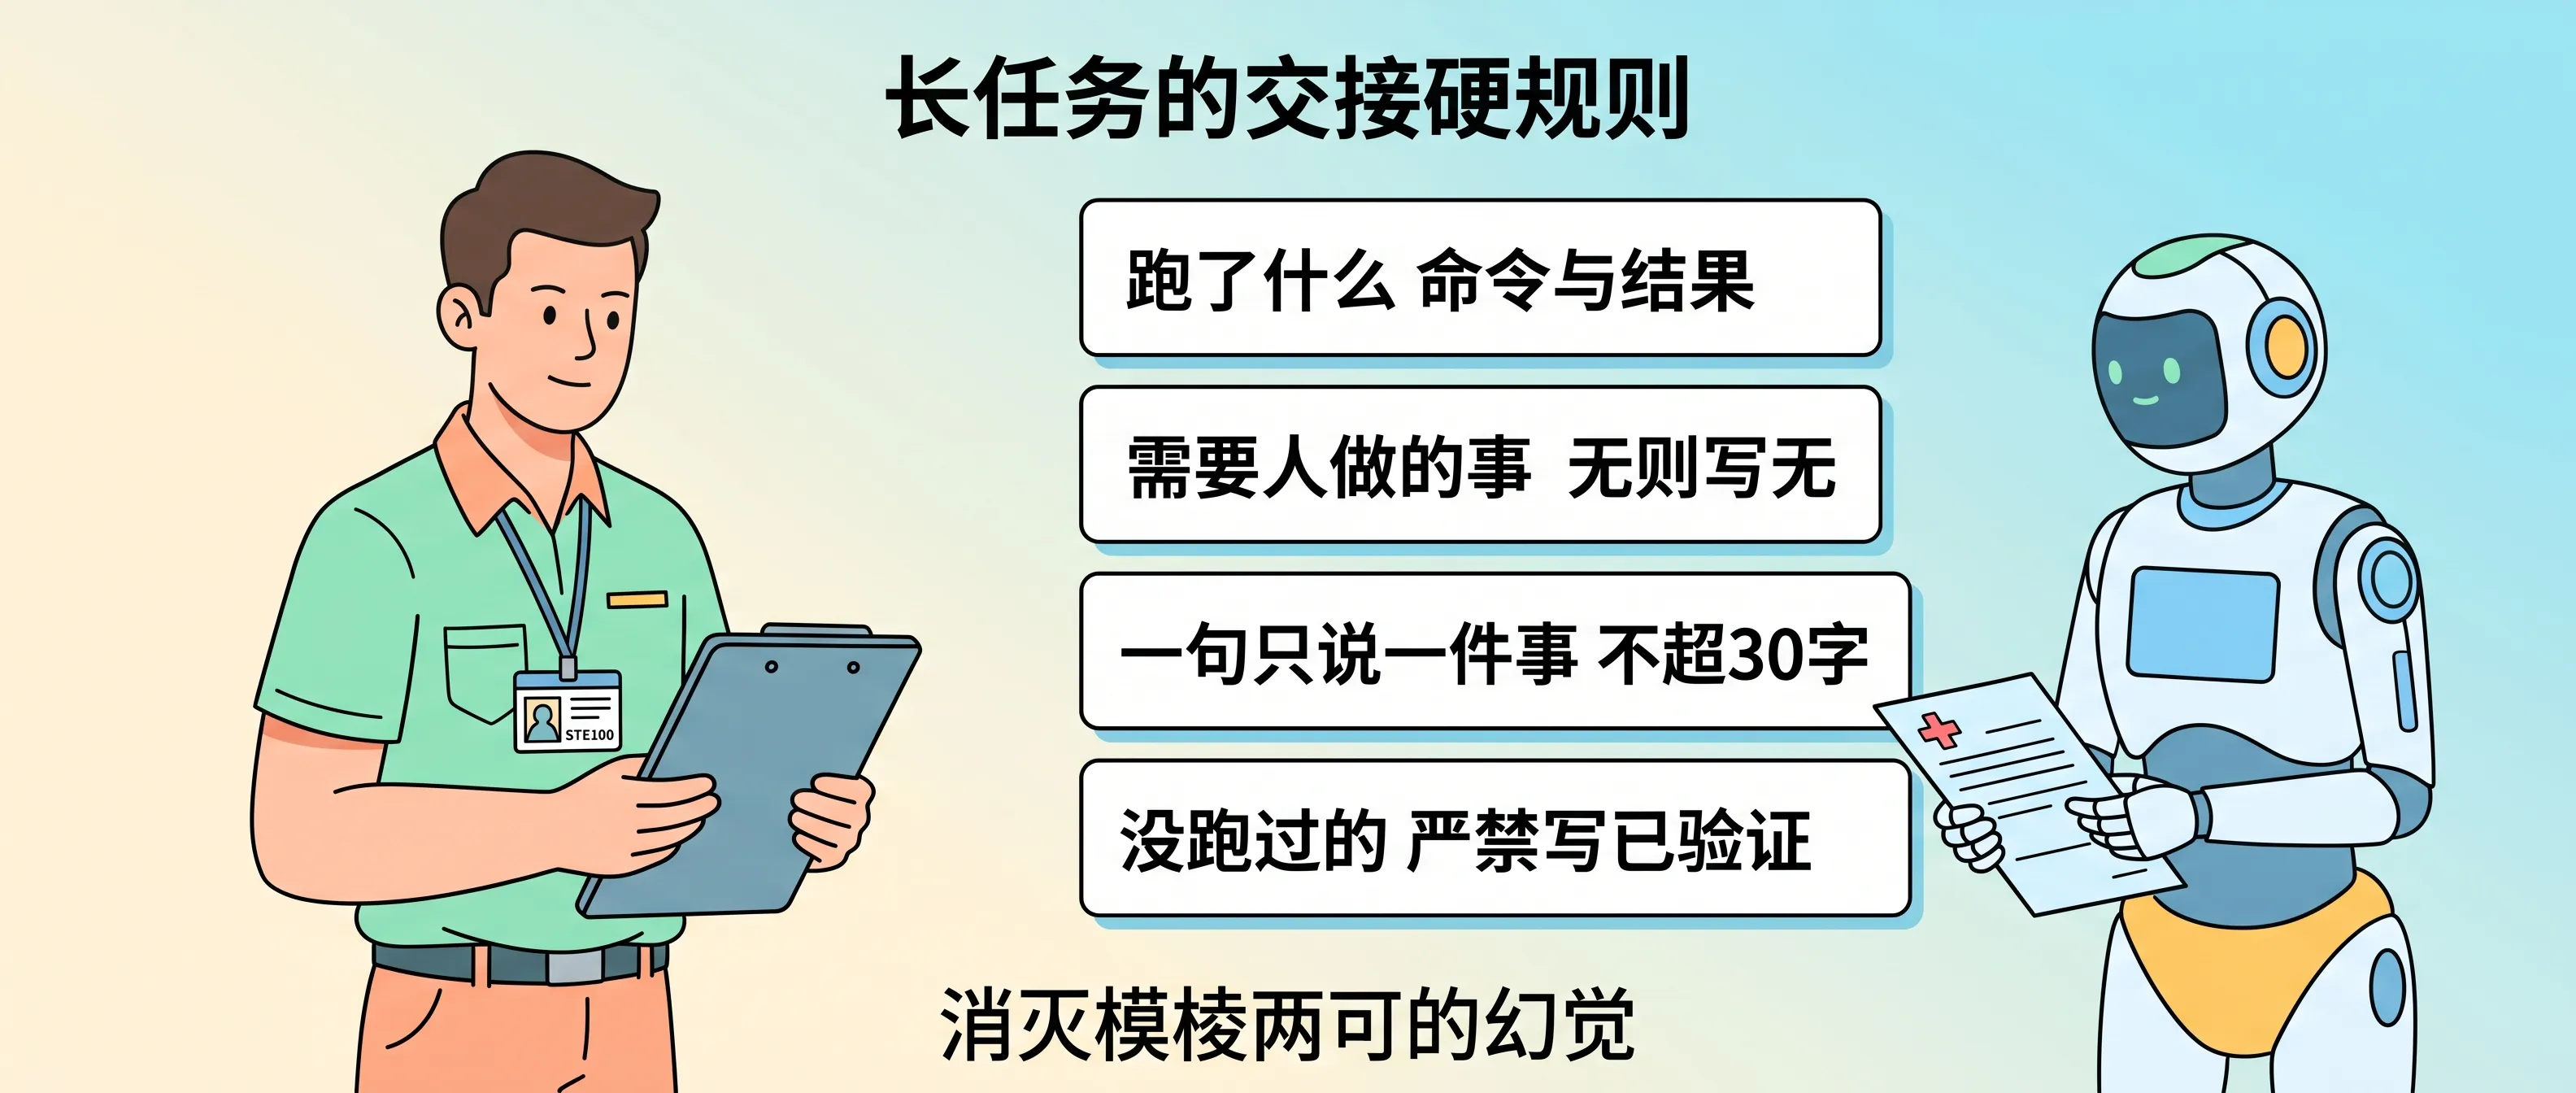
把任务交给长上下文 Agent 时,我执行四条硬性纪律。
定死验收标准,再交上下文。
把文件塞进窗口前,先写明完成定义。单元测试全部变绿、接口返回特定格式的数据,或者输出文档的每个推论都有确凿来源。
缺乏验收标准,长上下文就会沦为一张空头支票。模型会顺着自己的逻辑无休止改动,直到它自认为完工。它自认为完工,和工程真正达标,隔着一道鸿沟。
首行写明运行命令与执行结果。
这条脱胎于前几天写的 STE100 文章。那篇文章里,我让 Agent 遵照航空维修手册的规矩汇报:一句话只说一件事,首行标明需要我决策的动作。
落到高上下文的长任务里,我补上死规定:第一行必须交待跑了哪条命令、控制台返回了什么状态。
第一行:跑了什么,结果是什么(通过/失败/未运行)。
第二行:需要我做的事,没有就写"无"。
一句只说一件事,不超过 30 个字。
没跑过的,严禁写"已验证"。
多数翻车藏在「已验证」「应该没问题」这些含糊词汇里。没有运行输出作为证据,一律视为未执行。
便宜的是窗口,贵的是交付标准
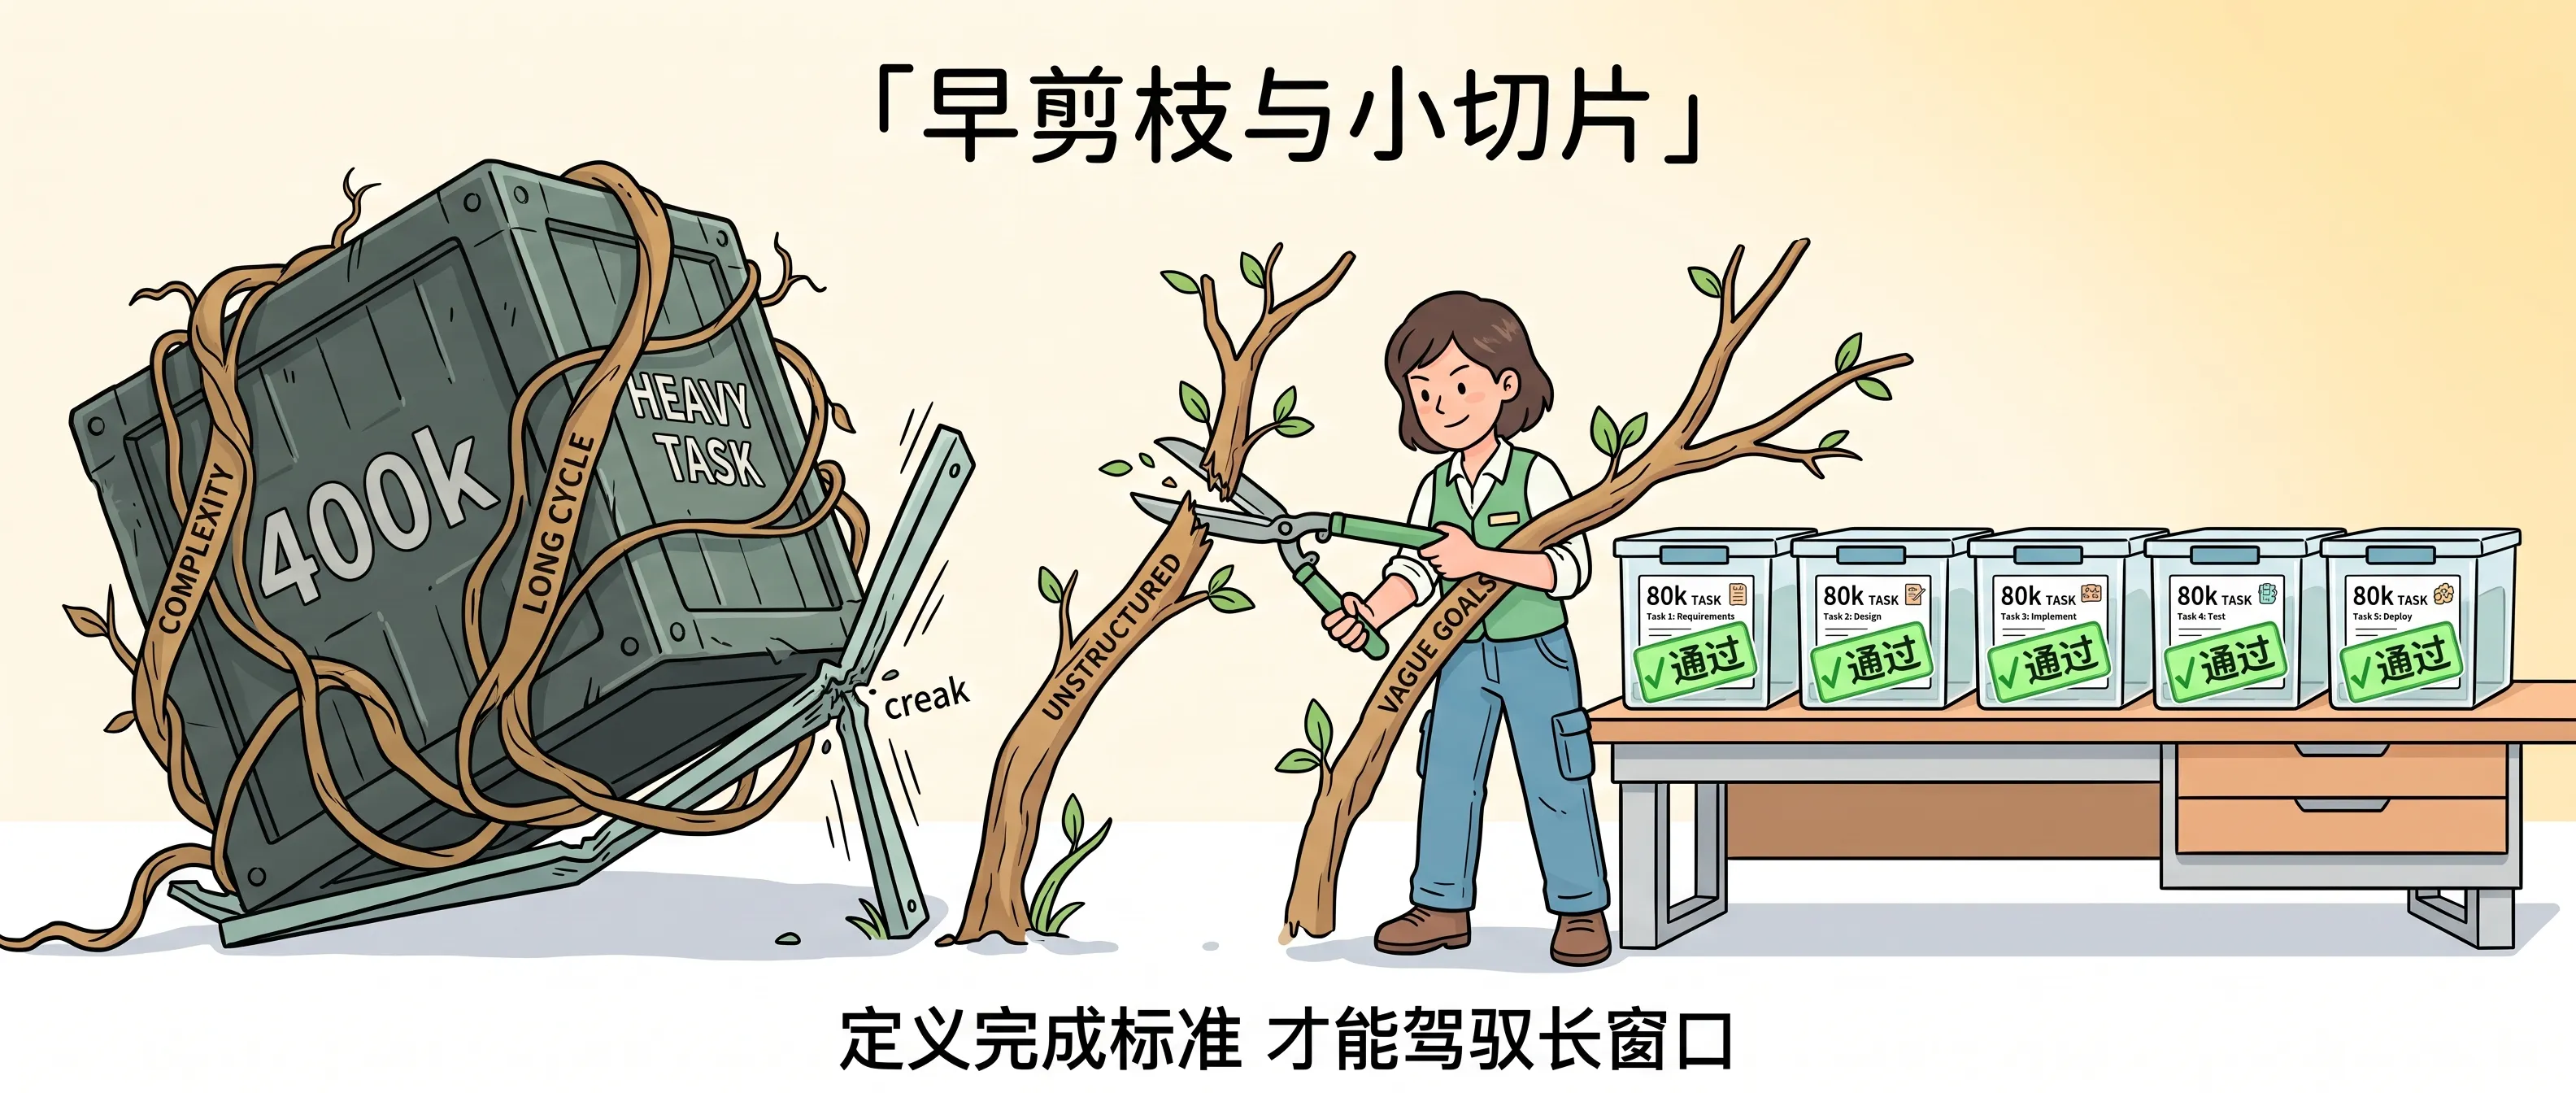
两轮不通过,即刻剪枝。
一旦发现模型在错误方向上滑出两步,果断掐断会话,不要等待它自我纠偏。窗口容量越大,它偏航的距离越远。
我的执行基准:连续两轮汇报的首行拿不出新的验证通过记录,立刻终止当前分支,清空上下文重新开局。
拆解任务切片,拒绝全量打包。
500k 的容量能吞下整个代码仓库,不代表必须把所有文件一股脑塞进去。
把一个 400k 的庞大会话,拆成五个 80k 的独立子任务。每个切片配置独立的验收边界和首行汇报。哪一部分脱轨,只回滚对应的单点分支,不污染全局环境。
这套逻辑对应团队管理:你不会把整间公司的历史档案甩给新员工让他看着办。分配具体事项、规定检验指标、划定交付时间,才是成事的路径。
Codex 这一步棋走得很准。对靠 Agent 搭建独立产品的开发者,月费里免除长上下文的计费顾虑,省去了日常算计的负担。
然而事情的底层逻辑没有改变:
便宜的是窗口容量,昂贵的是判断能力。
上下文从 272k 跃升至 500k,未来甚至扩展到 1M、2M,单价会一路走低,最终稀释为水和电一样的基础设施。持续保持昂贵的,是人在终端前做出的判断:代码有没有跑通、该不该按下停止键、下一步往哪个方向切分子任务。
吃下这波技术红利的人,不是无节制撑大窗口的人,而是懂得定义完成标准的人。
先写出验收标准,再打开上下文窗口。
相关阅读
- KV Cache:你用 ChatGPT 第一个字特别慢,原因就在这里
- 写了上百个 Prompt,终于搞懂 Transformer 了:给应用开发者的极简面试指南
- 同时开 5 个 Agent 之后,我让它们用飞机维修手册的语言给我汇报
- 一个月合入两千个 PR:SpaceXAI Lauren Tan 烧掉 1.5 万亿 Token 背后的验证工程
X 短帖:
Codex 上下文提到 500k 且订阅不加价。便宜的是窗口容量,昂贵的是交付判断。窗口变长,错误路径同步拉长。懂得定义完成标准、抓实运行证据的人,才能真正拿到这笔红利。 [文章链接待补]
 Mac 用户选 M5 Ultra 还是英伟达:开源驱动撕开裂缝,AI 逆向正在推倒闭源高墙