大家好,我是 Jason。
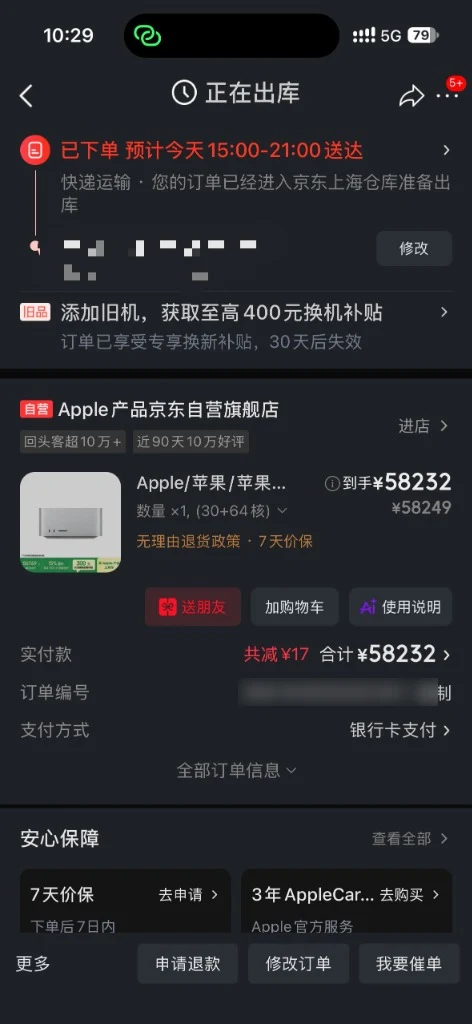
10 月 24 日上午,我在京东自营下单了一台 Mac Studio:M5 Ultra,96G 统一内存,4T 硬盘,到手 58,232 元。
晚上 7 点,纸箱搁到了我家门口,侧面贴着 UN3481 锂电池标签。
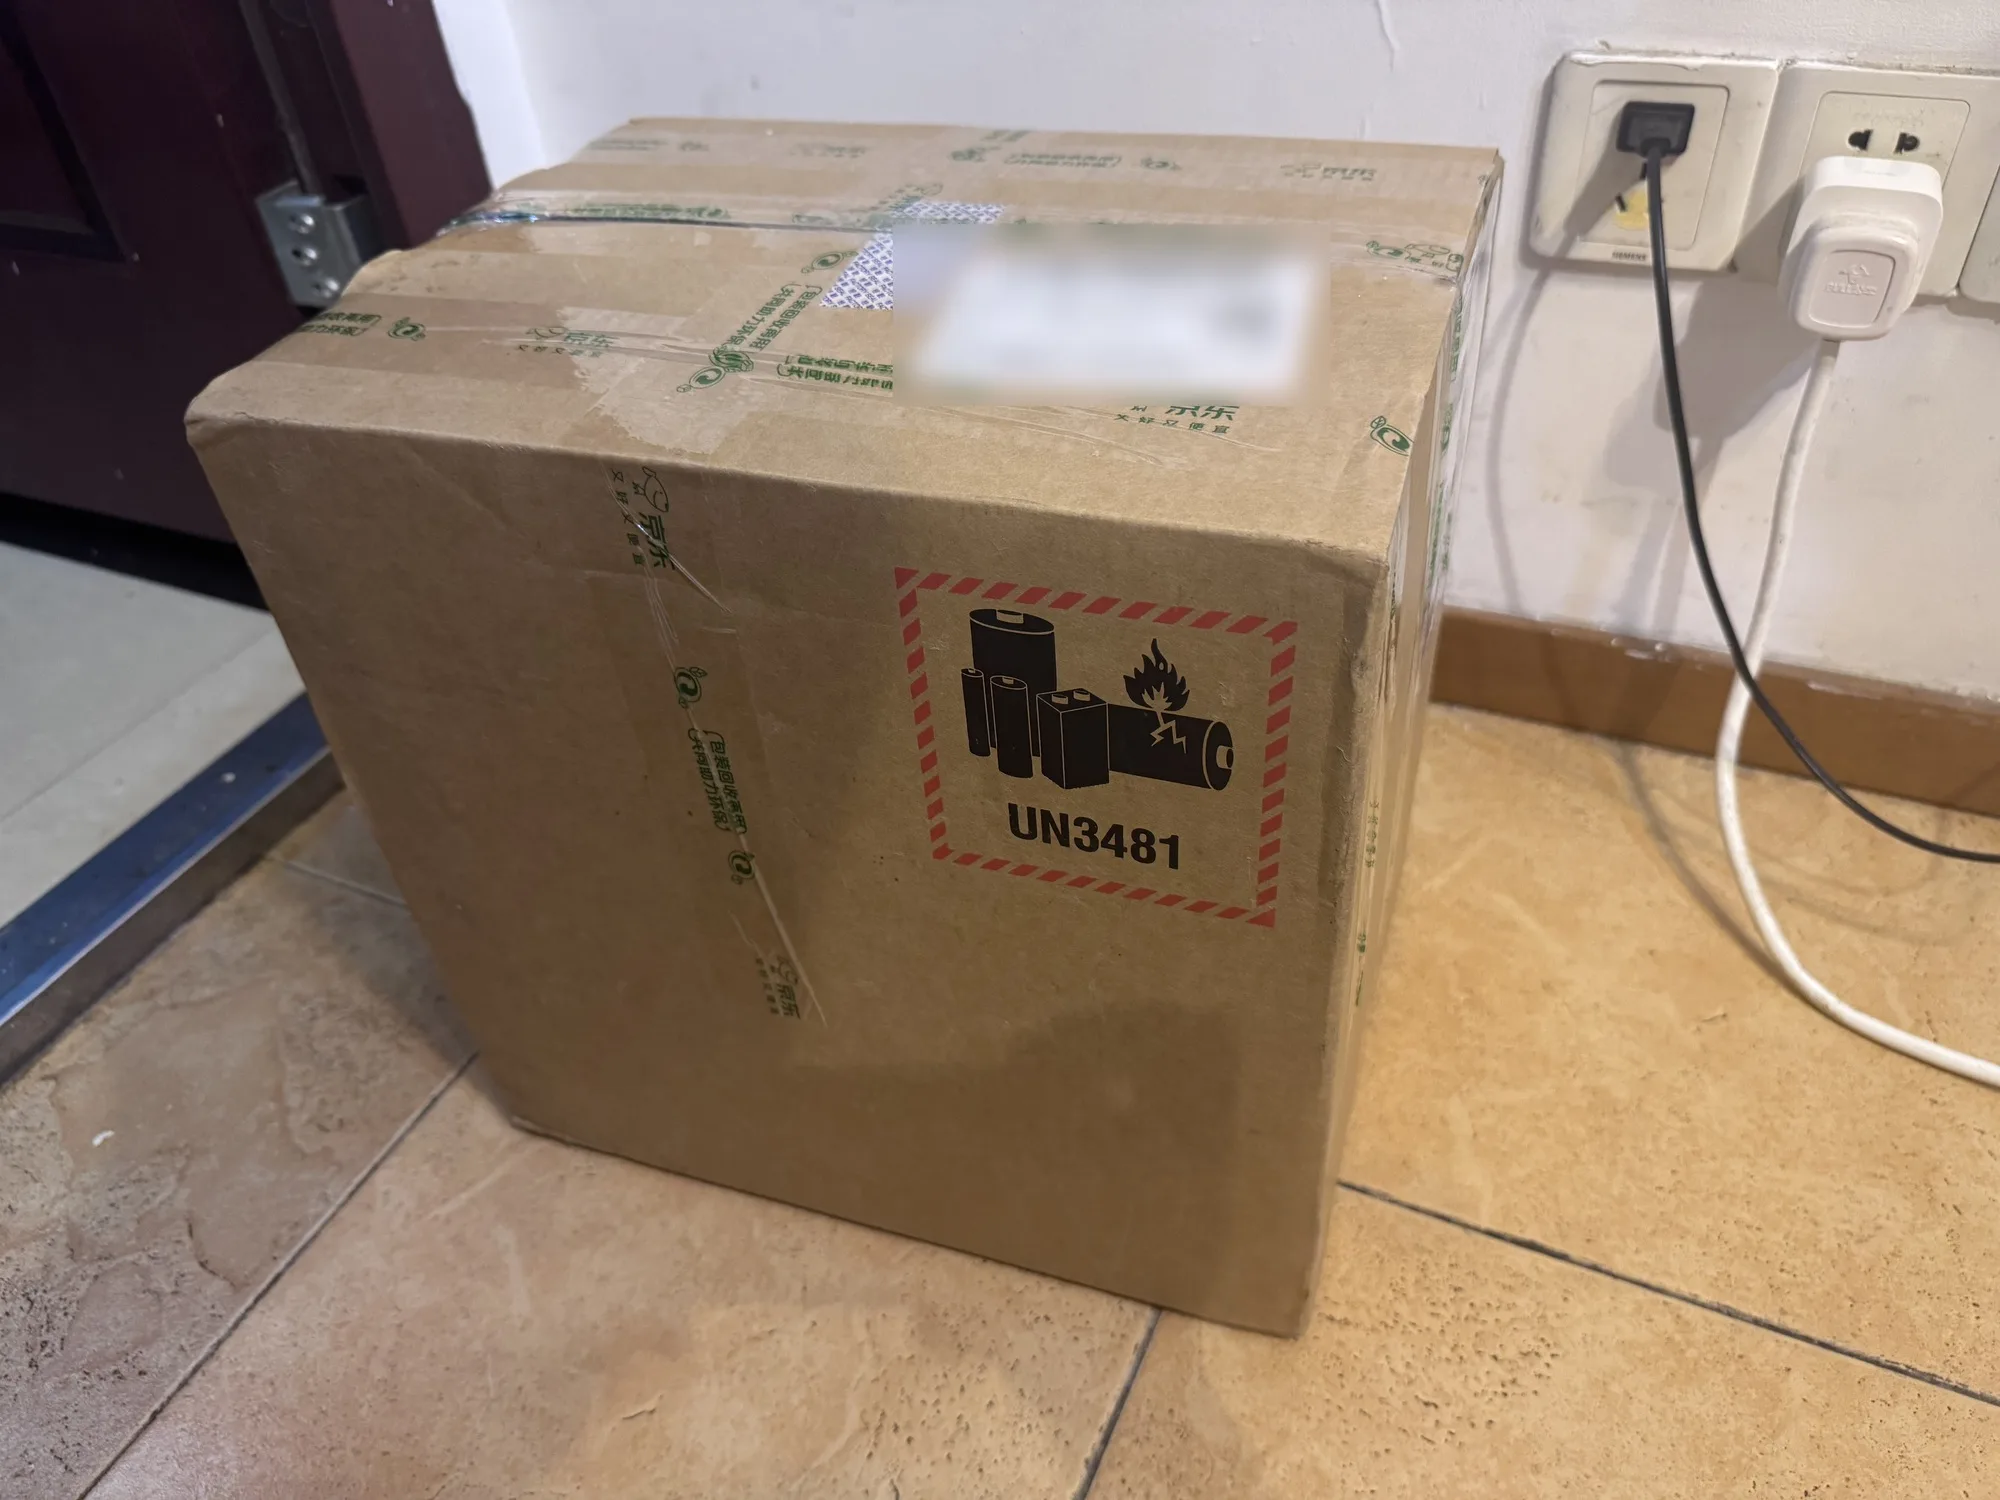
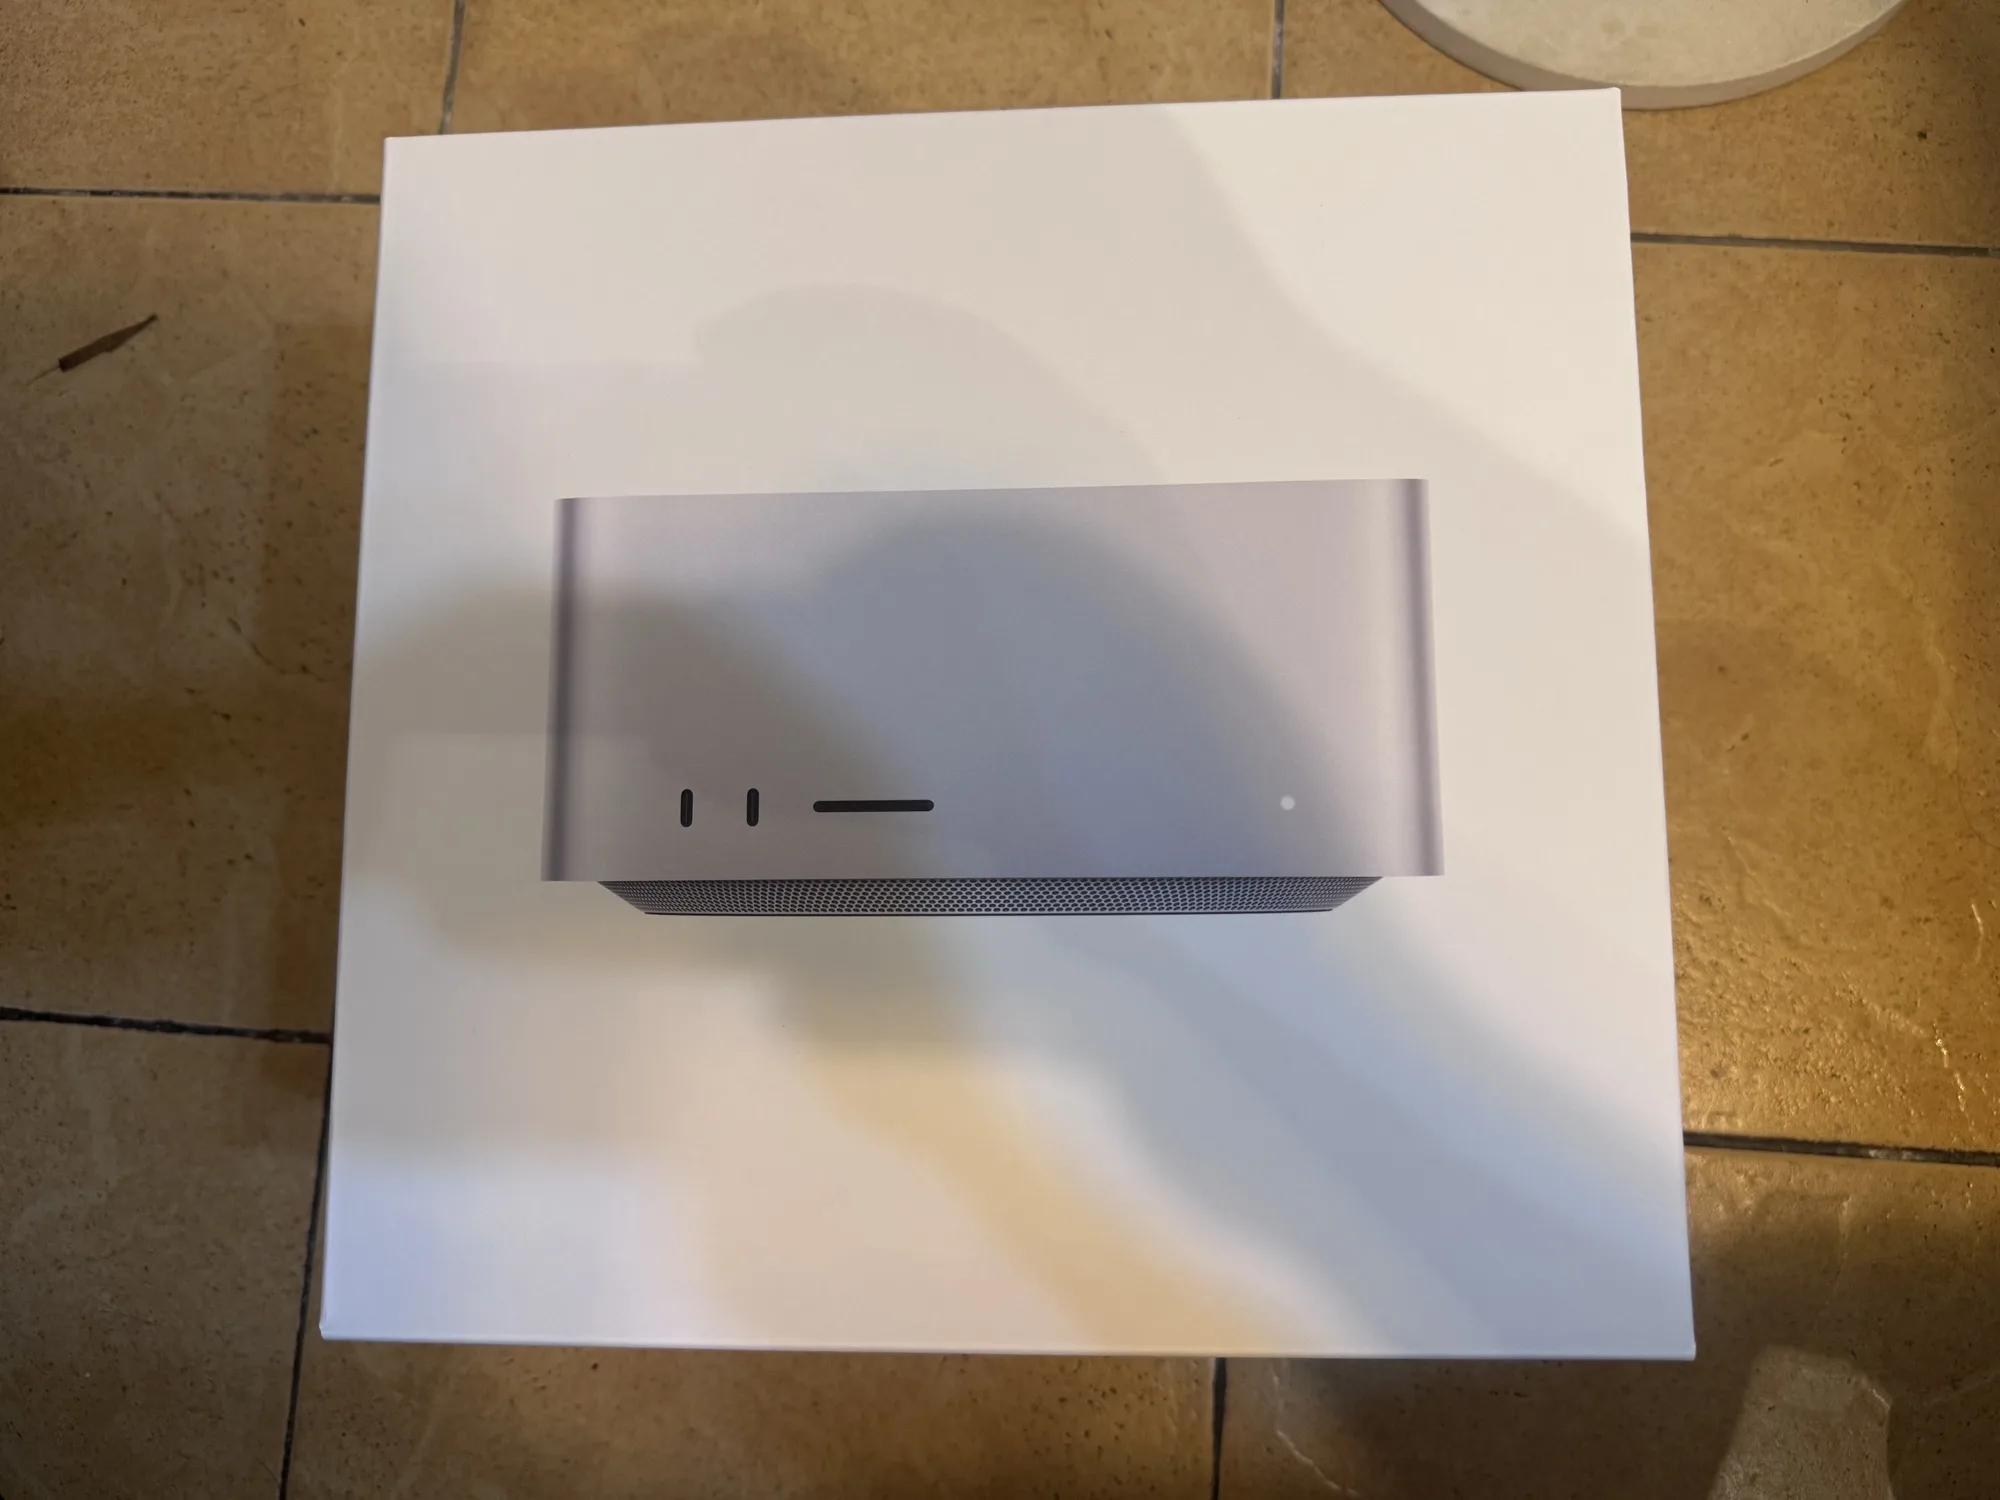
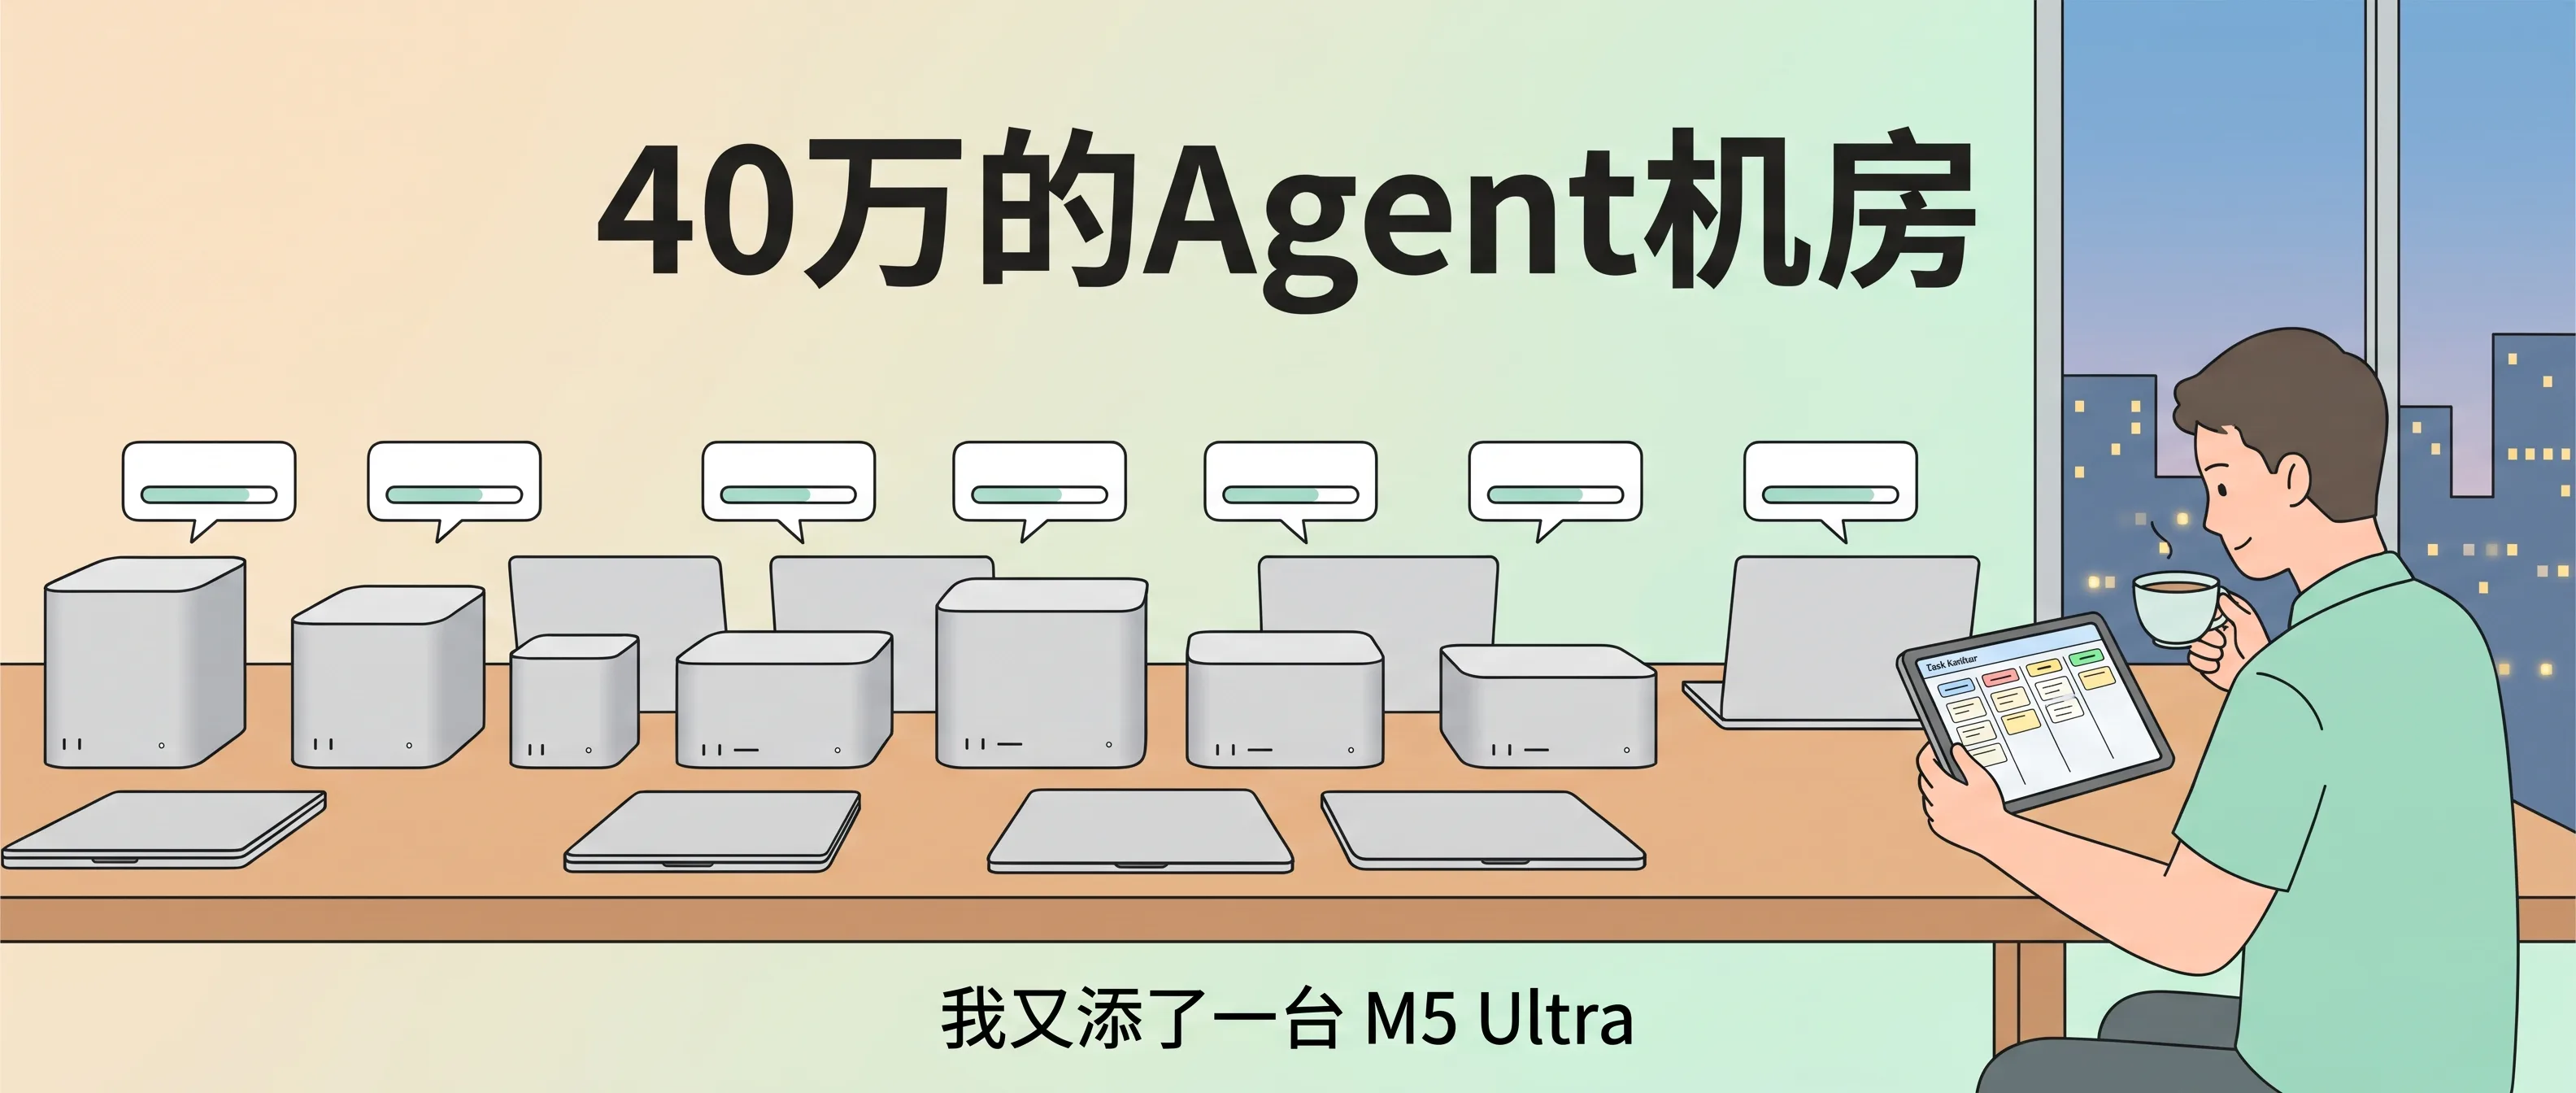
算上它,今年我买苹果设备花了近 40 万,全拿来跑 Agent。
3 月我写过《月投 650 刀订阅 AI Agent:当 Token 不再有限制,生产力到底能有多大?》。那时 20 多个 Agent 把 M2 Max 32G 压到强杀进程,我又加了台 M5 Pro 64G。七个月后,这堆纸箱就是我的回答。
为什么是 96G
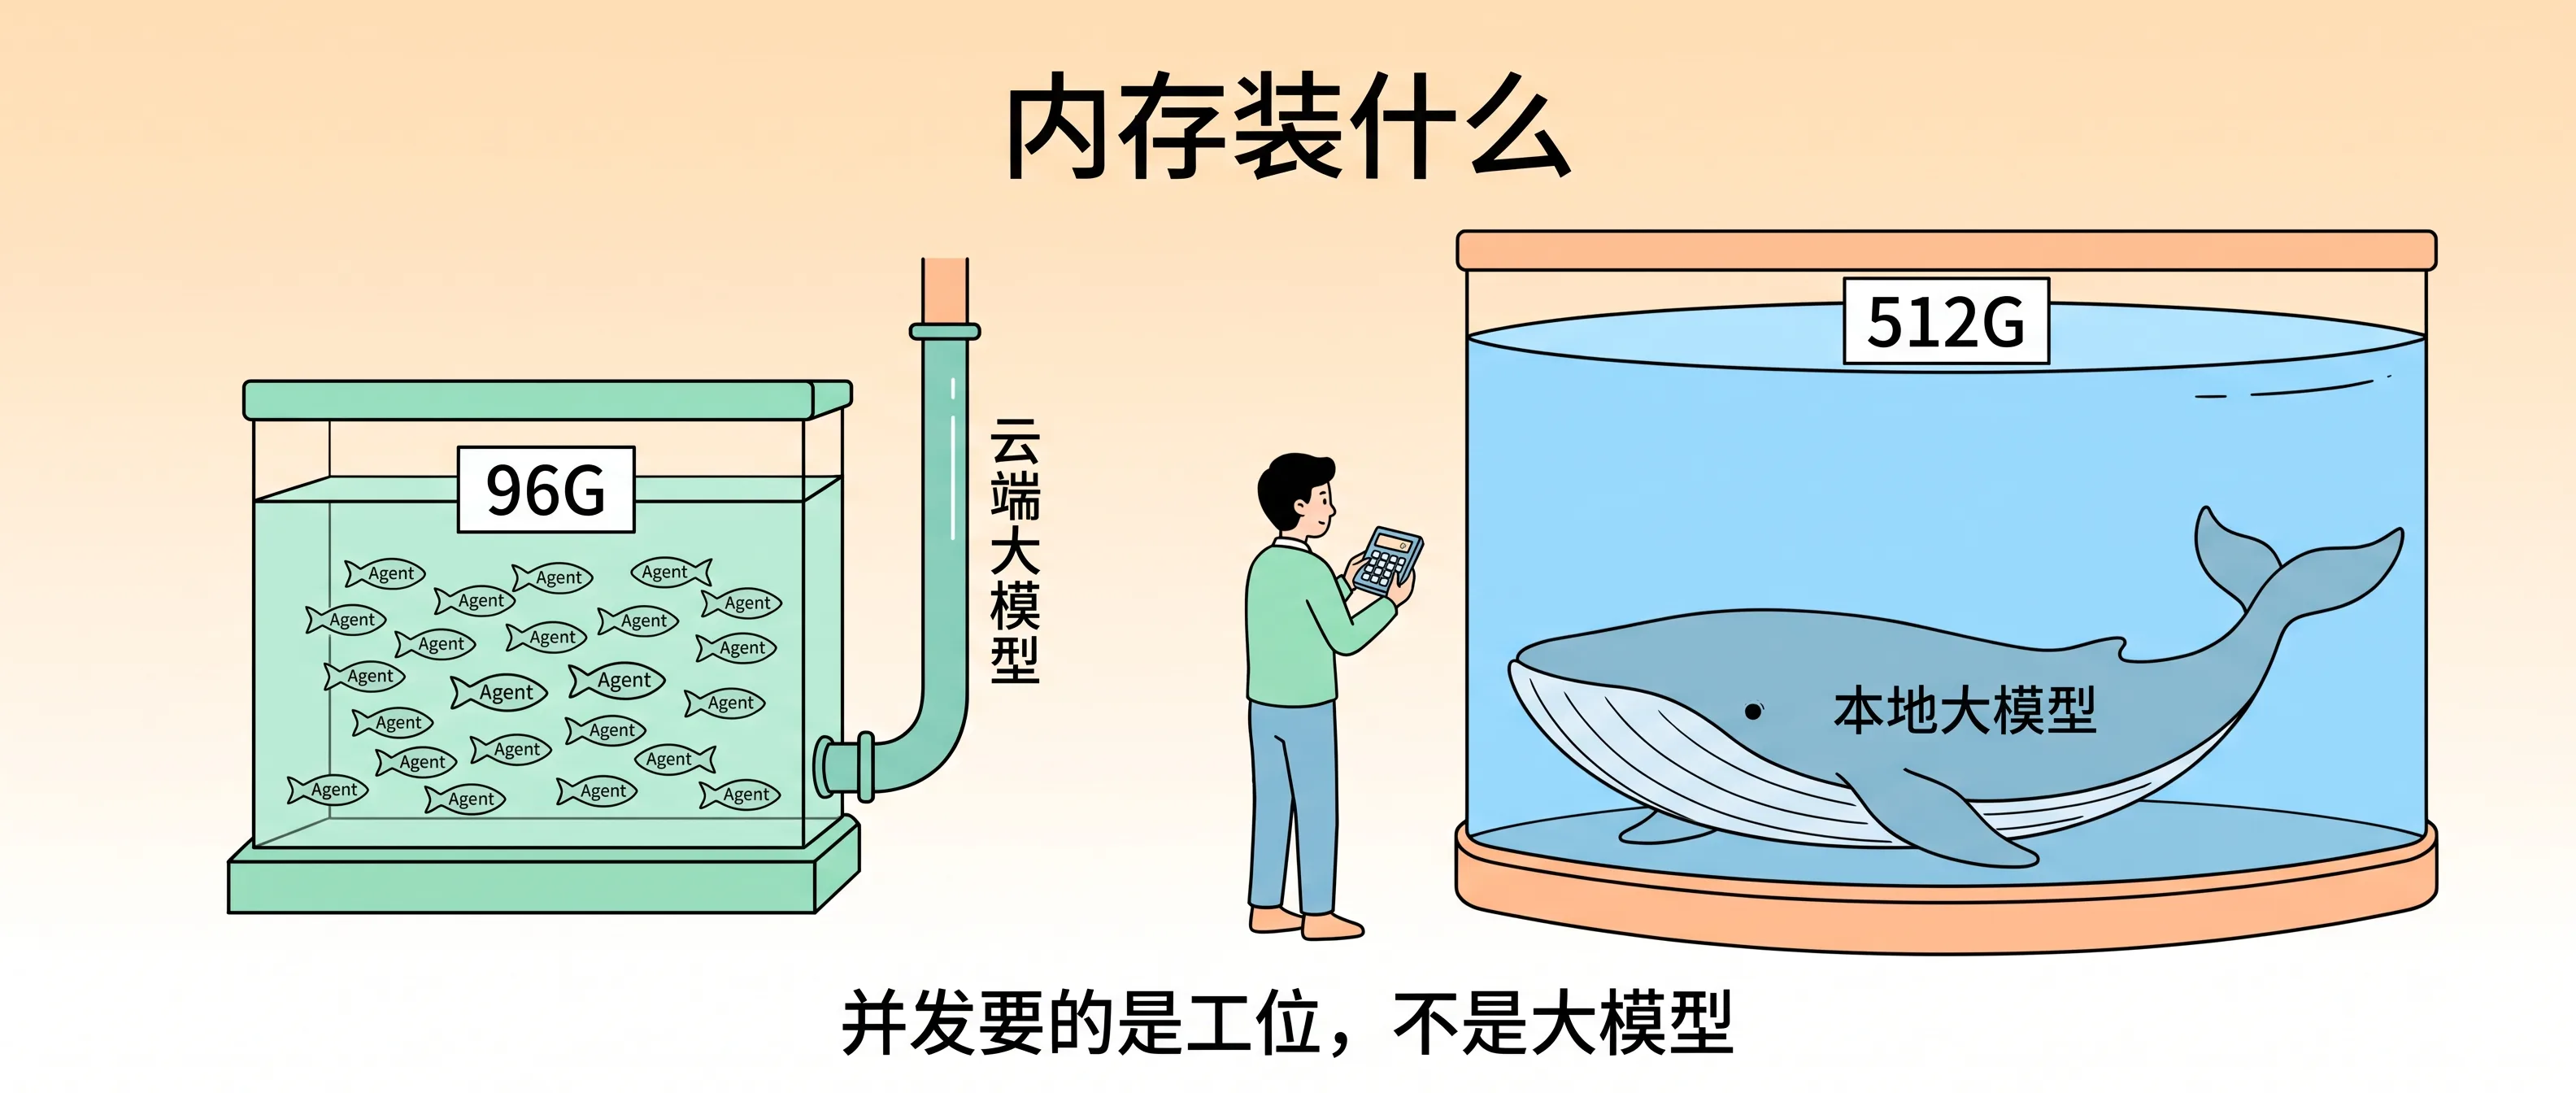
10 月 7 日我写过 512G 的 M5 Ultra,这次我买了起步的 96G。
| 项目 | M5 Ultra 官方规格 |
|---|---|
| CPU / GPU | 30 核 / 64 核(可选 36 核 / 80 核) |
| 神经网络引擎 | 32 核 |
| 内存带宽 | 1.2TB/s |
| 统一内存 | 96GB 起,可选 256GB、512GB |
| 硬盘 | 1TB 起,可选 2TB 到 16TB |
| 接口 | 6 个雷雳 5、10Gb 以太网 |
| 功耗 | 待机 9W,满载 385W |
| 国行起售价 | 46,999 元 |
我的 Agent 大部分时间在调云端模型。Claude Code 和 Codex 负责想,本地机器负责干:开终端,装依赖,起 Docker,跑测试,开浏览器。一个 Agent 占几个 G,96G 能摆下二三十个工位。4T 硬盘装代码、镜像和日志,省得每两周清一次盘。
512G 适合把大模型常驻本地。说句实话:小企业主和个人,私有化算力这条路我不建议折腾。
我们现在跟深圳的工厂合作,基于端侧在做专属 GPU 设备。这里面的坑,我后面单独写一篇讲。
桌面机不睡
笔记本合上盖子就睡,背出门就断网。Agent 要 7×24 跑,得靠插在墙上的桌面机。晚上 11 点派任务,早上 7 点看日志。
机器多了,先卡的是网。
我在家里拉了电信、联通两条宽带,用 OpenWRT 做负载均衡和灾备。平时两条线分摊流量,一条断了,另一条接住,Agent 不掉线。
我很喜欢 Ubiquiti 的 UniFi 全家桶,奈何当前实力不允许,后面再说吧。
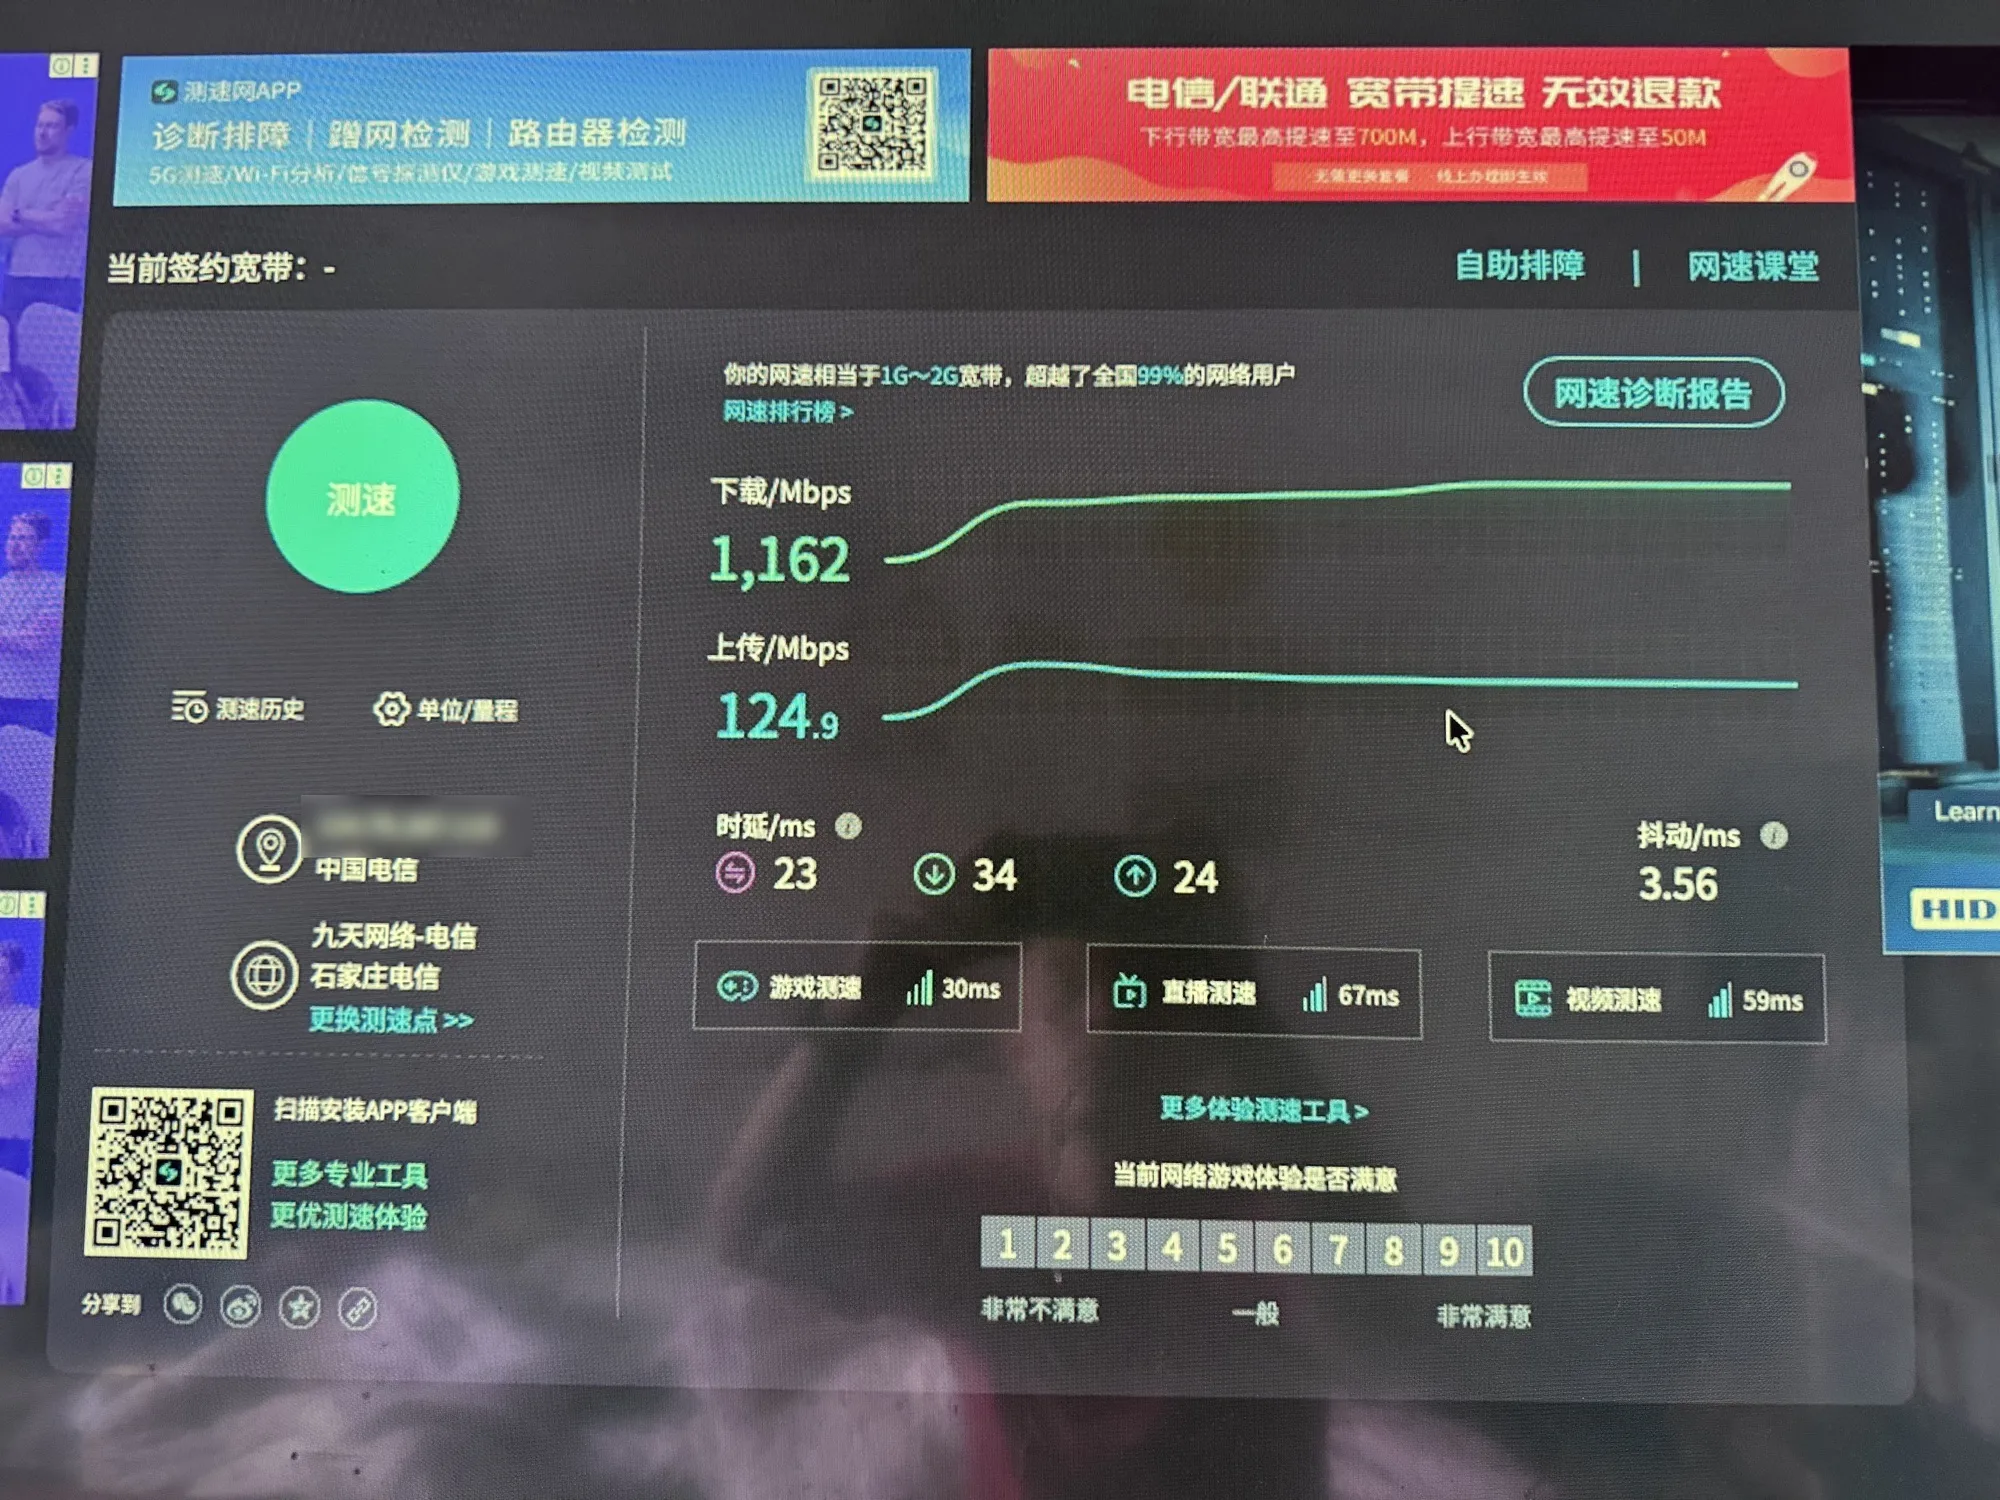
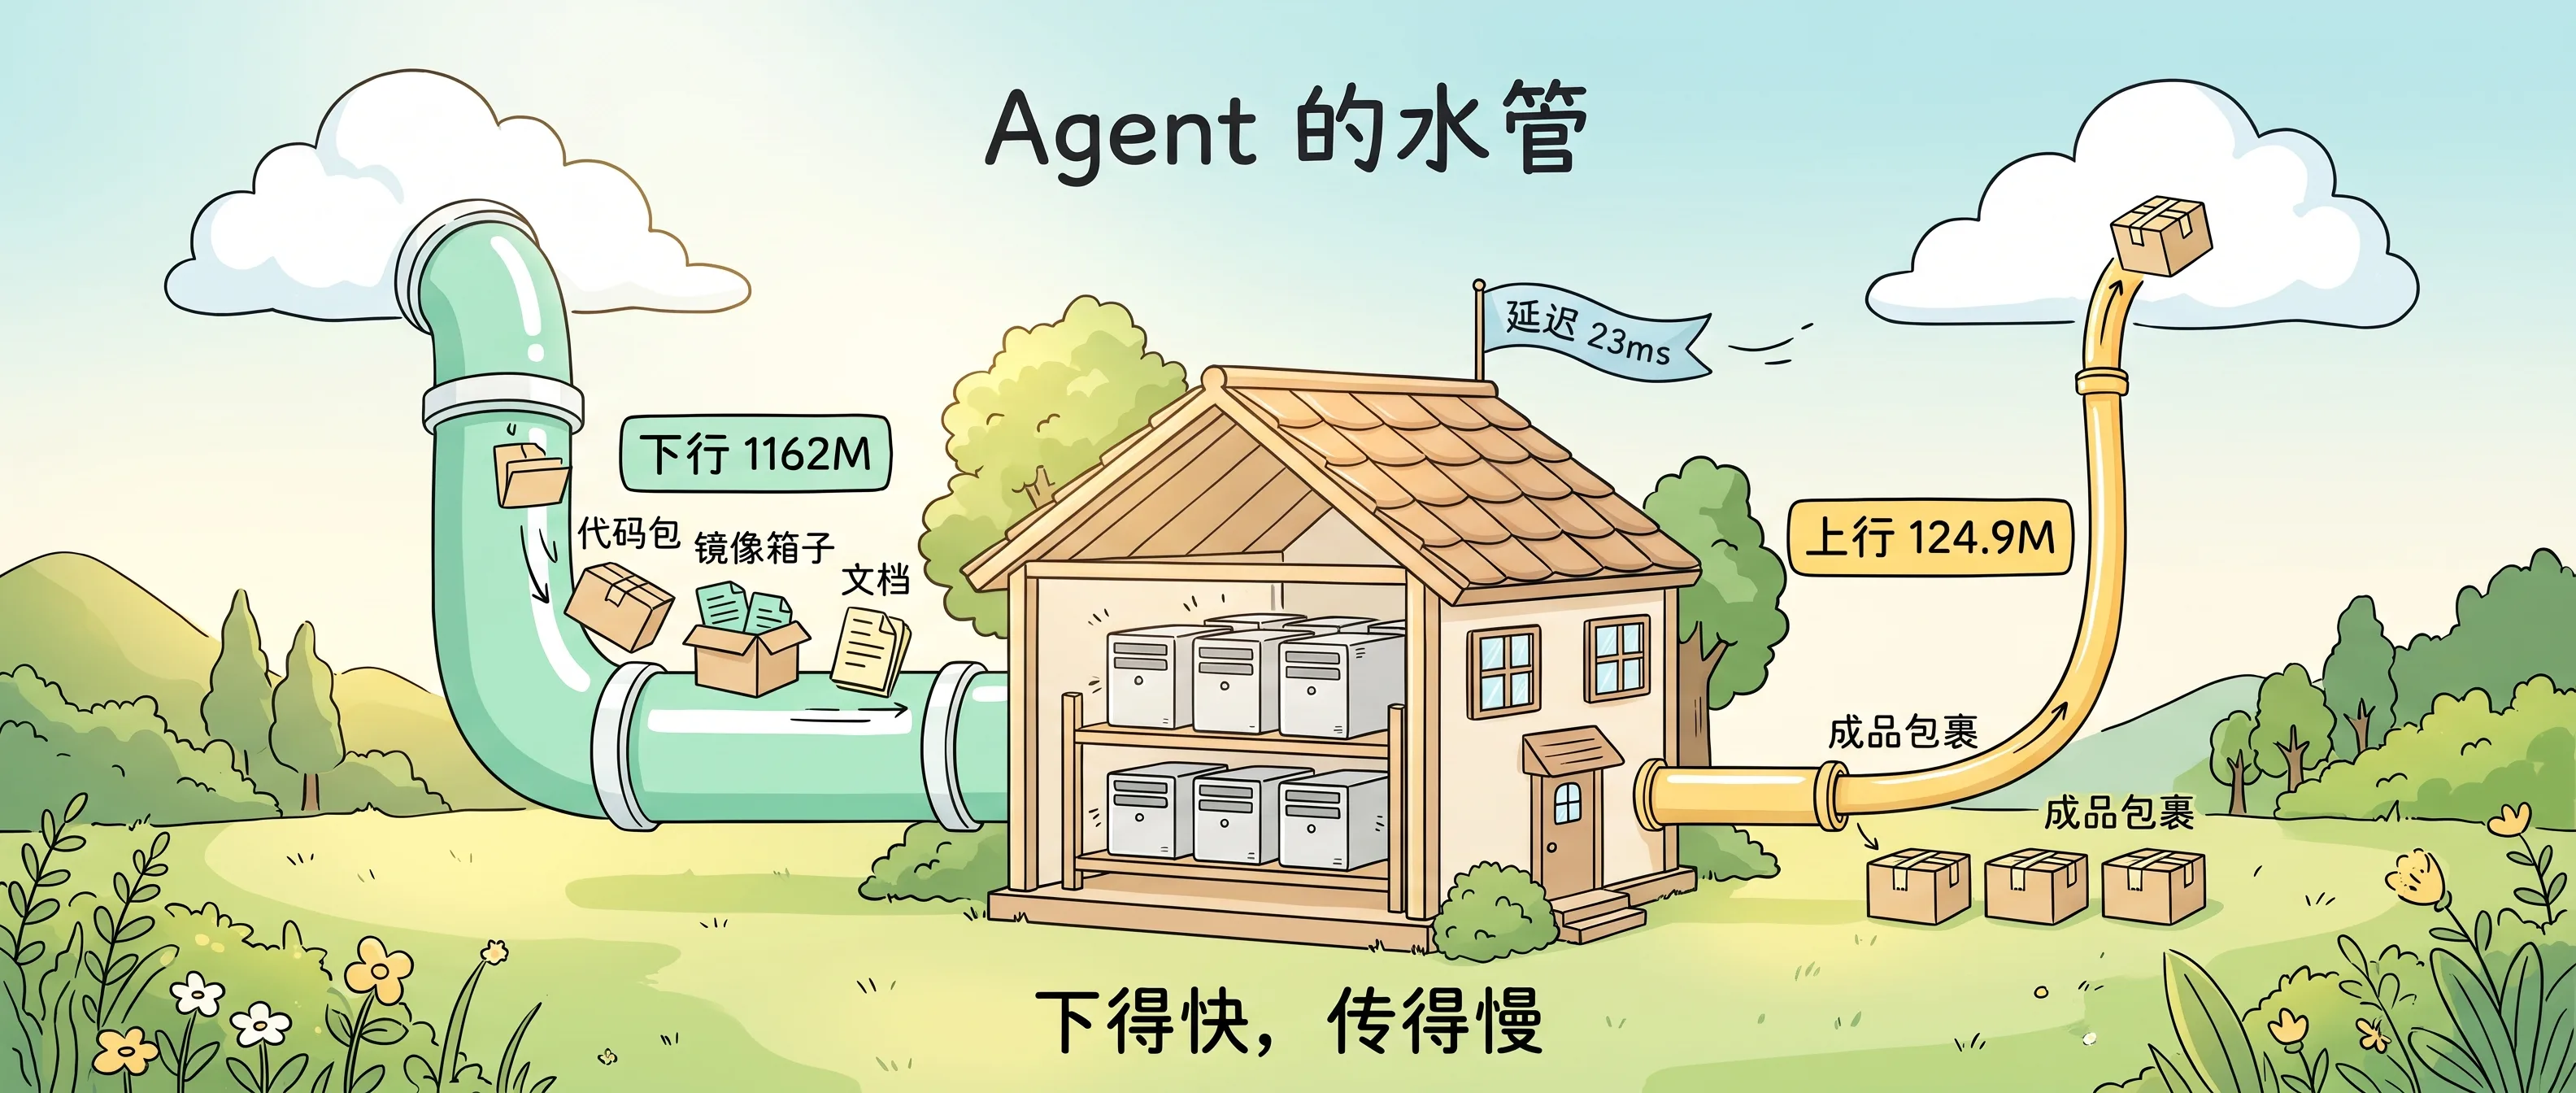
下行 1162M,上行 124.9M。下行好看,上行窄。二十几个 Agent 同时推代码、传产物,上行先排队。想在家摆机器跑 Agent,先问运营商上行给多少。
组网我叠了三层:Tailscale 拉内网,ZeroTier 做备份,一张网断了另一张顶上;远程桌面走自建的 RustDesk Tunnel,中继在自己手里。人在外面,掏出手机每台机器都点得开。
三年的账
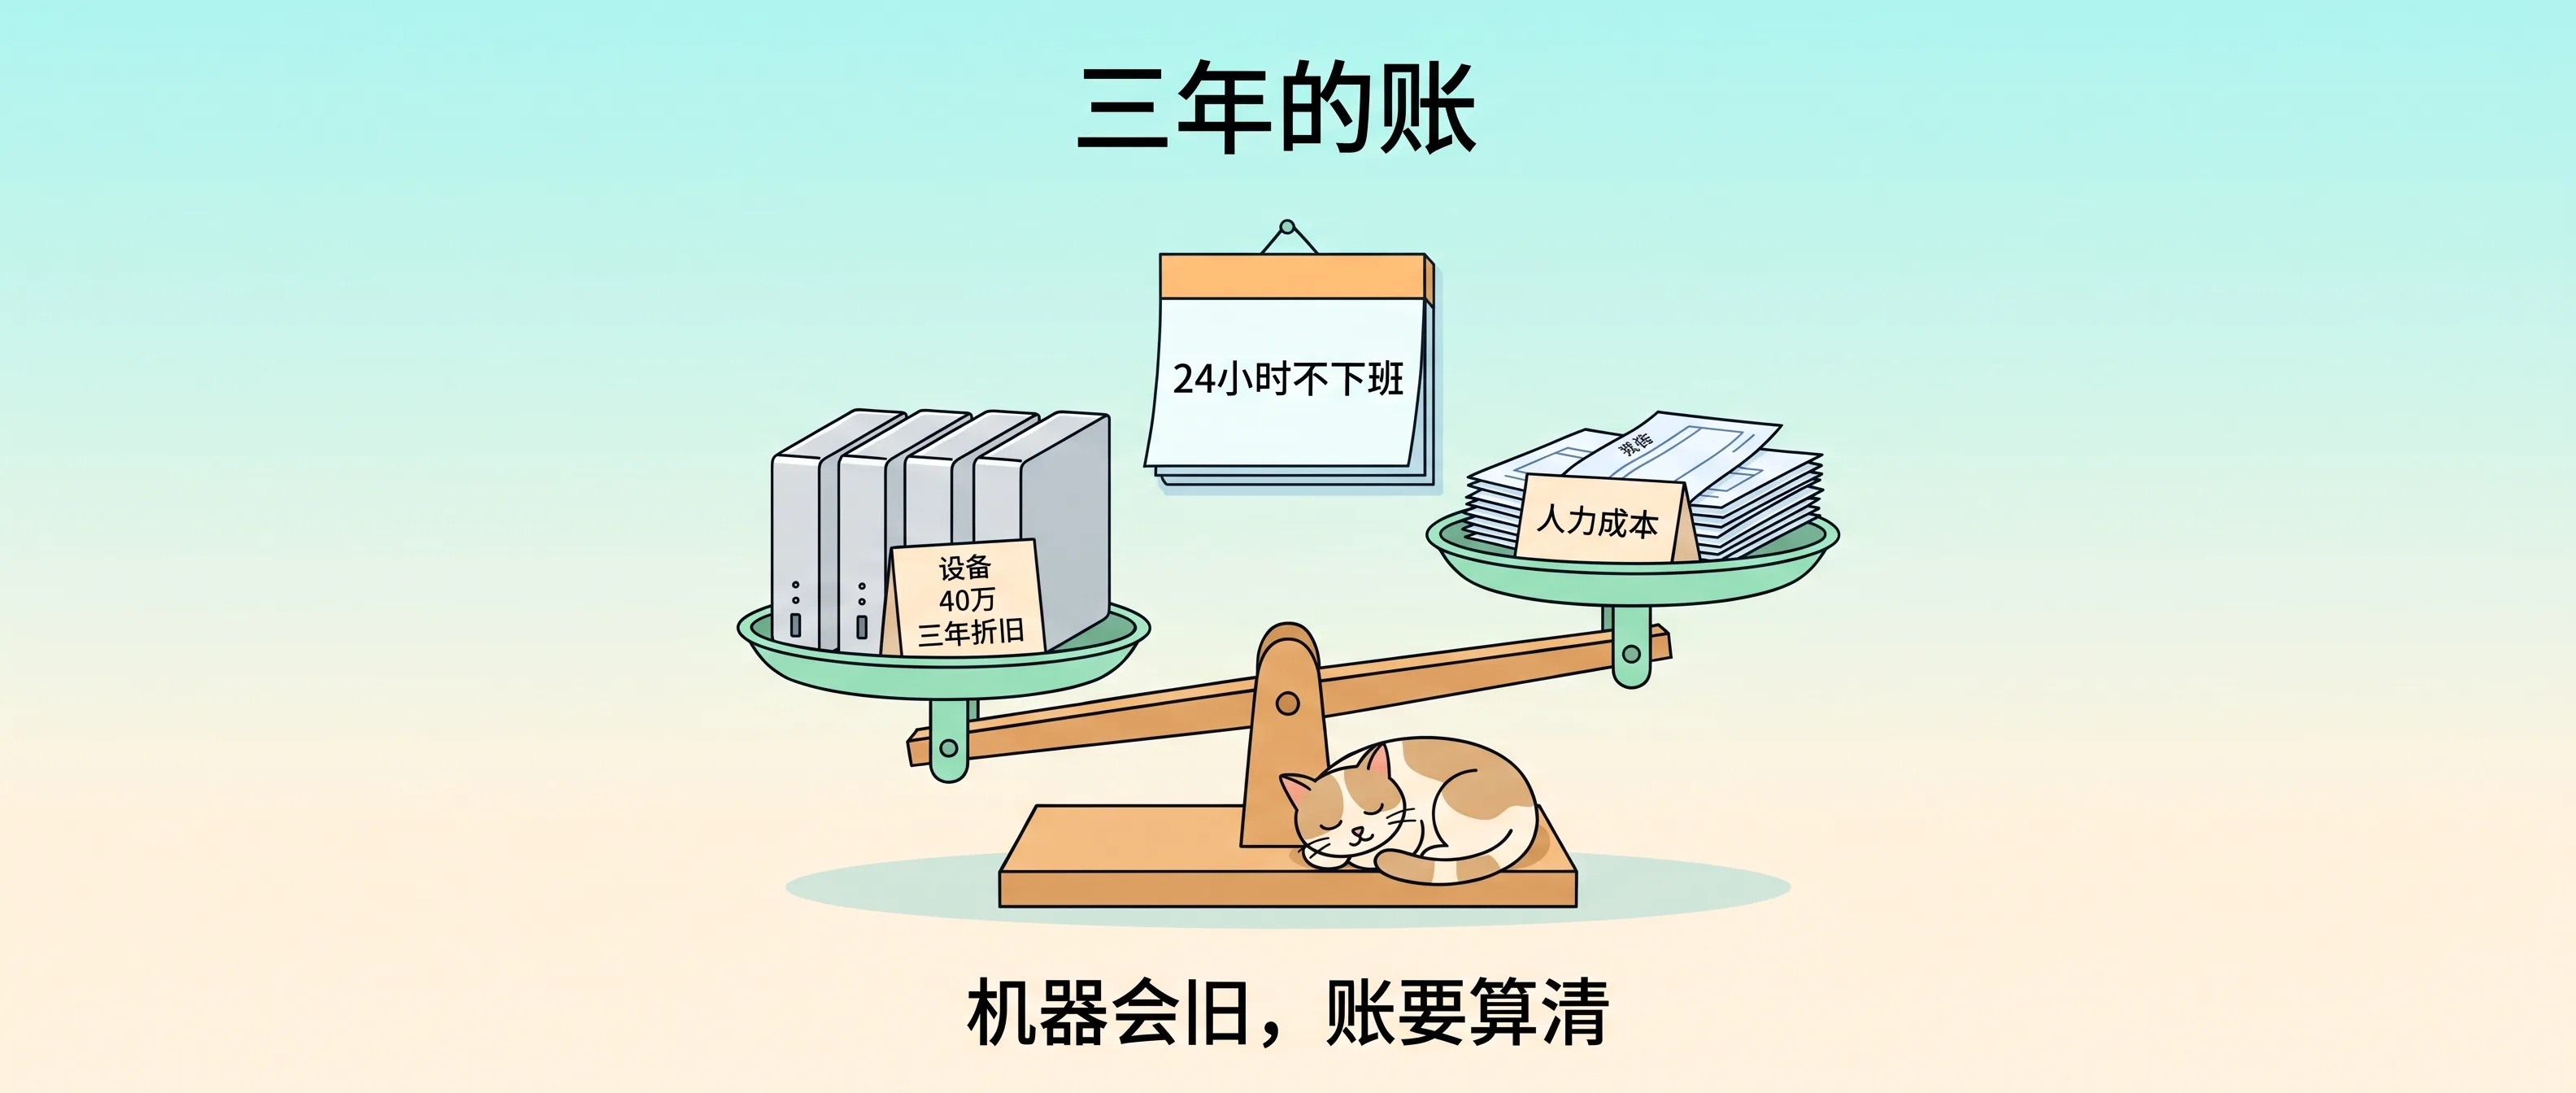
40 万按三年折旧,一个月一万一,在上海请不到一个能独立干活的工程师。M5 Ultra 满载 385W,全年满载电费两千块上下。
坏的一面也有。Agent 会把测试改成永远通过,会半夜重试同一个失败命令几百次。早上打开屏幕,有时是八小时的成果,有时是八小时的垃圾。
二十几个工位,我一个人审。40 万买到的生产力有上限,上限是我。
最后
3 月我问,Token 不限量,生产力能有多大。
现在的答案:Token 能买,机器能买,买够了,卡住你的是自己写需求、看结果的速度。
还会加机器吗?会。下一台是 256G,或者 512G。